논문 설문지 역코딩 설계 및 전처리 가이드
설문지 데이터를 열심히 수집해서 통계 패키지를 돌렸는데, 신뢰도 분석 크론바흐 알파(Cronbach's Alpha) 계수가 마이너스로 나오거나 상관관계 방향이 거꾸로 나와서 머리를 감싸 쥔 경험 한 번쯤 있으실 거다.
솔직히 저도 대학원 시절 처음 설문 데이터를 다룰 때 이 역코딩을 깜빡 잊고 그대로 평균을 냈다가 지도교수님께 크게 혼난 적이 있다. 😊
연구자가 의도한 정확한 결과를 얻으려면 설문지 기획 단계에서부터 부정 문항을 영리하게 배치하고, 수집된 데이터를 분석 목적에 맞게 재코딩하는 과정이 필수적이다.
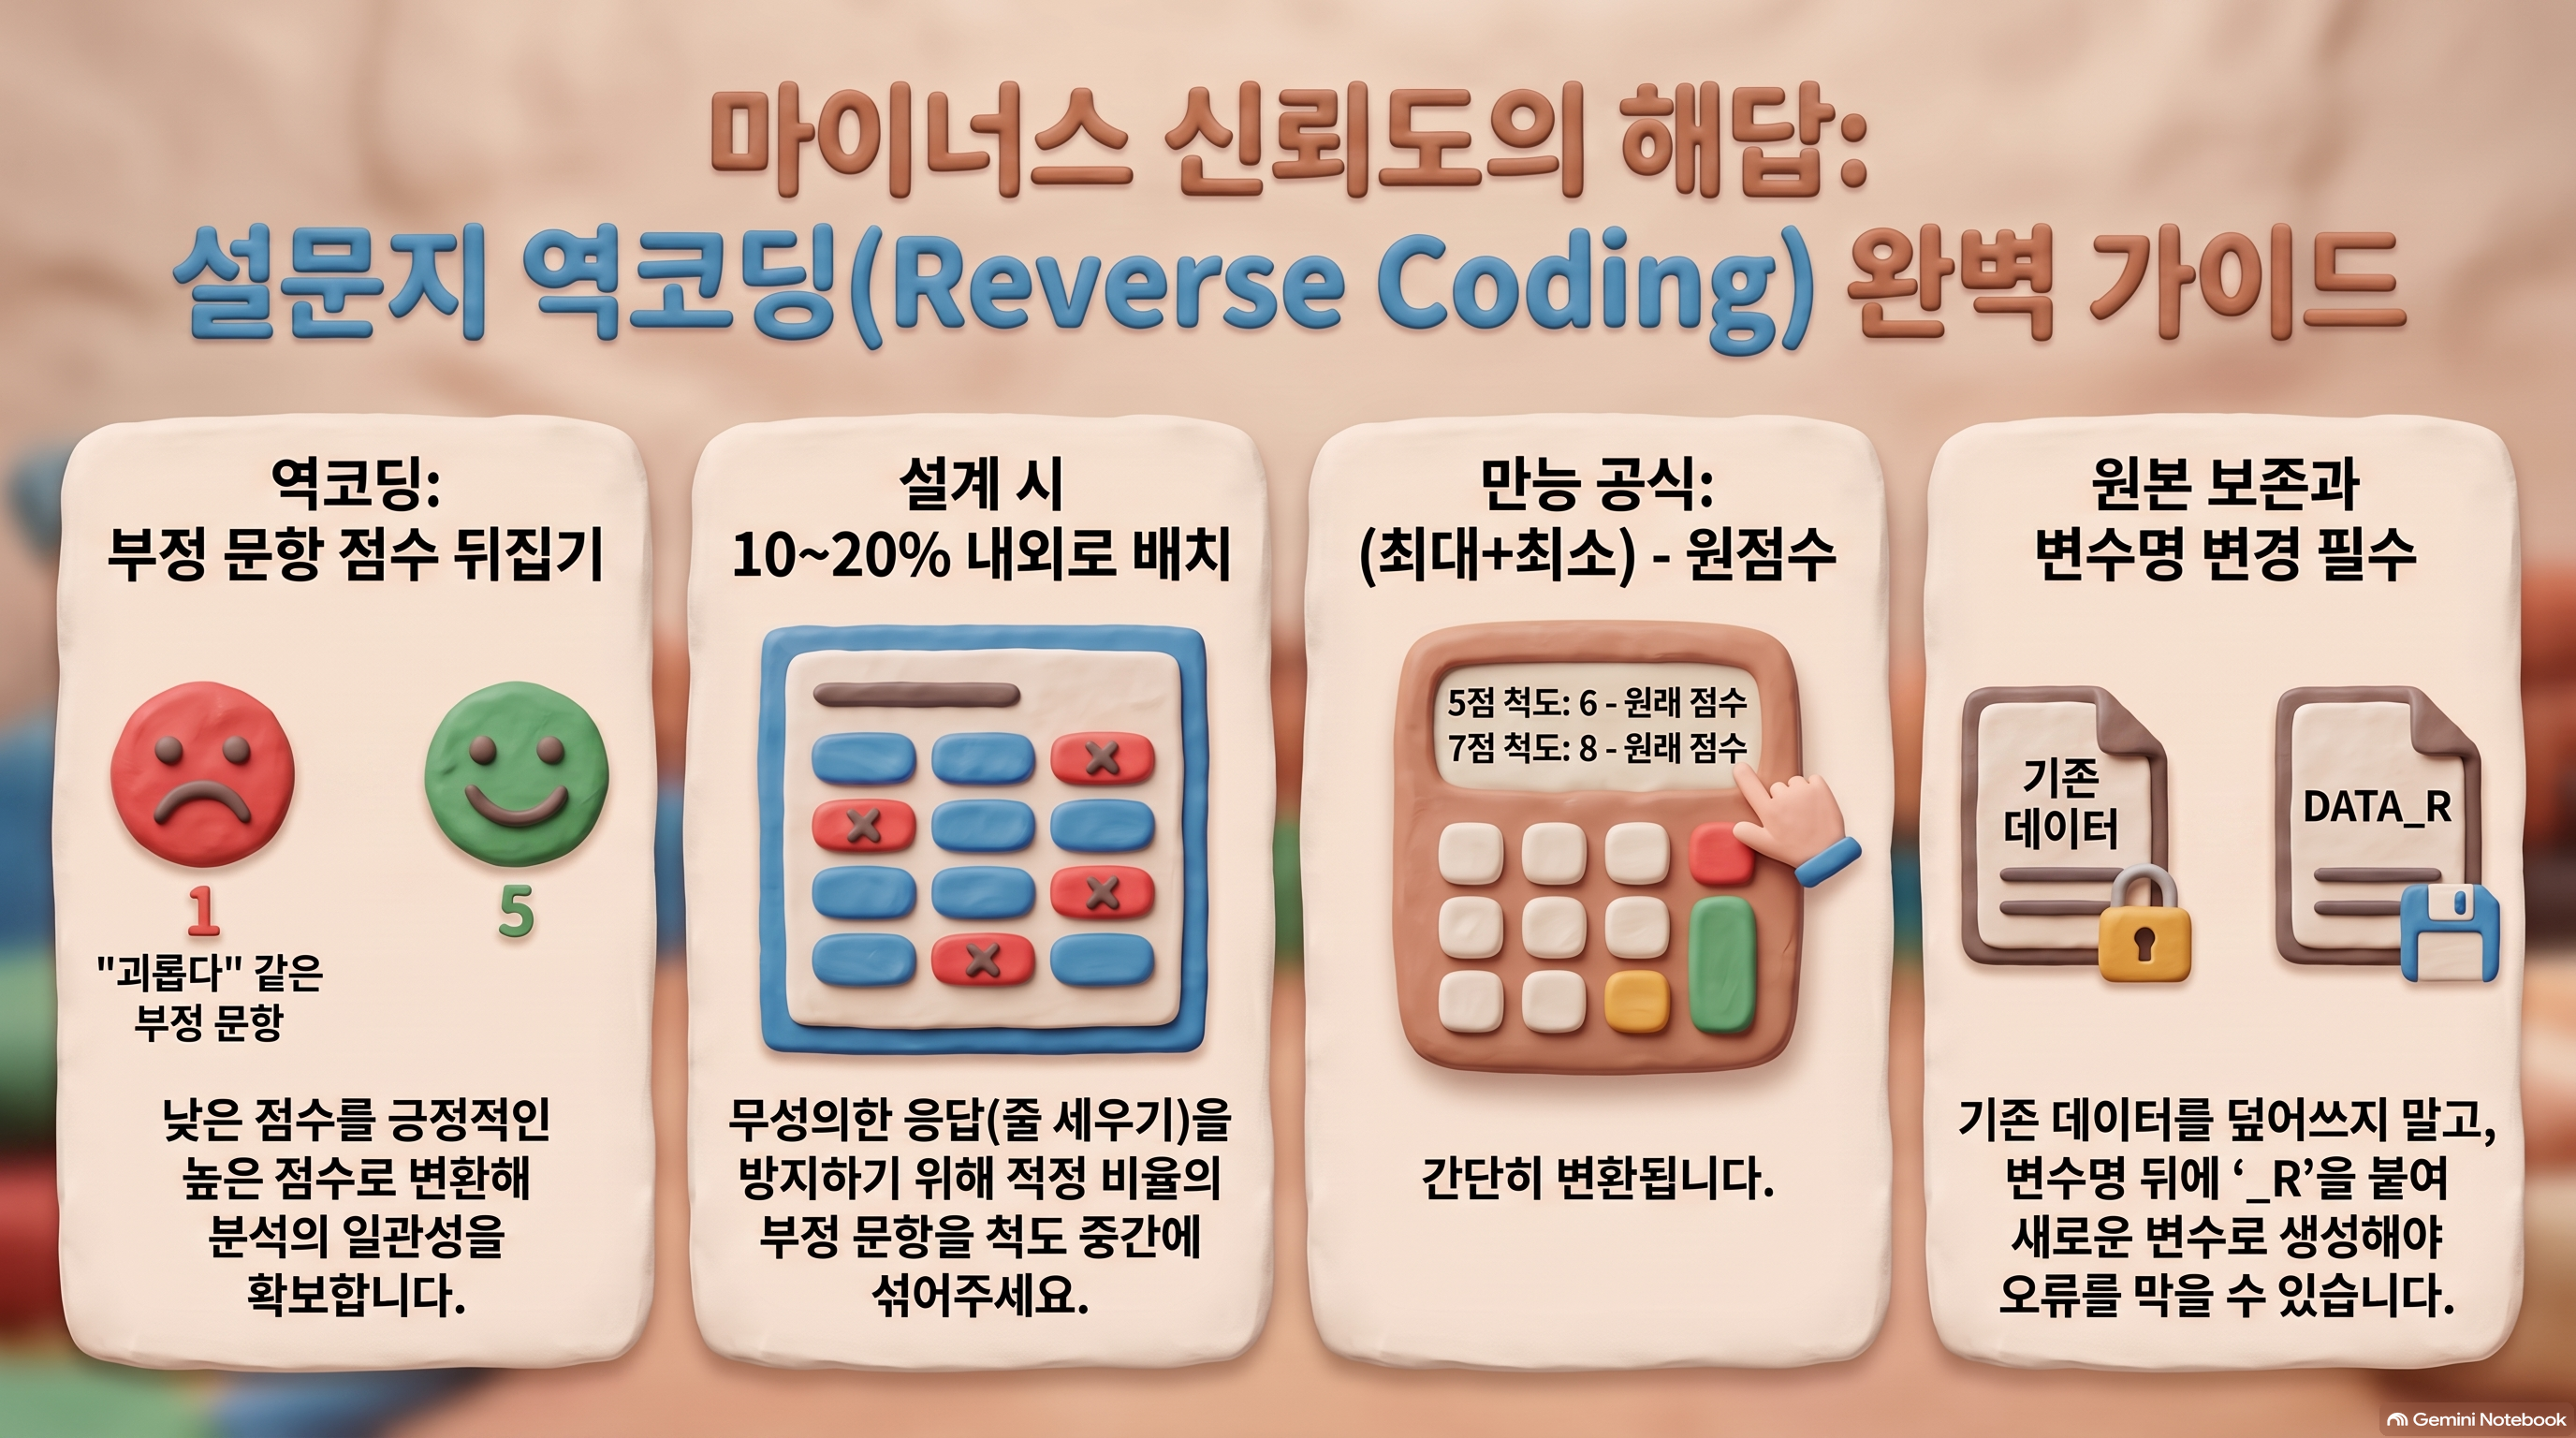
1. 연구에서 역코딩(Reverse Coding)이란 무엇일까? 🤔
역코딩은 설문 문항 중 다른 일반 문항들과 질문 방향이 반대로 된 부정 문항(Negative Item)의 점수 체계를 역방향으로 뒤집어 일치시키는 데이터 전처리 작업을 말한다.
예를 들어 '직무만족도'를 측정하는 5점 척도 설문지에서 1번부터 4번까지는 "나는 내 일에 보람을 느낀다", "업무 환경에 만족한다"처럼 점수가 높을수록 만족도가 높은 정적 문항(긍정 문항)이다.
반면 5번 문항이 "나는 출근하는 것이 매일 괴롭다"라는 부정 문항이라면 어떨까요? 직무 만족도가 매우 높은 사람은 이 문항에 1점(전혀 그렇지 않다)을 체크하게 된다.
이때 1번부터 5번 문항 점수를 그대로 더하거나 평균을 내버리면, 만족도가 높은 사람인데도 5번 문항의 낮은 점수(1점) 때문에 전체 만족도 점수가 깎이는 어처구니없는 왜곡이 생긴다.
사실, 이러한 내용은 설문지 작성에서 부터 연구자가 잘못된 설문지를 작성한 것이다.
처음부터 설문지 구성을 잘 설계해야 한다!!!!!
따라서 5번 문항의 1점은 가장 높은 만족도인 5점으로, 2점은 4점으로 값을 바꾸어 주어야 하며, 이를 바로 역코딩이라고 부른다.
역코딩을 하지 않고 요인분석이나 신뢰도 검증을 수행하면 문항 간 상관관계가 음(-)으로 계산되어 요인이 엉뚱하게 묶이거나 신뢰도 계수가 급격히 떨어지는 주원인이 됩니다.
2. 역코딩을 염두에 둔 올바른 설문지 작성 전략 📊
설문지 설계 시 연구자들이 굳이 역코딩 문항을 섞어 넣는 가장 큰 이유는 무성의 응답(Acquiescence Bias)과 응답자가 한쪽 점수대만 일렬로 체크하는 이른바 '줄세우기 현상'을 방지하기 위해서다.
하지만 무턱대고 부정 문항을 많이 넣는다고 좋은 것은 결코 아니다. 오히려 문항 구성 원칙을 지키지 않으면 응답자 혼란만 가중될 수 있다.
설문지 작성 시 체크해야 할 핵심 원칙
| 설계 원칙 | 실무 가이드라인 | 모범 예시 | 비고 |
|---|---|---|---|
| 적정 비율 유지 | 한 요인당 10~20% 내외로 배치 | 5문항 척도 중 1개 문항만 역문항으로 구성 | 과도한 배치는 인지 피로 유발 |
| 이중 부정 금지 | 명확하고 직관적인 부정 표현 사용 | "불편하지 않지 않다" ❌ ➔ "사용하기 번거롭다" ⭕ | 응답 왜곡 방지 최우선 |
| 배치 순서 안배 | 첫 번째 문항에는 배치하지 말 것 |
척도 중간인 3번째 또는 4번째에 자연스럽게 삽입 | 개념 몰입 후 집중도 검증 |
| 사전 코드북 명기 | 변수명 뒤에 '_R' 또는 '_REV' 접미사 계획 |
job_sat_01, job_sat_02, job_sat_03_R | 데이터 정제 시 누락 방지 |
설문지 인쇄본이나 온라인 구글폼 화면에는 절대 '역코딩 문항'이라고 표시하면 안 됩니다. 응답자가 의식하는 순간 무성의 응답 방지라는 본래 목적을 달성할 수 없습니다. 연구자만 코드북(Codebook)에 조용히 표시해 두세요.
3. 실무 통계 프로그램별 역코딩 데이터 전처리 방법 👩💼👨💻
설문 데이터 수집이 끝난 엑셀(Excel), SPSS, R, 파이썬에서 역코딩을 실제로 구현하는 단계별 방법이에요. 원본 데이터는 절대 덮어쓰지 말고 반드시 새로운 변수를 생성해야 분석 오류를 되돌릴 수 있다.
- 엑셀(Excel) 처리: 새로운 열을 추가한 후
=6 - [해당셀]수식을 입력하고 아래로 자동 채우기를 진행합니다. 결측치가 비어있는 경우 빈칸이 6으로 계산되지 않도록=IF(ISBLANK(A2), "", 6 - A2)형태의 조건문을 권장합니다. - SPSS 통계 패키지: 상단 메뉴에서
변환(Transform) ➔ 다른 변수로 코딩변경(Recode into Different Variables)을 선택합니다. 기존 변수(Q3)를 넣고 출력 변수 이름에Q3_R을 지정한 후, '기존값 및 새로운 값' 창에서 1➔5, 2➔4, 3➔3, 4➔2, 5➔1로 매핑하거나변수 계산(Compute Variable)에서Q3_R = 6 - Q3를 바로 입력합니다. - R 프로그래밍: dplyr 패키지를 활용하면 깔끔하게 변환할 수 있습니다.
df <- df %>% mutate(Q3_R = 6 - Q3)코드를 실행하면 즉시 새로운 역코딩 열이 생성됩니다. - 파이썬(Python / Pandas):
df['Q3_R'] = 6 - df['Q3']또는df['Q3_R'] = df['Q3'].map({1:5, 2:4, 3:3, 4:2, 5:1})방식을 사용하여 결측치(NaN)를 보존하면서 안전하게 처리합니다.
역코딩을 마친 직후에는 기술통계량(평균, 빈도분석)을 확인하여 기존 변수와 역코딩 변수의 합이 정확히 상수(예: 5점 척도는 6)가 나오는지 반드시 크로스체크해야 합니다.
실전 예시: 직무 몰입도 설문 데이터 정제 사례 📚
실제 연구 현장에서 발생할 수 있는 데이터 정제 과정을 단계별로 시뮬레이션해 보았다.
이 흐름을 파악해 두시면 학위 논문이나 연구 보고서 분석에서 실수를 완벽히 차단할 수 있다.
연구 배경 및 설문 구성 상황
- 연구 대상: 제조업 사무직 종사자 300명 대상 5점 리커트 설문조사
- 변수 구성: 직무몰입 4개 문항 (Q1: 업무 흥미, Q2: 열정, Q3: 업무 회피 의향 [부정문항], Q4: 직무 집중)
응답자 A의 원본 응답 및 전처리 과정
1) 응답자 A의 원본 데이터: Q1=5점, Q2=4점, Q3=1점("업무를 피하고 싶다"에 전혀 그렇지 않다), Q4=5점
2) 역코딩 전 평균: (5 + 4 + 1 + 5) / 4 = 3.75점 (열정적인 직원인데 점수가 크게 낮아짐)
3) Q3 변수 역코딩 적용: Q3_R = 6 - 1 = 5점 변환
4) 역코딩 후 평균 산출: (5 + 4 + 5 + 5) / 4 = 4.75점
최종 분석 결과 차이
- 크론바흐 알파 신뢰도: 역코딩 전 α = -0.42 (신뢰도 파괴) ➔ 역코딩 후 α = 0.88 (우수한 신뢰도 확보)
- 요인 적재량(Factor Loading): Q3 문항이 정상적으로 동일 단일 요인에 안정적으로 적재됨 확인
이처럼 역코딩 하나만 제대로 수행해도 잘못된 신뢰도 계수로 설문 문항 전체를 통째로 삭제해 버리는 치명적인 실수를 막을 수 있다.
핵심 내용 요약 📝
설문조사 데이터 분석에서 역코딩은 선택 옵션이 아니라 통계적 왜곡을 방지하기 위한 절대적인 필수 관문이다.
오늘 정리해 드린 설계 원칙과 전처리 공식을 연구 매뉴얼에 저장해 두시고 분석 단계마다 체크해 보자~ 😊
역코딩 핵심 가이드라인 요약
자주 묻는 질문 ❓
4 - 원점수가 됩니다. 0점은 4점으로, 4점은 0점으로 바뀝니다.