논문 작성에 AI 썼다고? 연구모형 설계와 AI 올바른 활용법
요즘 연구실이나 대학원에서 논문을 준비하시는 연구자분들을 만나보면,
생성형 인공지능(AI, Artificial Intelligence) 도구를 논문 작성에 어떻게 써야 할지 고민이 정말 많았다.
"AI한테 연구모형 변수 좀 넣어달라고 했더니 10초 만에 완벽한 표를 만들어주던데요?"라며 감탄하시는 분들도 계셨다. 😊
하지만 솔직히 털어놓고 말씀드리면,
그렇게 생성된 화려한 표와 그럴싸한 학술 이론의 원본 논문을 직접 추적해 보신 적 있으신가요?
겉보기엔 노벨상감이지만 정작 원문을 열어보면 본인이 하려던 핵심 맥락과 전혀 딴판이거나, 완전히 왜곡된 엉뚱한 결론인 경우가 태반이다.
왜 이런 현상이 벌어질까요?
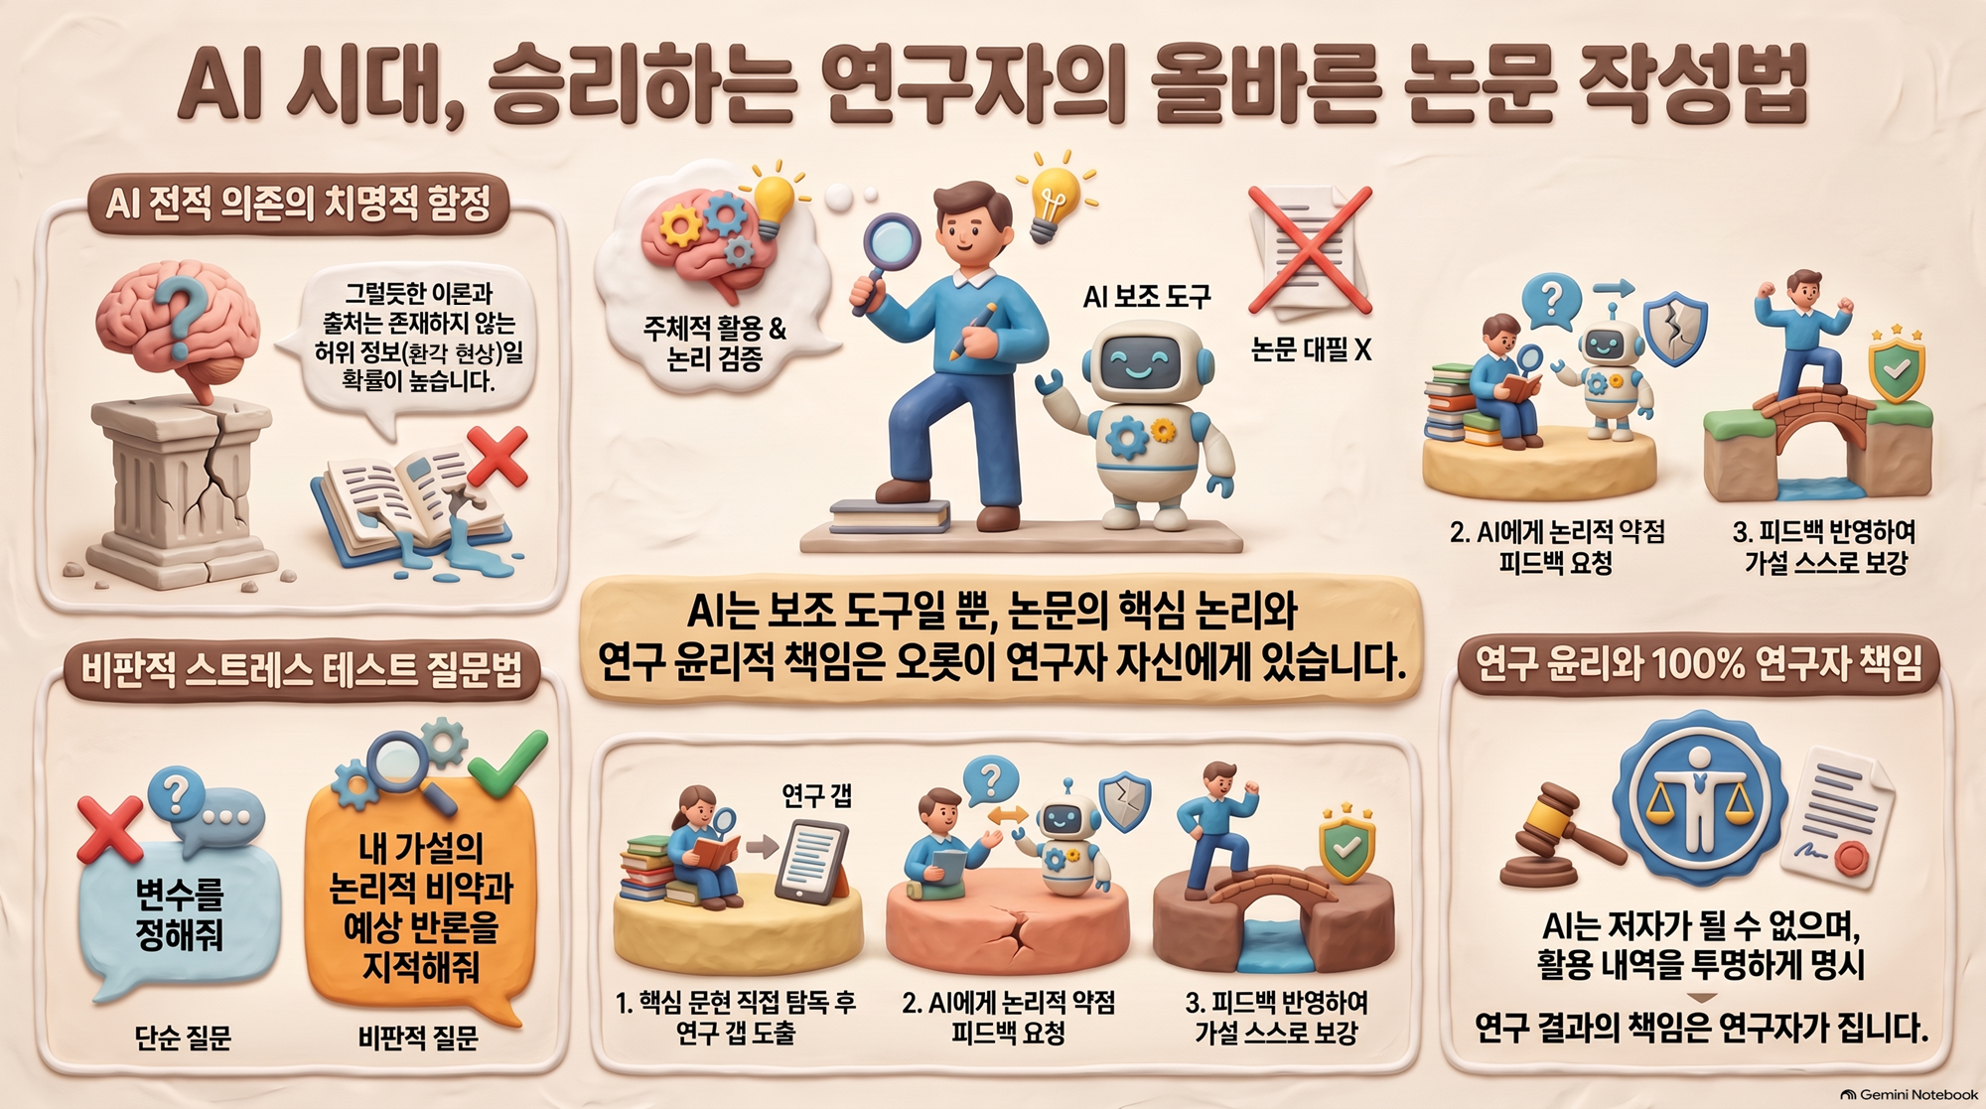
1. '그럴싸함'의 함정: AI가 만든 연구모형의 민낯 🤔
많은 초보 연구자가 연구 주제만 대략 정한 채 곧장 생성형 AI 창을 열어 "독립변수, 매개변수, 조절변수, 종속변수를 넣고 관련 학술 이론으로 연결해줘"라고 입력한다.
그러면 AI는 즉각 거시조직론이나 기술수용모델(TAM, Technology Acceptance Model), 계획된 행동이론(TPB, Theory of Planned Behavior) 등을 버무려 그럴듯한 뼈대를 쏟아낸다.
문제는 여기서 발생한다.
대형언어모델(LLM, Large Language Model)은 본질적으로 문장의 확률적 조합을 계산해 가장 자연스러운 문장을 만드는 구조이기 때문에, 연구의 실제 인과 맥락보다는 그럴듯하게 포장된 허위 정보(환각 현상, Hallucination)를 태연하게 내놓는다.
AI가 추천한 선행연구와 이론의 원저작물을 실제로 검색해보면, 논문 제목만 실재하고 저자나 연도가 틀리거나, 연구 변수의 조작적 정의가 본인의 연구 세팅과 완전히 반대인 사례가 매우 빈번합니다.
2. 연구자 주도 연구 vs AI 의존 연구 비교 📊
연구자가 연구 설계의 주도권을 쥐고 선행연구를 철저히 검토했을 때와, 시작부터 AI에 의탁했을 때의 연구 결과물 차이는 심사 단계에서 극명하게 갈린다. 아래의 비교 표를 통해 두 방식의 근본적인 차이를 확인해 보자.
연구 접근법에 따른 주요 차이점 비교
| 구분 | AI 전적 의존 방식 | 연구자 주도 + AI 보조 방식 | 심사 통과율 및 신뢰도 |
|---|---|---|---|
| 연구모형 설정 | AI가 임의 생성한 변수 조합 | 선행 문헌 기반 연구 갭 (Research Gap) 규명 |
연구 타당성 확보 |
| 이론적 배경 | 원문 미확인, 키워드 나열식 서술 | 원저 논문 정독 후 가설 메커니즘 정립 |
논리적 정밀성 우수 |
| 변수 조작적 정의 | 모호하거나 타 분야 척도 무단 혼용 | 검증된 공인 척도 채택 및 수정·보완 | 측정 신뢰도/타당도 확보 |
| 연구자의 정체성 | AI 답변의 단순 복사자(Editor) | 학술 담론을 주도하는 주체적 연구자 |
디펜스 및 구두시험 통과 |
학술지 심사위원이나 학위논문 심사교수님들은 변수 간의 논리적 긴장감을 귀신같이 짚어냅니다.
"왜 이 변수가 매개역할을 해야 하는가?"라는 질문에 AI가 쓴 문장을 읽고만 있다면 그 자리에서 바로 리젝(Reject)입니다.
3. AI는 어떻게 써야 할까? 올바른 연구 파이프라인 🧮
그렇다면 AI를 논문 연구에 아예 쓰지 말아야 할까요? 전혀 아니다.
AI는 훌륭한 '지적 파트너'이자 '페달'이 될 수 있다.
핵심은 순서이다.
연구자가 먼저 직접 문헌을 읽고 뼈대를 세운 뒤, AI를 활용해 논리를 검증하고 표현을 날카롭게 벼리는 것이다.
📝 올바른 논문 완성도 공식
성공적인 논문 = (직접 선행연구 검토 × 연구자 철학) + AI 기반 논리 스트레스 테스트 및 문장 교정
이 공식을 현장에 적용하는 3단계 작업 순서는 다음과 같습니다.
1) 1단계: RISS, DBpia, Web of Science 등 학술 DB에서 핵심 논문 20~30편을 연구자가 직접 탐독하고 연구 갭(Gap) 도출
2) 2단계: 본인이 세운 가설과 연구모형을 AI에게 제시하고 "이 가설의 반론이나 논리적 약점을 찾아줘"라며 비판적 피드백 유도
→ 3단계: 피드백을 반영해 연구자 스스로 가설의 정당성을 보강하고 글의 완성도를 높임
4. 연구 윤리와 AI: 책임은 전적으로 인간에게 있다 👩💼👨💻
국내외 유수 학술지(KCI, SSCI, SCI급)와 주요 학회들은 최근 생성형 AI 사용에 관한 명확한 윤리 가이드라인을 제정하고 있다.
전 세계 학계의 공통된 결론은 하나이다.
"인공지능은 논문의 저자(Author)가 될 수 없다"는 점이다.
또한 인공지능이 저자가 되도록 그냥 내버려 두어선 안된다!!!
자존심을 지키자!!!!!
AI는 법적·도덕적 책임을 질 수 있는 인격체가 아니기 때문이다.
AI가 잘못된 데이터를 참조해 허위 결론을 도출했더라도, 그 논문에 이름을 얹은 연구자가 100% 연구 부정행위(위조, 변조, 표절)의 법적·학술적 책임을 져야 한다.
국내외 저널 투고 시 AI 도구 활용 내역(프롬프트, 모델명, 활용 목적 등)을 '연구방법' 또는 '사사표기(Acknowledgment)'에 투명하게 명시하도록 의무화하는 추세입니다. 꼼수는 언젠가 반드시 드러납니다.
실전 사례: K 연구원의 모형 구상 실패와 극복기 📚
실제 대학원에서 학위논문을 준비하던 한 연구원의 구체적인 일화를 들려드린다.
AI에 지나치게 기대었다가 방향을 바로잡은 생생한 사례이다.
K 연구원의 초기 상황
- 상황: 생성형 AI에 프롬프트를 넣어 '생성형 AI 사용 의도에 영향을 미치는 기술적·심리적 요인 모형'을 30분 만에 도출함
- 문제점: AI가 제안한 '인지된 인지부하' 조절변수의 선행 논문을 찾아보니, 모형의 방향성과 설문 문항 구성이 실제 연구 대상인 직장인 환경과 전혀 맞지 않음
개선 및 재설계 과정
1) 첫 번째 단계: AI 창을 닫고, 경영학 및 인간-컴퓨터 상호작용(HCI) 분야 최신 학술지 20편을 출력하여 연구자가 직접 정독
2) 두 번째 단계: 국내 조직문화 특수성을 반영한 독립변수를 손수 재정의하고, AI는 '설문 문항의 명확성 다듬기'와 '대체 학술 용어 검토'에만 국한하여 활용
최종 결과
- 결과 항목 1: 심사위원들로부터 "선행연구의 한계점을 정면으로 돌파한 시의적절한 모형"이라는 호평을 받음
- 결과 항목 2: 연구 디펜스 과정에서 모든 가설 설정 근거를 막힘없이 논리적으로 방어하며 무난히 통과
이 사례가 주는 교훈은 명확하다.
연구의 맛과 깊이는 결국 연구자가 흘린 땀방울, 즉 문헌을 파고들며 고민한 시간 속에서 나오는 것이지, 인공지능이 클릭 한 번으로 배달해주는 인스턴트 문장에 있지 않다.
핵심 내용 요약 📝
오늘 나눈 논문 작성과 AI 활용에 대한 핵심 내용을 갈무리해 보겠다.
AI는 논문을 대신 써주는 대필가가 결코 될 수 없으며, 되어서도 안 된다.
하지만 연구자가 스스로 탄탄한 논리적 뼈대를 구축한 뒤에 부리는 AI는 그 어떤 연구 조교보다 든든한 날개가 되어줄 거다. 지치지 마시고 차근차근 연구자의 길을 걸어가시길 응원한다. 😊