부트스트래핑이란? 통계 분석에서 수천 번 반복 추출하는 진짜 이유
데이터 분석 실무 프로젝트를 진행하거나 학술 논문 통계를 다루다 보면, 데이터 수가 턱없이 부족하거나 정규분포 가정이 깨져서 곤혹스러웠던 순간이 다들 한 번쯤 있으실 거다.
그럴 때 통계학자들이 마법처럼 꺼내 드는 도구가 바로 '부트스트래핑(Bootstrapping)'이다.
이름도 독특한 이 기법이 도대체 무엇이고, 왜 분석 프로그램은 팬을 팽팽 돌려가며 몇천 번씩이나 계산을 반복하는 걸까요? 오늘 저와 함께 그 원리를 쉽고 친근하게 파헤쳐 보시죠! 😊
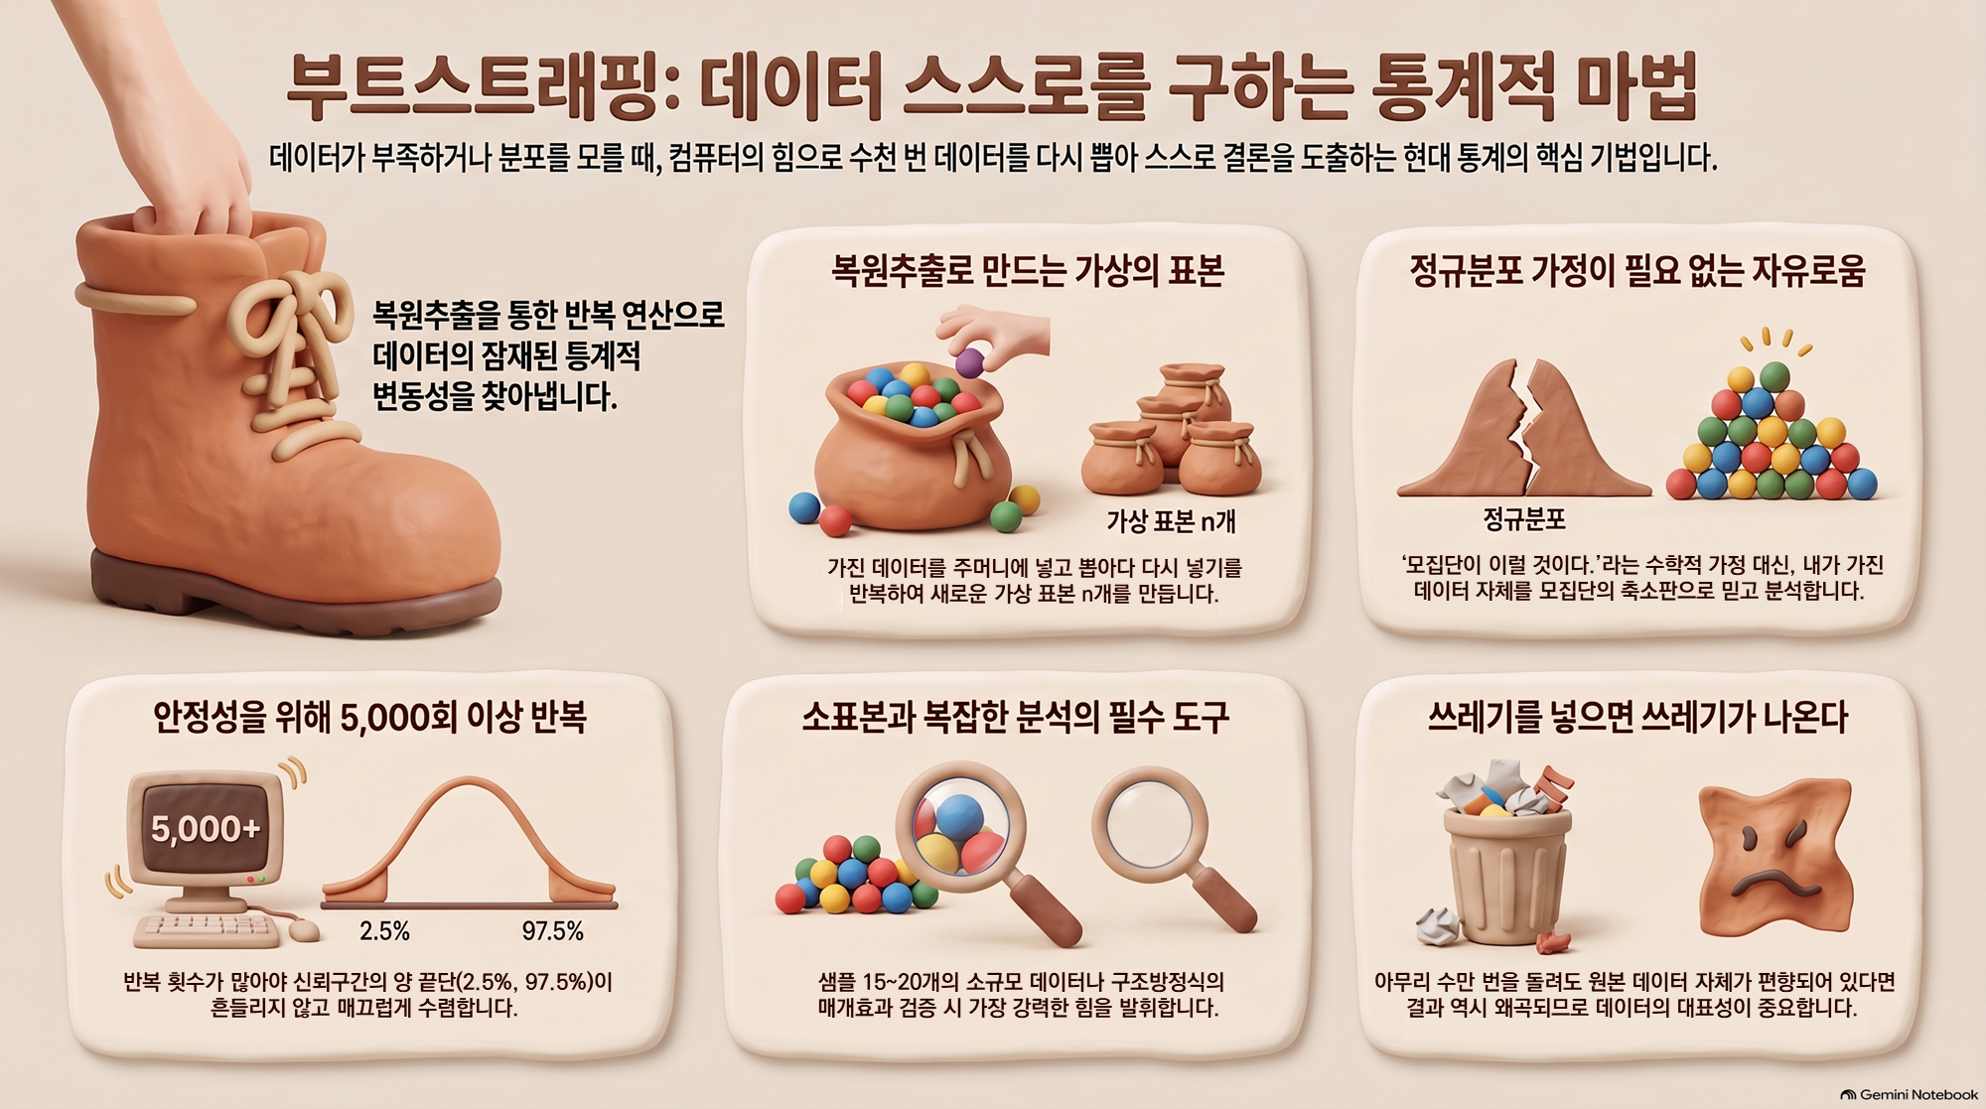
1. 부트스트래핑(Bootstrapping)의 기본 개념 🤔
부트스트래핑은 원래 '자신의 부츠 끈을 잡아당겨 스스로 늪에서 빠져나온다(To pull oneself up by one's bootstraps)'는 서양 속담에서 유래한 통계 기법이다.
외부의 도움(모집단에 대한 엄격한 가정) 없이 오직 내가 현재 가지고 있는 표본 데이터 스스로의 힘으로 통계적 추론을 해낸다는 깊은 뜻을 품고 있다.
핵심 메커니즘은 '복원추출(Resampling with replacement)'이다.
내가 가진 원본 표본 크기가 n개라면, 그 표본 주머니 안에서 하나를 뽑아 기록하고 다시 주머니에 넣은 뒤 다음 데이터를 뽑는 과정을 n번 반복해 새로운 '가상 표본'을 만들어내는 방식이다.
전통적 통계학이 "모집단은 정규분포를 따를 것이다"라는 수학적 가정에 기댄다면, 부트스트래핑은 "내가 가진 표본이 모집단의 축소판이다"라는 전제 아래 컴퓨터의 연산력으로 경험적 표본분포를 구축하는 비모수적(Non-parametric) 방법이에요.
2. 전통적 통계와 부트스트래핑 비교 📊
우리가 흔히 쓰는 전통적 통계 검정과 부트스트래핑은 어떤 차이가 있을까?
두 접근법의 핵심적인 차이를 명확하게 비교해 보면 부트스트래핑이 언제 진가를 발휘하는지 한눈에 이해할 수 있다.
수학적 공식으로 완벽한 정규분포 곡선을 그리기 어려울 때, 부트스트래핑은 데이터 자체의 비대칭성과 특성을 그대로 반영해 신뢰구간을 산출해 준다는 압도적인 장점이 있다.
전통적 모수 검정 vs 부트스트래핑 비교 분석
| 비교 항목 |
전통적 통계 (모수적 접근) |
부트스트래핑 (리샘플링 접근) |
실무 적용 팁 |
|---|---|---|---|
| 모집단 분포 가정 | 정규분포 등 특정 이론 분포 전제 필수 | 사전 분포 가정 불필요 (비모수적 접근) |
왜도/첨도가 심한 왜곡 데이터에 최적 |
| 오차 및 신뢰구간 | 표준오차 수학 공식 (SE = s / √n) 활용 |
수천 개 재표본의 통계량 분포에서 계산 | BCa 등 비대칭 보정 신뢰구간 산출 가능 |
| 복잡한 통계량 | 중앙값, 매개효과 간접경로 등 공식 유도 난해 | 어떤 통계량이든 반복 추출로 쉽게 추정 | 구조방정식(SEM) 매개효과 검증 필수 도구 |
| 컴퓨터 연산 비용 | 단 한 번의 수식 계산으로 즉시 완료 |
수천~수만 회 반복 계산으로 연산량 요구 | 현대 PC 환경에서는 대부분 수 초 내 완료 |
부트스트래핑이 만능 열쇠는 아니에요! 원래 수집한 원본 표본 자체가 편향되어 있다면(예: 편의표집 오차), 수천 번을 돌려도 왜곡된 결론만 정교해지는 '쓰레기를 넣으면 쓰레기가 나온다(GIGO, Garbage In Garbage Out)' 현상이 발생하므로 원본 데이터의 대표성이 가장 중요해요.
3. 왜 굳이 몇천 번(1,000~10,000회)이나 돌릴까요? 🧮
이 질문이 가장 핵심이죠!
100번만 돌려도 평균은 대략 나올 것 같은데, 왜 학술지와 실무 연구에서는 최소 2,000회에서 10,000회 이상의 부트스트랩 리샘플링을 강력히 권장하는 걸까?
📝 신뢰구간 분위수 추정 원리
95% 신뢰구간 백분위수 = 하위 2.5% 지점 값 ~ 상위 97.5% 지점 값
반복 횟수가 늘어나야 하는 이유는 다음과 같은 수학적 수렴 원리 때문이다.
1) 첫 번째 단계: 반복 횟수(B)가 100회뿐이면 양 끝 2.5%에 해당하는 데이터가 고작 2~3개에 불과해 극단치 하나에 신뢰구간 경계선이 심하게 요동친다.
2) 두 번째 단계: B를 2,000회~5,000회로 늘리면 하위 2.5%에 50~125개의 데이터가 촘촘히 쌓이며 꼬리 부분의 절단점이 극도로 매끄럽고 안정화된다.
→ 몬테카를로 오차(Monte Carlo Error)가 최소화되어, 분석을 다시 돌려도 신뢰구간과 p-value가 동일하게 유지된다.
4. 경영 및 논문 통계에서의 핵심 활용 분야 👩💼👨💻
이 부트스트래핑 기법이 실제 비즈니스 의사결정이나 연구 논문에서 가장 강력한 힘을 발휘하는 순간은 언제일까? 수학적 공식으로 오차를 유도하기 어려운 비선형 지표를 다룰 때 빛을 발한다.
1. 조직 연구의 매개효과 검증: Hayes 교수의 PROCESS Macro나 구조방정식(SEM)에서 간접효과(a×b)는 두 정규분포의 곱이므로 좌우대칭이 아니다. 따라서 부트스트래핑 5,000회를 통해 95% 신뢰구간 안에 0이 포함되지 않는지로 유의성을 판별한다.
2. 소표본 경영 데이터 분석: 스타트업 신제품 파일럿 테스트처럼 표본(n)이 15~30개에 불과할 때 왜곡 없이 지표를 추정한다.
3. 머신러닝 앙상블 기법의 기반: 데이터 사이언스의 대표 알고리즘인 '랜덤 포레스트(Random Forest)'의 핵심 원리인 배깅(Bagging, Bootstrap Aggregating)이 바로 이 부트스트래핑을 수백 번 돌려 모델을 결합하는 것이다.
5. 실전 예시: 소표본 스타트업 고객 유지율 신뢰구간 📚
이해를 돕기 위해 실제 20개 기업 고객을 대상으로 진행한 신규 B2B 솔루션 도입 후 '고객 순추천지수(NPS)' 개선 점수 데이터를 예로 들어본다.
사례 데이터 개요
- 표본 수(n): B2B 고객사 20곳 (소표본, 강한 우측 꼬리 분포)
- 측정 지표: 개선 점수의 중앙값(Median) 및 95% 신뢰구간 도출 필요
부트스트래핑 진행 과정 (B = 5,000회)
1) 첫 번째 단계: 20개 고객 데이터에서 복원추출로 20개를 무작위 추출하여 중앙값을 기록하는 작업을 5,000번 반복 수행함
2) 두 번째 단계: 도출된 5,000개의 중앙값을 오름차순으로 정렬한 뒤, 125번째(하위 2.5%) 값과 4,875번째(상위 97.5%) 값을 확인
최종 결과 및 해석
- 표본 중앙값: 14.5점
- 95% 부트스트랩 신뢰구간: [8.0점, 21.0점] (0을 포함하지 않으므로 효과 유의미성 검증 완료)
이처럼 정규분포 공식을 쓰기 어려운 중앙값이나 비선형 지표도 부트스트래핑을 거치면 명확하고 설득력 있는 구간 추정이 가능해진다.
핵심 내용 요약 📝
부트스트래핑은 복잡한 수학 공식에 갇혀 있던 통계를 데이터와 컴퓨팅 파워의 세계로 해방시킨 현대 통계학의 가장 혁신적인 선물이다.
분포 가정이 의심스러울 때, 표본 크기가 작을 때, 복잡한 경로 계수를 검증할 때 망설이지 말고 부트스트랩을 활용해 보자~ 😊