사회과학 논문 설문지 표본 수 몇 명 해야 통과할까?: 석사 200부? 박사 400부?
논문 프로포절이나 본심사를 준비하다 보면 가장 밤잠을 설치게 만드는 질문이 바로 "샘플 몇 개 모았어요?"라는 지도교수님의 한마디이다.
주변에서는 200명만 받아도 된다고 하고, 선배는 박사 논문이면 최소 400명은 채워야 안전하다고 겁을 주니 도대체 누구 말이 맞는지 머리가 지끈거리셨죠? 😊
제가 지난 20여 년간 연구 현장과 대학 강단에서 수많은 석·박사 선생님들의 논문 심사를 지도하고 컨설팅하면서 지켜본 결과, 표본수는 무작정 많다고 좋은 것도 아니고 적다고 무조건 탈락하는 것도 아니었다.
핵심은 '내가 사용할 통계 분석 기법이 요구하는 최소 통계적 검정력(Statistical Power)을 충족했는가?'에 달려 있다.
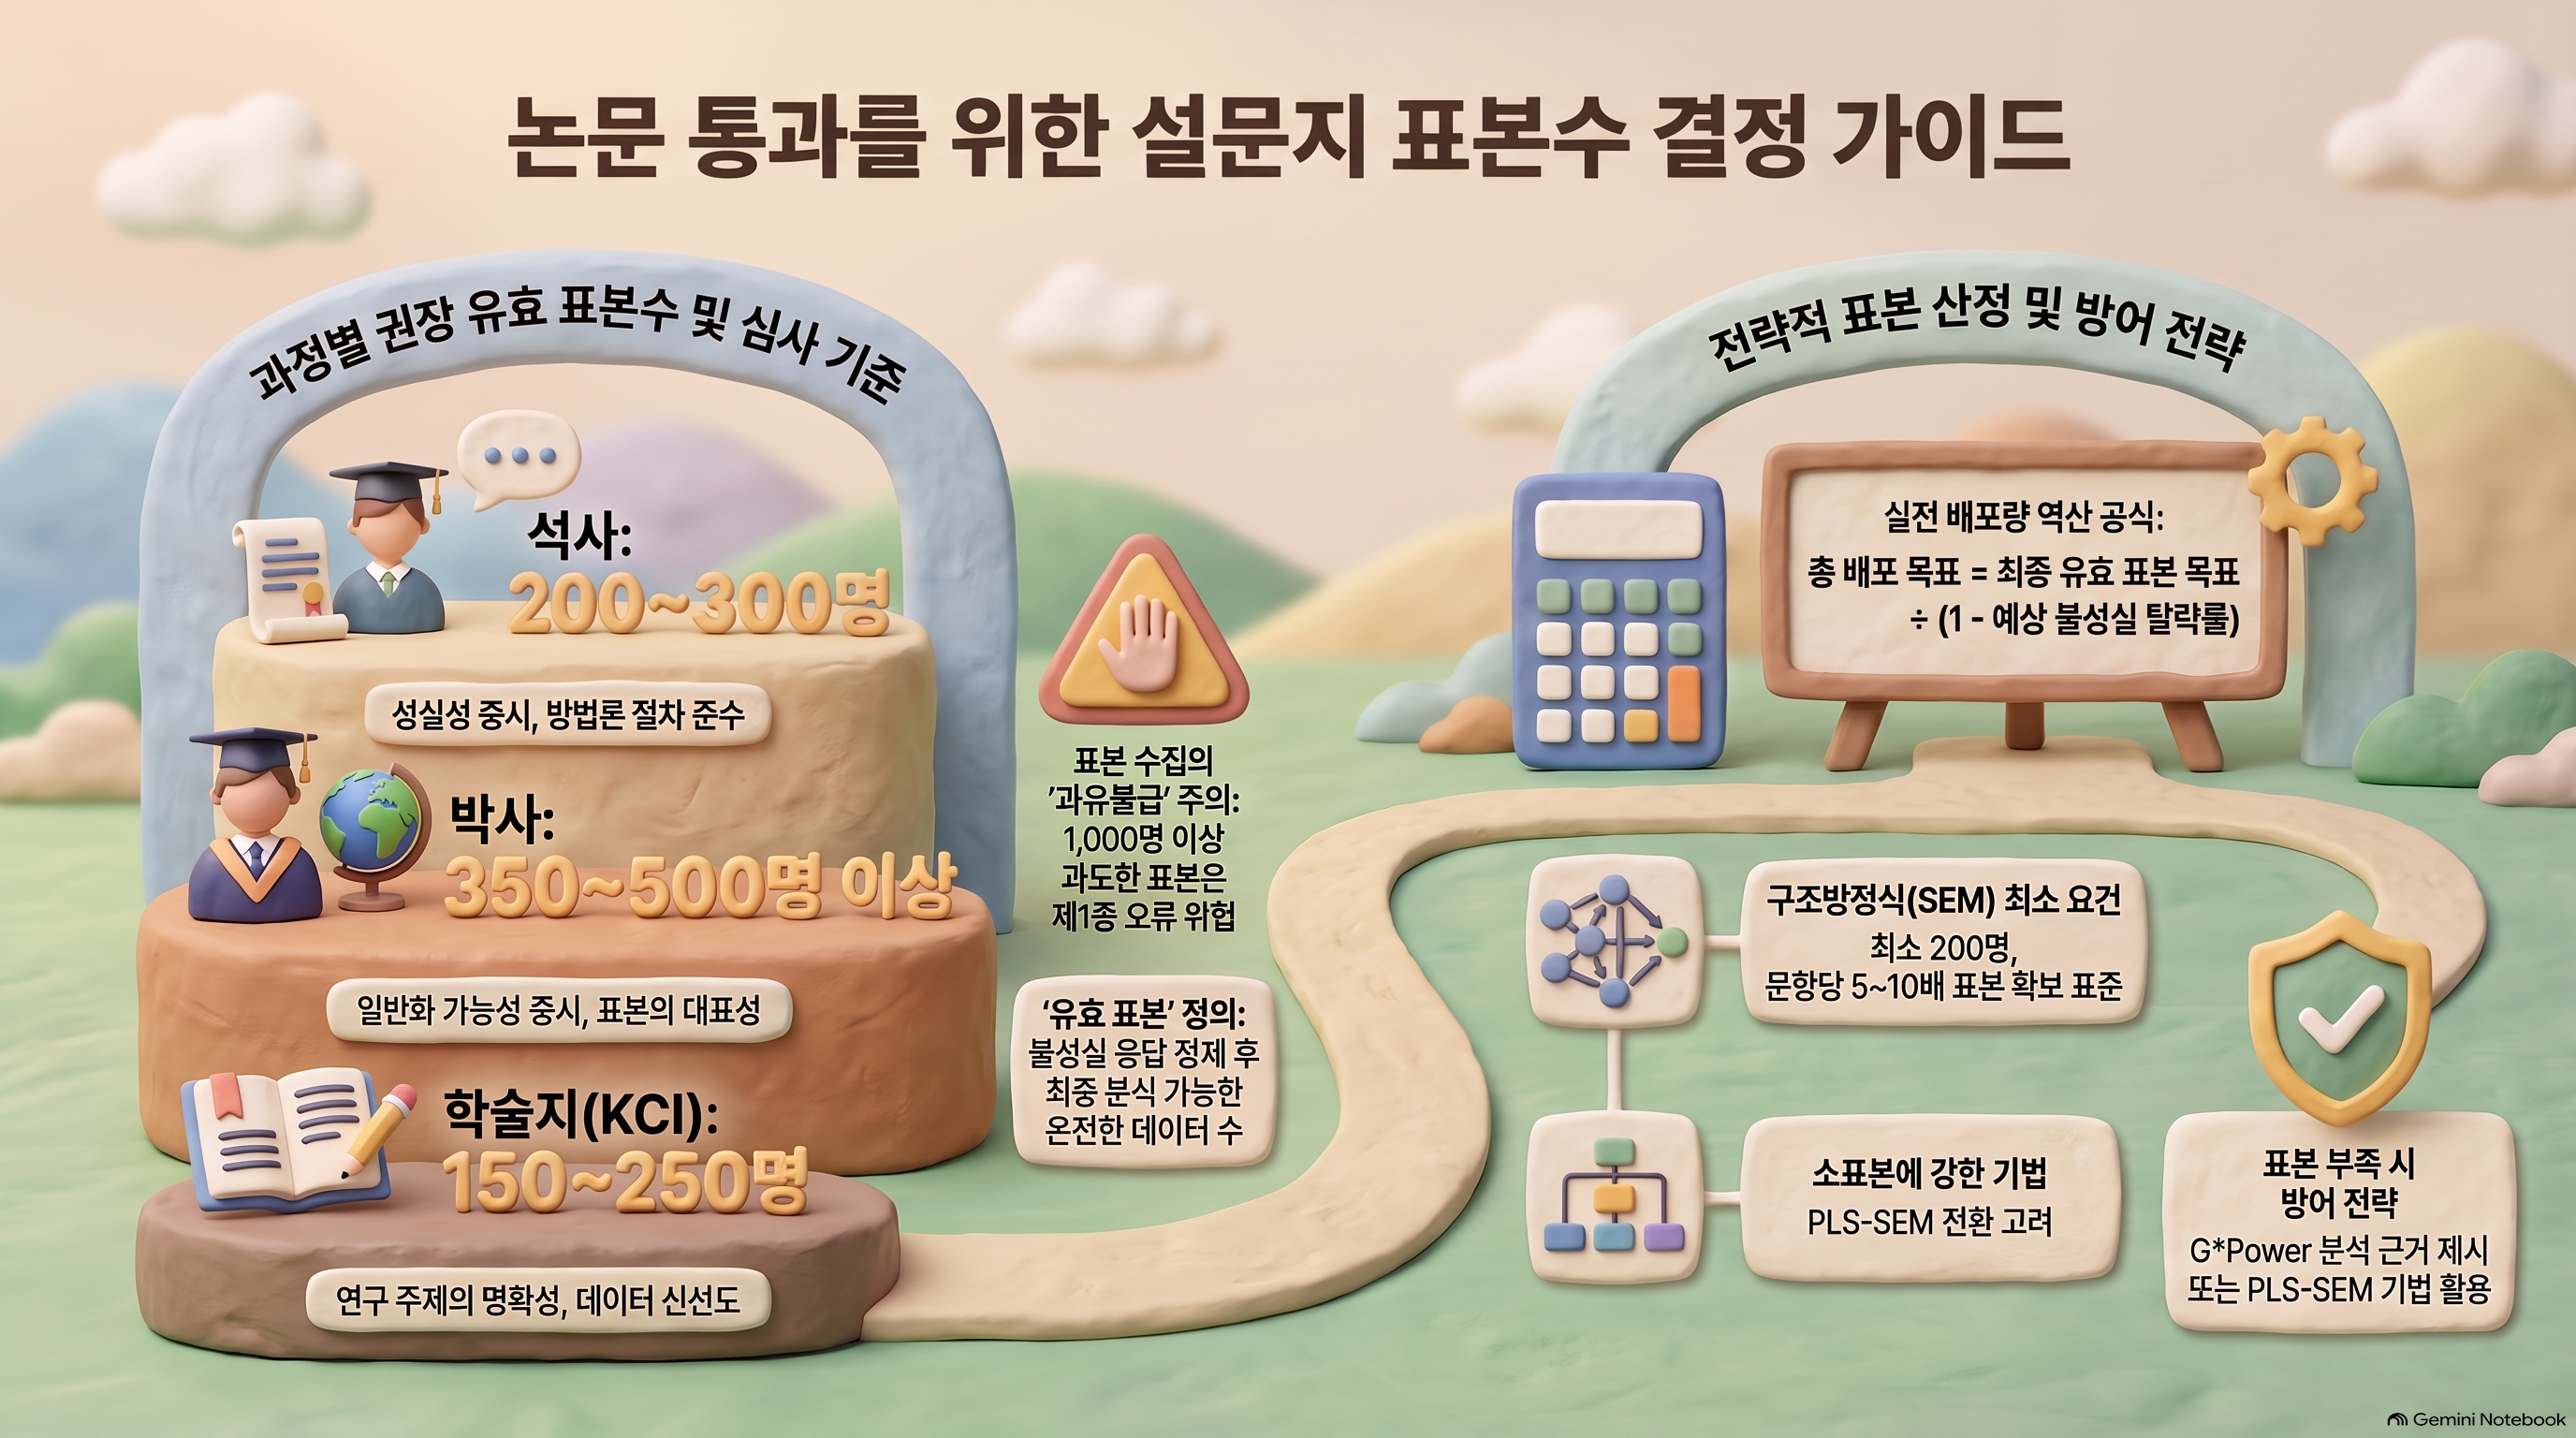
1. 학술지·석사·박사별 현실적인 평균 표본수 기준 📊
사회과학 분야(경영학, 교육학, 심리학, 행정학, 사회복지학 등)에서 연구자들이 실제로 통과하는 통상적인 응답자 수는 학위 과정과 투고 목적에 따라 명확한 격차를 보인다.
무조건 많은 데이터를 모으려다 마감 기한을 놓치기보다는 표준적인 기준치를 파악하는 것이 중요하다.
아래 표는 일반적인 양적 연구(설문조사 기반)를 기준으로 학계에서 심사위원들이 암묵적인 안정권으로 인정하는 유효 표본 크기를 비교한 결과이다.
학위 및 게재 유형별 표본수 비교 현황
| 구분 | 권장 유효 표본수 | 주요 분석 기법 | 심사 시 주안점 |
|---|---|---|---|
| 일반 등재지(KCI) | 150명 ~ 250명 | 회귀분석, 차이검증, 조절/매개 | 연구 주제의 명확성과 데이터 신선도 |
| 석사 학위논문 | 200명 ~ 300명 | 다중회귀분석, 기초 구조방정식 | 연구방법론 절차 준수 및 성실성 |
| 박사 학위논문 | 350명 ~ 500명 이상 | 구조방정식모형(SEM), 다집단 분석 | 일반화 가능성, 표본의 대표성 및 적합도 |
| 국제저널 (SSCI/SCOPUS) |
300명 ~ 500명 이상 | 고급 SEM, PLS-SEM, 패널/실험혼합 | 통계적 검정력(G*Power) 및 비응답 편향 검증 |
유효 표본수란 불성실 응답(한 줄로 세우기, 결측치 과다 등)을 정제하고 '최종 통계 프로그램(SPSS, AMOS, R 등)에 투입할 수 있는 온전한 데이터 수'를 의미합니다. 따라서 배포할 때는 목표 표본수의 120%~130%를 수집해야 안전합니다.
표본수가 지나치게 많다고 무조건 환영받는 것은 아닙니다! 표본수가 1,000명 단위를 넘어가면 극도로 작은 미세한 차이나 사소한 영향력조차 통계적으로 유의한(p < .05) 것으로 나타나는 '제1종 오류(Type I Error)'와 효과 크기 왜곡 현상이 발생하므로, 무의미한 가설이 채택되었다는 심사위원의 비판을 받을 수 있습니다.
2. 연구 방법론 및 분석 기법별 표본 크기 원칙 🤔
심사위원들이 "왜 표본수를 이만큼 잡았는가?"라고 물었을 때, "선배 논문에서 200명 하길래 저도 그렇게 했습니다"라고 답하면 십중팔구 재심사 지적을 받게 된다.
통계 분석 모형의 복잡도에 따라 학술적 근거를 제시해야 한다.
사회과학 통계학계에서 가장 널리 인용되는 분석별 표본수 결정 규칙은 크게 세 가지로 요약된다.
- 구조방정식모형(SEM, Structural Equation Modeling): Kline(2015)과 Hair et al.(2010)의 기준에 따르면 모형의 안정적 추정을 위해 최소 200명 이상이 강력히 권장되며, 복잡한 잠재변수나 매개효과가 다수 포함된 경우 300명 이상이 표준적입니다.
- 문항 수 대비 표본 배수 규칙: 탐색적 요인분석(EFA)이나 확인적 요인분석(CFA)을 수행할 때는 측정 문항 1개당 최소 5~10배의 표본이 필요합니다. 만약 전체 측정 문항이 30개라면 최소 150명~300명의 표본이 확보되어야 적합도 지수가 깨지지 않아요.
- 다중회귀분석(Multiple Regression): Green(1991)의 규칙에 따르면 전체 회귀모형 검정을 위해서는 N ≥ 50 + 8k(k는 독립변수 개수), 개별 예측변수의 상대적 기여도를 보려면 N ≥ 104 + k의 표본이 필요합니다.
3. 실전 표본 산정 공식과 예상 수거량 계산 🧮
설문 배포 계획을 세울 때는 통계 분석에 필요한 최종 표본수뿐만 아니라, 탈락할 불성실 응답률까지 감안하여 역산해야 한다. 이를 수학 공식으로 단순화하면 다음과 같다.
📝 필요 배포 설문지 산정 공식
총 배포 목표치 = 최종 유효 표본 목표치 ÷ (1 – 예상 불성실 탈락률)
만약 석사 학위논문에서 유효 표본 250명을 확보하고자 하고, 온라인 설문 플랫폼 특성상 불성실 응답률을 20%로 예상한다면 단계별 계산은 아래와 같이 진행된다.
1) 첫 번째 단계: 유효 응답 비율 계산 = 1 - 0.20 = 0.80 (80%)
2) 두 번째 단계: 총 배포 목표량 계산 = 250 ÷ 0.80 = 312.5명
→ 따라서 최소 315명 이상의 설문 응답을 수집해야 최종 250개의 클린 데이터를 얻을 수 있다.
4. 심사위원의 "표본 부족" 지적 방어 전략 👩💼👨💻
만약 특수 직군(예: 대기업 임원, 특정 희귀질환 환자, 교장선생님 등)을 대상으로 연구하여 현실적으로 200명 이상의 표본을 모으기 불가능한 상황이라면 어떻게 해야 할까?
무작정 사정하기보다는 학문적인 대체 방법론을 연구계획서에 제시해야 한다.
이럴 때는 표본수가 적어도 통계적 정당성을 획득할 수 있는 부분최소제곱 구조방정식모형(PLS-SEM, Partial Least Squares SEM)을 채택하거나, 통계 검정력 분석 도구인 G*Power 프로그램을 활용해 산출 근거를 3장에 명시해야 한다.
G*Power(전 세계 표준 표본수 산정 무료 소프트웨어)를 사용하여 유의수준(α = .05), 통계적 검정력(Power 1-β = .80~.95), 중간 효과크기(Medium Effect Size f² = .15)를 대입하면 필요 표본수가 명확히 산출됩니다. 이 분석 화면 캡처를 논문 부록이나 표본 선정 절차 부분에 넣어두면 어떤 심사위원도 표본 크기 자체로 시비를 걸지 못합니다.
실전 예시: KCI 등재지와 석·박사 합격 케이스 📚
실제 컨설팅 현장에서 표본수 설계로 심사를 원활히 무사 통과한 선생님들의 실제 사례를 소개해 드린다.
사례 1: 경영학 석사과정 김 연구원의 경우
- 연구 주제: 생성형 AI 도입 의도가 직무 만족에 미치는 영향 (매개효과 검증)
- 수집 현황: 총 300부 온라인 설문 배포 → 285부 회수 → 불성실 응답 32부 제외 → 최종 253부 확정
심사 결과 및 피드백
1) 회귀분석 및 Process Macro 4번 모델(매개효과 부트스트래핑) 검증에 250부는 매우 탄탄한 표본 크기로 인정받았습니다.
2) 인구통계학적 특성(직무별, 연령대별) 분포가 고르게 분산되어 대표성을 인정받으며 무수정 패스했습니다.
사례 2: 교육학 박사과정 박 연구원의 경우
- 고난도 구조방정식 다집단 분석(초임 교사 vs 경력 교사 비교) 모델로 최소 각 집단별 150명 이상이 필요했던 상황이었습니다.
- 총 430부 유효 표본을 확보하여 집단 간 차이 검증과 측정 동일성(Measurement Invariance) 검증을 완벽하게 통과했습니다.
결국 중요한 것은 내 연구가 단순한 차이 검증인지, 매개, 조절 효과인지, 아니면 다집단 구조방정식 모델인지에 따라 알맞은 '최소 안전선'을 지켜주는 것이다.
핵심 내용 요약 📝
논문 설문지 표본수는 단순한 숫자의 크기가 아니라 연구자의 성실성과 방법론적 타당성을 대변하는 가장 기본적인 증거이다.
어설프게 숫자에 쫓겨 아무에게나 링크를 뿌려 불성실한 응답을 섞기보다는,
명확한 연구 타깃을 정해 석사는 200~250부, 박사는 350~400부의 정제된 데이터를 확보하는 전략이 가장 확실하고 빠른 졸업의 지름길이다~ 😊