설문 응답 이상치, 결측값 완벽 정제 기준
힘들게 설문지 수백 부를 돌리고 설레는 마음으로 엑셀 파일을 딱 열었을 때, 모든 문항에 3번만 적혀 있는 일명 '한 줄 세우기'를 보면 정말 눈앞이 캄캄해지시죠? 😅
저 역시 연구원 시절이나 학생들 논문 지도를 할 때마다 이런 데이터를 마주하면 깊은 한숨부터 쉬곤 했다.
하지만 실망하실 필요 전혀 없다!
데이터 정제(Data Cleaning)는 연구의 신뢰도를 결정짓는 가장 핵심적인 학술적 절차이자 연구자의 역량을 보여주는 무대이다. 😊
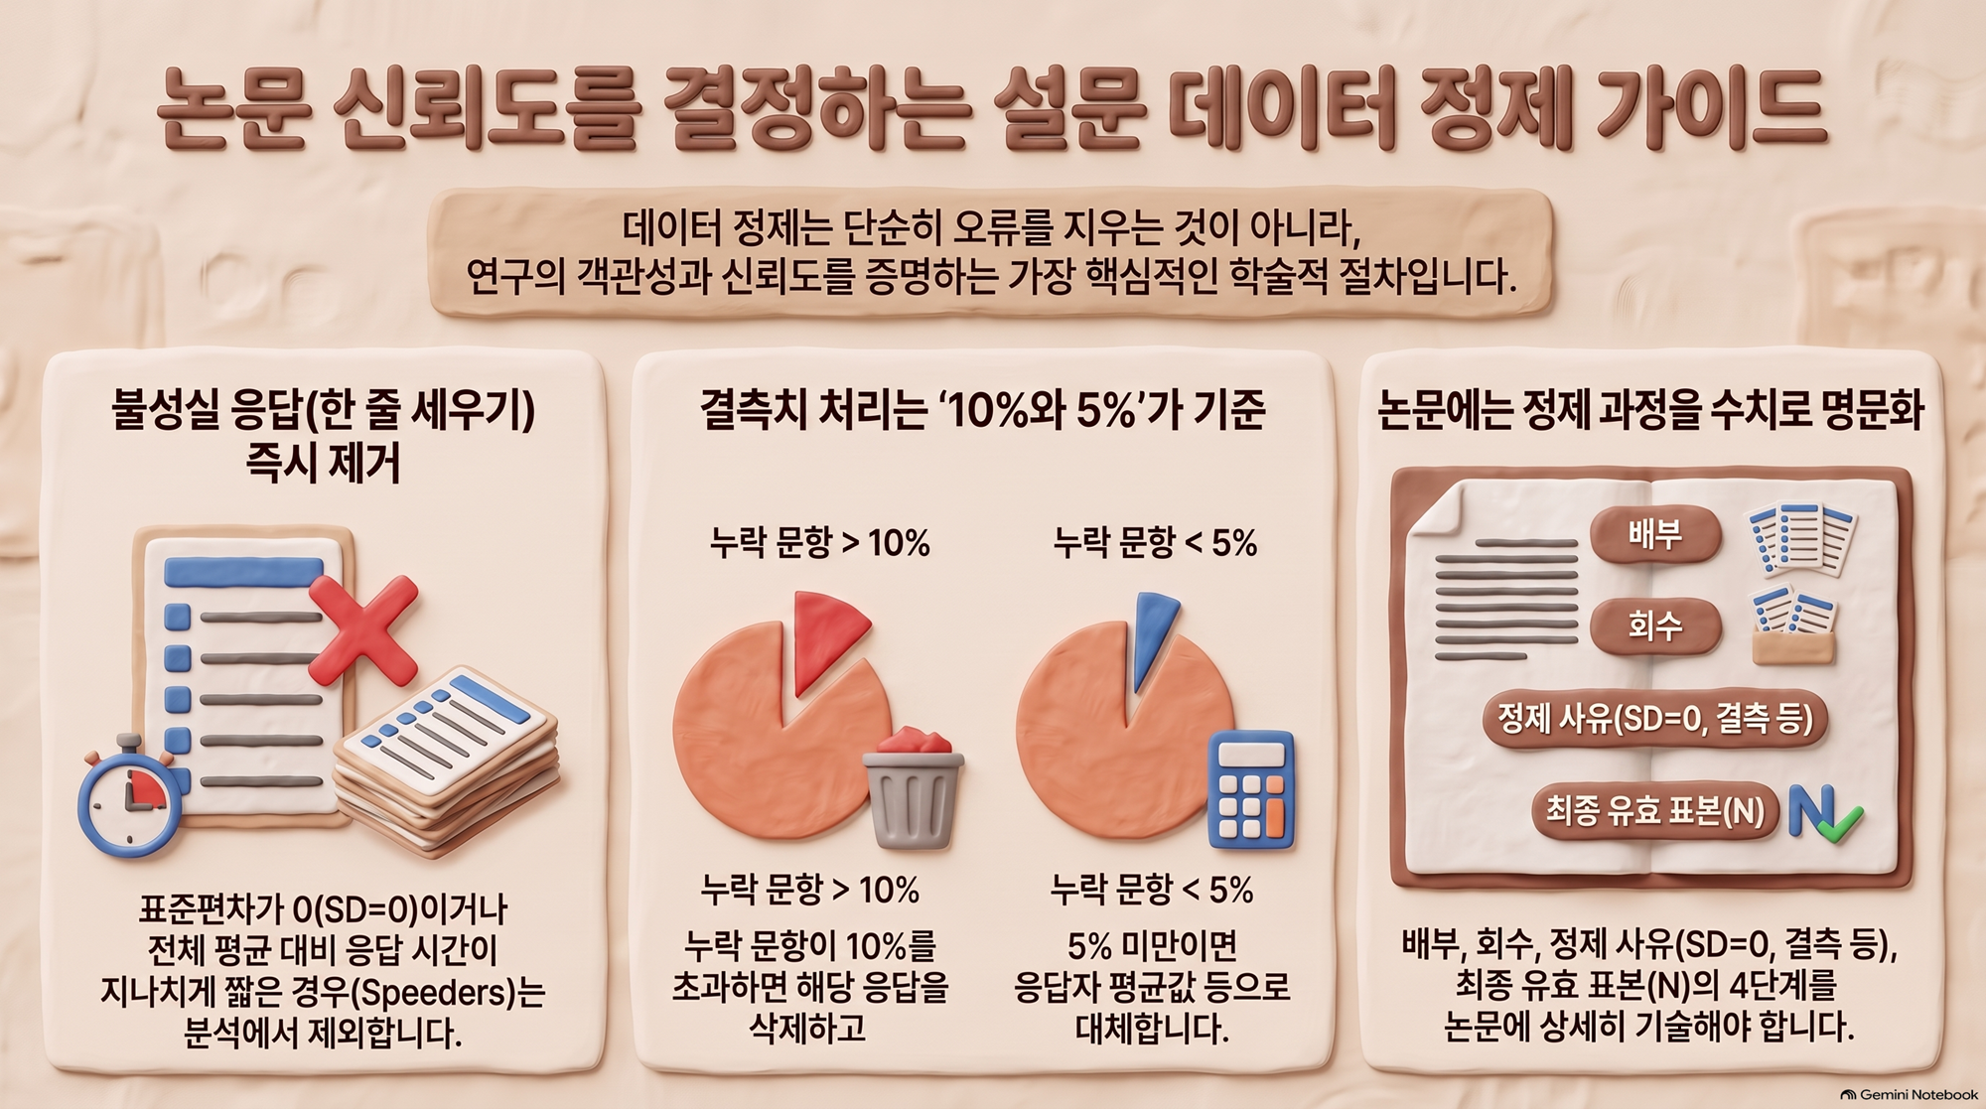
1. 불성실 응답(한 줄 세우기) 탐지와 제거 기준 🤔
설문 응답자가 질문을 전혀 읽지 않고 기계적으로 체크한 데이터는 분석 결과를 심각하게 왜곡한다.
통계학에서는 이를 무반응이나 불성실 응답 편향으로 분류하는데, 가장 대표적인 형태가 특정 번호로만 일관되게 응답하는 스트레이트 라이닝(Straight-lining, 한 줄 세우기)과 지그재그 패턴이다.
이를 과학적으로 선별해내기 위해 우리는 설문 설계 단계에 삽입했던 역코딩 문항(Reverse-coded items)과 주의 집중 확인 문항(Attention check items)을 활용한다.
예를 들어 "나는 직무에 만족한다"에 5점(매우 그렇다)을 준 응답자가 바로 다음 "나는 출근하는 것이 불행하다"에도 5점을 주었다면 불성실 응답일 가능성이 매우 높다.
온라인 설문 플랫폼(구글 폼, 네이버 폼 등)을 사용했다면 '응답 소요 시간'을 반드시 확인하세요. 총 50문항 설문인데 전체 응답 시간이 60초 미만인 케이스는 문항을 읽지 않은 것이 명백하므로 1차 제거 대상(Speeders)으로 분류하는 것이 학술적 정례입니다.
2. 결측값(Missing Data) 처리: 제거(Deletion) vs 대체(Imputation) 📊
설문 응답 중 일부 문항이 비어있는 결측치는 무조건 지우는 것이 능사일까요? 결론부터 말씀드리면 아니다.
결측치 비율과 메커니즘(MCAR, MAR, MNAR)에 따라 처리 방식이 완전히 달라져야 한다.
일반적으로 특정 응답자의 결측 문항이 전체 문항의 10~15%를 초과하는 경우에는 분석의 타당성을 저해하므로 케이스 전체를 제거(Listwise Deletion)한다.
반면 결측 비율이 매우 미미한 경우(5% 미만)에는 표본 손실을 막기 위해 대체 기법을 사용하는 것을 권장한다.
결측치 및 이상치 정제 방식 비교
| 구분 | 적용 방법 | 장점 | 주의사항 및 한계 |
|---|---|---|---|
| 완전 제거법 (Listwise) |
결측 문항이 하나라도 포함된 응답자 전체 삭제 | 분석 표본 간 일관성 유지, 적용 용이 |
유효 표본 크기 축소로 인한 통계적 검정력 저하 |
| 평균/중앙값 대체법 | 해당 문항의 전체 평균 또는 중위값으로 보완 | 표본 크기 유지, 계산 직관성 우수 |
분산 과소추정 및 변수 간 상관관계 왜곡 위험 |
| 다중대체법 (Multiple Imputation) |
회귀 모델 기반 여러 데이터셋 생성 후 결합 | 결측 불확실성 반영, 모수 추정 편향 최소화 |
분석 절차가 복잡하며 전용 통계 패키지 필요 |
| 이상치 정제 (Z-score/IQR) |
표준화 점수 ±3 이상 또는 사분위범위 외 극단값 정제 | 정규분포 가정 충족 및 왜곡 방지 | 실제 유의미한 극단적 특성인지 면밀한 검토 필수 |
리커트 척도(Likert scale) 설문에서 결측치를 처리할 때 특정 응답자의 전체 결측 비율이 5% 미만이라면 문항 평균 대체보다는 동일 응답자의 하위 요인 문항 평균(Person mean imputation)을 산출하여 채우는 방식이 연구 맥락상 더욱 설득력을 갖습니다.
3. 학술 논문 '제3장 연구방법' 실제 작성 표준 템플릿 👩💼👨💻
많은 연구자들이 "데이터가 지저분해서 그냥 알아서 뺐다"는 뉘앙스로 작성하다가 논문 심사위원들로부터 가차 없는 지적을 받습니다. 논문에는 객관적인 정제 사유와 구체적인 수치를 학술적 문장으로 명시해야 신뢰를 얻습니다.
표본 정제 과정을 작성할 때는 '누가 읽더라도 동일하게 걸러낼 수 있을 만큼' 기준을 명문화하는 것이 핵심입니다. 한 줄 세우기는 표준편차(SD=0) 기준, 결측치는 문항 누락 비율(%), 응답 시간 이상치는 사분위수(IQR) 기준 등을 수치로 적시하세요.
실전 예시: 논문 표본 수집 및 정제 서술 모델 📚
실제 석사 및 박사학위 논문, 등재지(KCI) 논문의 [연구방법 - 조사 대상 및 자료수집 절차]에 바로 복사하여 변수만 수정해 활용할 수 있는 모범 문안이다.
조사 대상 표본 정제 실제 서술 예시
- 배부 및 회수: 2026년 3월 1일부터 3월 25일까지 수도권 IT 기업 종사자를 대상으로 설문지 총 350부를 온라인 배부하여 324부를 회수함(회수율 92.6%).
- 정제 기준: 회수된 설문지 중 중심화 경향 및 무응답 편향을 방지하기 위해 엄격한 정제 기준을 적용함.
정제 단계별 제외 내역
1) 모든 척도 문항에 동일한 번호로 응답한 불성실 응답(표준편차 SD = 0) 11부 제외
2) 전체 문항의 10% 이상 주요 핵심 변수에 응답 누락이 발생한 결측 응답 8부 제외
3) 문항 응답 소요 시간이 전체 평균 대비 지나치게 짧은 이상 응답(Speeders, 90초 미만) 5부 제외
최종 논문 기술 문안
"본 연구의 실증분석을 위하여 배부된 350부의 설문 중 324부가 회수되었다. 회수된 설문지 가운데 모든 문항에 동일한 번호를 연속 기재한 불성실 응답 11부, 주요 변수의 결측 문항 비율이 10%를 초과하는 8부, 그리고 평균 소요 시간 미달 이상치 5부를 포함하여 총 24부를 분석 대상에서 제외하였다. 최종적으로 유효 응답으로 판정된 300부(유효율 85.7%)를 본 연구의 최종 통계분석 표본으로 채택하였다."
이처럼 정제 과정과 탈락 사유를 단계별 수치로 깔끔하게 기술하면, 심사위원 입장에서도 연구 데이터의 신뢰성과 객관성을 반박 없이 인정할 수밖에 없게 된다.
핵심 내용 요약 📝
데이터 수집 후 결측치와 불성실 응답을 발견했다고 해서 당황할 필요가 전혀 없다.
학술 연구는 완벽한 데이터를 가져오는 마법이 아니라, 불완전한 현실 데이터를 통계적 기준과 투명한 절차를 통해 신뢰할 수 있는 학술 자산으로 가공하는 과정이기 때문이다.😊