R·파이썬 코드 복붙의 비극: 왜 심사위원 질문에 답하지 못할까?
요즘 연구실이나 컨설팅 현장에서 연구자분들을 만나다 보면 참 격세지감을 느껴진다.
예전에는 데이터 클리닝부터 R 스크립트 작성, SPSS 클릭 하나하나 밤을 새워가며 통계 패키지와 씨름했는데, 요즘은 생성형 AI에 프롬프트 몇 줄만 넣으면 파이썬 분석 코드부터 가설 검증 결과 해석 문단까지 순식간에 뽑아주니까요. 😊
그런데 말이죠, 바로 여기서 수많은 대학원생과 신진 연구자들이 '블랙박스 함정'에 빠진다.
화면에 출력된 유려한 통계 용어와 유의확률 수치를 그대로 논문 4장에 옮겨 적고 뿌듯해하지만, 정작 본심사 심사위원 앞에서는 식은땀을 흘리게 된다.
"선생님, 이 계수가 유의하게 나온 이론적 배경과 통계적 전제조건이 뭡니까?"라는 단 하나의 질문이다.
1. 왜 AI가 작성한 완벽한 문단이 디펜스에서 무너질까? 🤔
AI가 만들어낸 문장은 문법적으로나 형식적으로 흠잡을 데가 없다.
"가설 1은 통계적으로 유의미한 정(+)의 영향을 미치는 것으로 나타났다(β=.342, p<.001)" 같은 전형적인 학술 문체를 막힘없이 써내려간다.
하지만 심사위원들이 디펜스에서 검증하는 것은 문장의 미사여구가 아니라, 연구자가 분석 모형의 내부 메커니즘을 온전히 장악하고 있는가이다.
AI 도구가 산출한 통계량은 데이터의 수학적 계산 결과일 뿐,
여러분의 연구 맥락과 가설 사이의 논리적 필연성을 대변해주지 못한다.
코드가 왜 그 패키지를 썼는지, 가정 검정이 왜 생략되었는지 모른 채 복사해 붙여넣은 결과는 날카로운 질의 앞에서 모래성처럼 허물어진다.
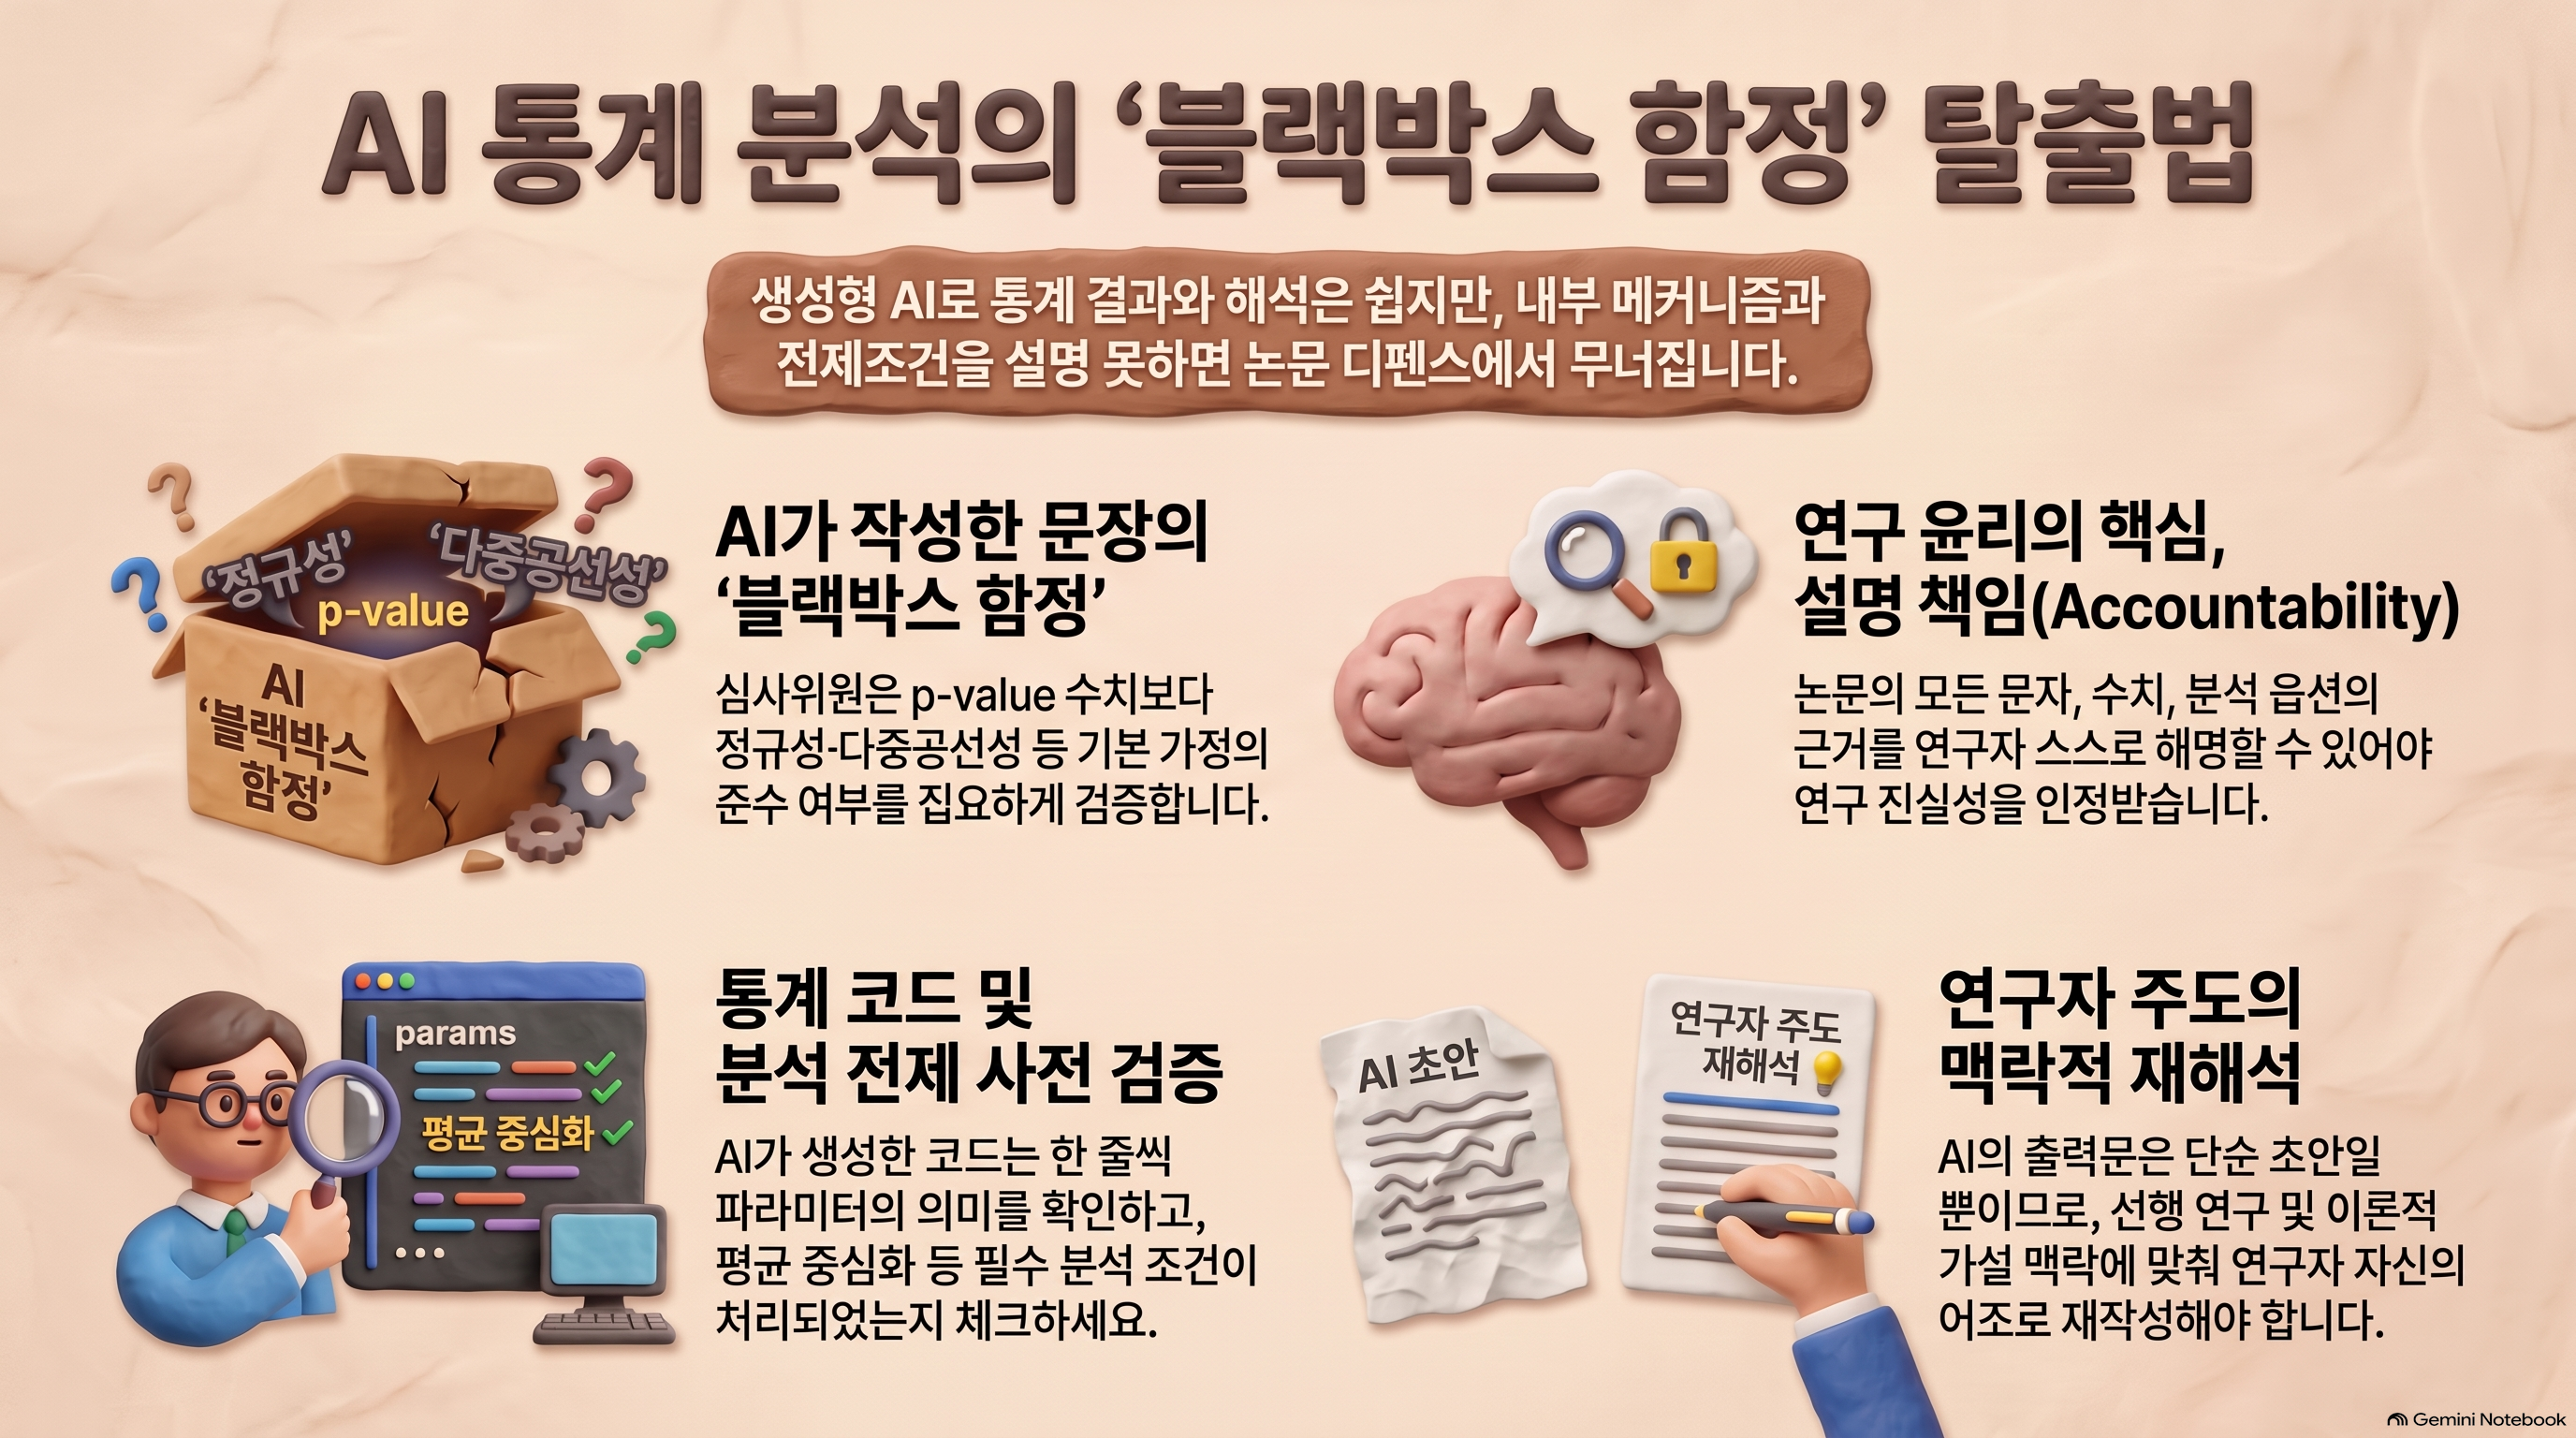
심사위원은 p-value 수치 자체보다 그 수치가 도출되기까지 거쳐야 하는 기본 가정(정규성, 등분산성, 다중공선성 등)과 연구 설계 간의 정합성을 집요하게 파고듭니다.
2. 생성형 AI 분석 활용의 치명적인 함정 비교 📊
연구자가 직접 통계적 이론을 이해하고 주도적으로 분석할 때와,
AI에 해석을 전적으로 일임했을 때 심사 현장에서의 대처 능력은 완전히 극과 극으로 갈린다.
아래 표를 통해 연구자가 흔히 범하는 블랙박스 의존 방식의 오류를 냉정하게 점검해보자.
연구 주체성에 따른 분석 프로세스 및 결과 비교
| 구분 | AI 전적 의존 (블랙박스형) | 연구자 주도 해석 (협업형) | 디펜스 평가 |
|---|---|---|---|
| 코드 작성 | 라이브러리 세부 옵션 미확인 프롬프트 실행 |
옵션값의 수식적 근거 검증 후 코드 채택 |
분석 재현성 보장 여부 |
| 전제조건 검토 | 정규성·등분산성 무시하고 가설결과만 도출 |
잔차 분석 및 다중공선성 수치 사전 통제 |
모형 타당성 검증의 핵심 |
| 결과 해석 | AI가 출력한 문장 무비판적 인용 |
선행연구 이론과 결부된 논리적 재해석 |
학술적 기여도 인정 |
| 심사 질의 대응 | "프로그램이 이렇게 나왔습니다" 식의 회피 |
통계 계수의 연구적 함의를 명확히 변론 |
합격 여부의 분기점 |
연구자가 자신이 쓴 논문의 데이터 처리 방식과 수치적 배경을 스스로 설명하지 못하는 순간, 이는 단순한 미흡함을 넘어 심각한 학술 윤리 위반이자 '연구 진실성 훼손'으로 간주될 수 있습니다.
3. 연구 윤리와 설명 책임: 도구를 다루기 전 기준 세우기 👩💼👨💻
인공지능 기술은 훌륭한 연구 파트너가 될 수 있지만, '최종 책임의 주체'가 결코 될 수 없다.
연구 윤리에서 가장 엄격하게 다루는 원칙 중 하나가 바로 설명 책임(Accountability)이다.
논문에 등재된 모든 문자, 수치, 각주 하나까지도 연구자가 오롯이 해명할 수 있어야 한다.
만약 AI가 분석 라이브러리의 기본 디폴트 옵션을 잘못 설정하여 편향된 회귀계수를 뱉어냈는데, 이를 연구자가 알지 못한 채 통과시켰다면 어떻게 될까요?
심사위원이 이를 지적했을 때 "AI가 그렇게 코딩해주었다"라고 말하는 것은 연구자 자격을 스스로 포기하는 것과 다름없다.
1. AI가 생성한 모든 R/Python 코드는 각 함수 파라미터가 무엇을 의미하는지 한 줄씩 주석을 달아 분석해보세요.
2. 유의확률(p-value)에만 매몰되지 말고 효과 크기(Effect Size)와 신뢰구간의 의미를 직접 기술하세요.
3. 도구에게 "해석해줘"라고 명령하기 전에, 선행연구의 이론적 가설 방향성과 내 데이터의 특성을 먼저 규정해야 합니다.
실전 예시: 김 연구원의 조절효과 디펜스 참사 📚
실제로 학위논문 심사 과정에서 흔하게 벌어지는 안타까운 실제 사례 하나를 각색하여 소개해 드린다.
사례 연구자의 상황
- 상황: 석사 4학기 김 연구원은 Python의 통계 라이브러리를 AI로 호출하여 상호작용항(Interaction Term) 회귀분석을 수행함
- 진행: 상호작용 항이 p<.05로 유의하게 나오자 AI가 요약해준 문단을 그대로 복사하여 4장 결과 및 5장 결론 작성
심사위원의 질문과 붕괴 과정
1) 심사위원 질문: "김 선생, 독립변수와 조절변수의 평균 중심화(Mean Centering)는 처리했습니까? 다중공선성 VIF 지수는 확인했나요?"
2) 연구원의 대응: AI 프롬프트에 평균 중심화 조건을 걸지 않아 다중공선성 수치가 15를 넘었으나, 연구자는 VIF의 개념조차 제대로 알지 못해 "AI 코드가 오류 없이 돌아가서 확인하지 못했습니다"라고 답변
최종 결과
- 결과 판정: 논문 전면 수정 및 재심사(사실상의 디펜스 탈락)
- 시사점: 통계적 기법의 기초 원리(평균 중심화의 필요성)를 모른 채 도구가 뱉은 결과만 믿었을 때 발생하는 대표적 파국
이 비극은 김 연구원이 게을러서가 아니다.
생성형 AI라는 강력한 도구가 주는 '손쉬운 환상'에 취해 연구자의 본질인 학문적 해석 책임을 망각했기 때문에 발생한 일이다.
핵심 내용 요약 📝
AI는 연구자의 시간을 아껴주는 지극히 유능한 조수이지만, 논문의 주인이 될 수는 없다.
결과 해석의 수학적·이론적 근거를 연구자가 스스로 꿰뚫어 보지 못한다면 아무리 화려한 통계표도 사상누각에 불과하다.
도구를 다루기 전에 연구자 본인의 단단한 해석 기준을 먼저 세워보자. 😊
핵심 요약: 블랙박스 함정 탈출법
자주 묻는 질문 ❓