연구 계획서를 작성하거나 설문지 데이터를 받아 들었을 때 가장 막막한 순간이 언제일까요?
아마도 "교수님, 제 연구 모형은 어떤 분석을 돌려야 하나요?"라는 질문 앞에서 통계 패키지 메뉴만 하염없이 들여다볼 때일 거다.
많은 대학원생과 연구자분들이 가설은 멋지게 세워두고도 변수의 성격을 제대로 분류하지 못해 엉뚱한 분석 기법을 적용하다 심사에서 지적받곤 한다. 😭
하지만 전혀 두려워할 필요 없다!
복잡해 보이는 통계 기법도 결국 '독립변수(원인)와 종속변수(결과)가 어떤 척도로 측정되었는가'라는 데이터의 유형과 '가설 검증의 목적(집단 간 차이 비교인가, 인과관계 영향력 파악인가)'이라는 두 가지 열쇠만 쥐면 퍼즐처럼 완벽하게 맞아떨어진다. 😊

1단계: 변수의 성격 규명, 4대 측정 척도 완벽 정리 🤔
통계 기법을 결정하는 가장 핵심적인 출발점은 데이터의 척도(Scale of Measurement)를 파악하는 작업이다.
변수가 어떤 숫자로 구성되어 있는지 모른 채 기법부터 고르려고 하면 무조건 실패한다.
척도는 측정 수준에 따라 질적 척도(명목척도, 서열척도)와 양적 척도(등간척도, 비율척도)로 나뉜다.
통계 분석 기법의 대다수는 이 척도 조합에 의해 기계적으로 결정된다고 해도 과언이 아니다.
• 명목척도(Nominal Scale): 분류 목적의 척도. 산술 연산이 불가능하며 단순 집단을 구분한다. (예: 성별, 거주지역, 구매여부)
• 서열척도(Ordinal Scale): 순서와 등급이 존재하나 간격이 동일하지 않다. (예: 직급, 학력 수준, 만족도 순위)
• 등간척도(Interval Scale): 속성의 간격이 동일하며 임의의 원점(0이 '없음'을 뜻하지 않음)을 가진다. (예: 리커트 5점/7점 척도, 온도)
• 비율척도(Ratio Scale): 절대 영점(0은 부재를 의미)이 존재하고 사칙연산이 모두 가능하다. (예: 매출액, 연령, 재방문 횟수, 근무연수)
독립·종속변수 척도별 통계 기법 매핑 매트릭스 📊
연구 가설에서 설정한 원인 변수(독립변수, Independent Variable)와 결과 변수(종속변수, Dependent Variable)를 대입해보자.
설문지에서 주로 활용하는 리커트 5점(or 7점) 척도는 통상 학술 연구에서 등간척도(연속형 변수)로 간주하여 평균 분석이나 회귀분석, 구조방정식에 적극 활용한다.
주요 통계 기법 결정 기준표
| 가설 목적 | 독립변수(X) | 종속변수(Y) | 추천 분석 기법 |
|---|---|---|---|
| 두 집단 간 평균 차이 검증 | 범주형 (명목 2개 집단) |
연속형 (등간/비율) |
독립표본 t-검정 (Independent t-test) |
| 세 집단 이상 평균 차이 검증 | 범주형 (명목 3개 이상 집단) |
연속형 (등간/비율) |
일원배치 분산분석 (One-way ANOVA) |
| 인과적 영향력 및 예측 | 연속형 (단일/복수) |
연속형 (등간/비율) |
다중회귀분석 (Multiple Regression) |
| 이분형 사건 발생 예측 | 연속형 또는 범주형 | 이분형 명목 (성공/실패 등) |
로지스틱 회귀분석 (Logistic Regression) |
| 다차원 인과망 및 매개/조절 검증 | 잠재변수 (다문항 측정) |
잠재변수 (다문항 측정) |
구조방정식모델(SEM: Structural Equation Modeling) |
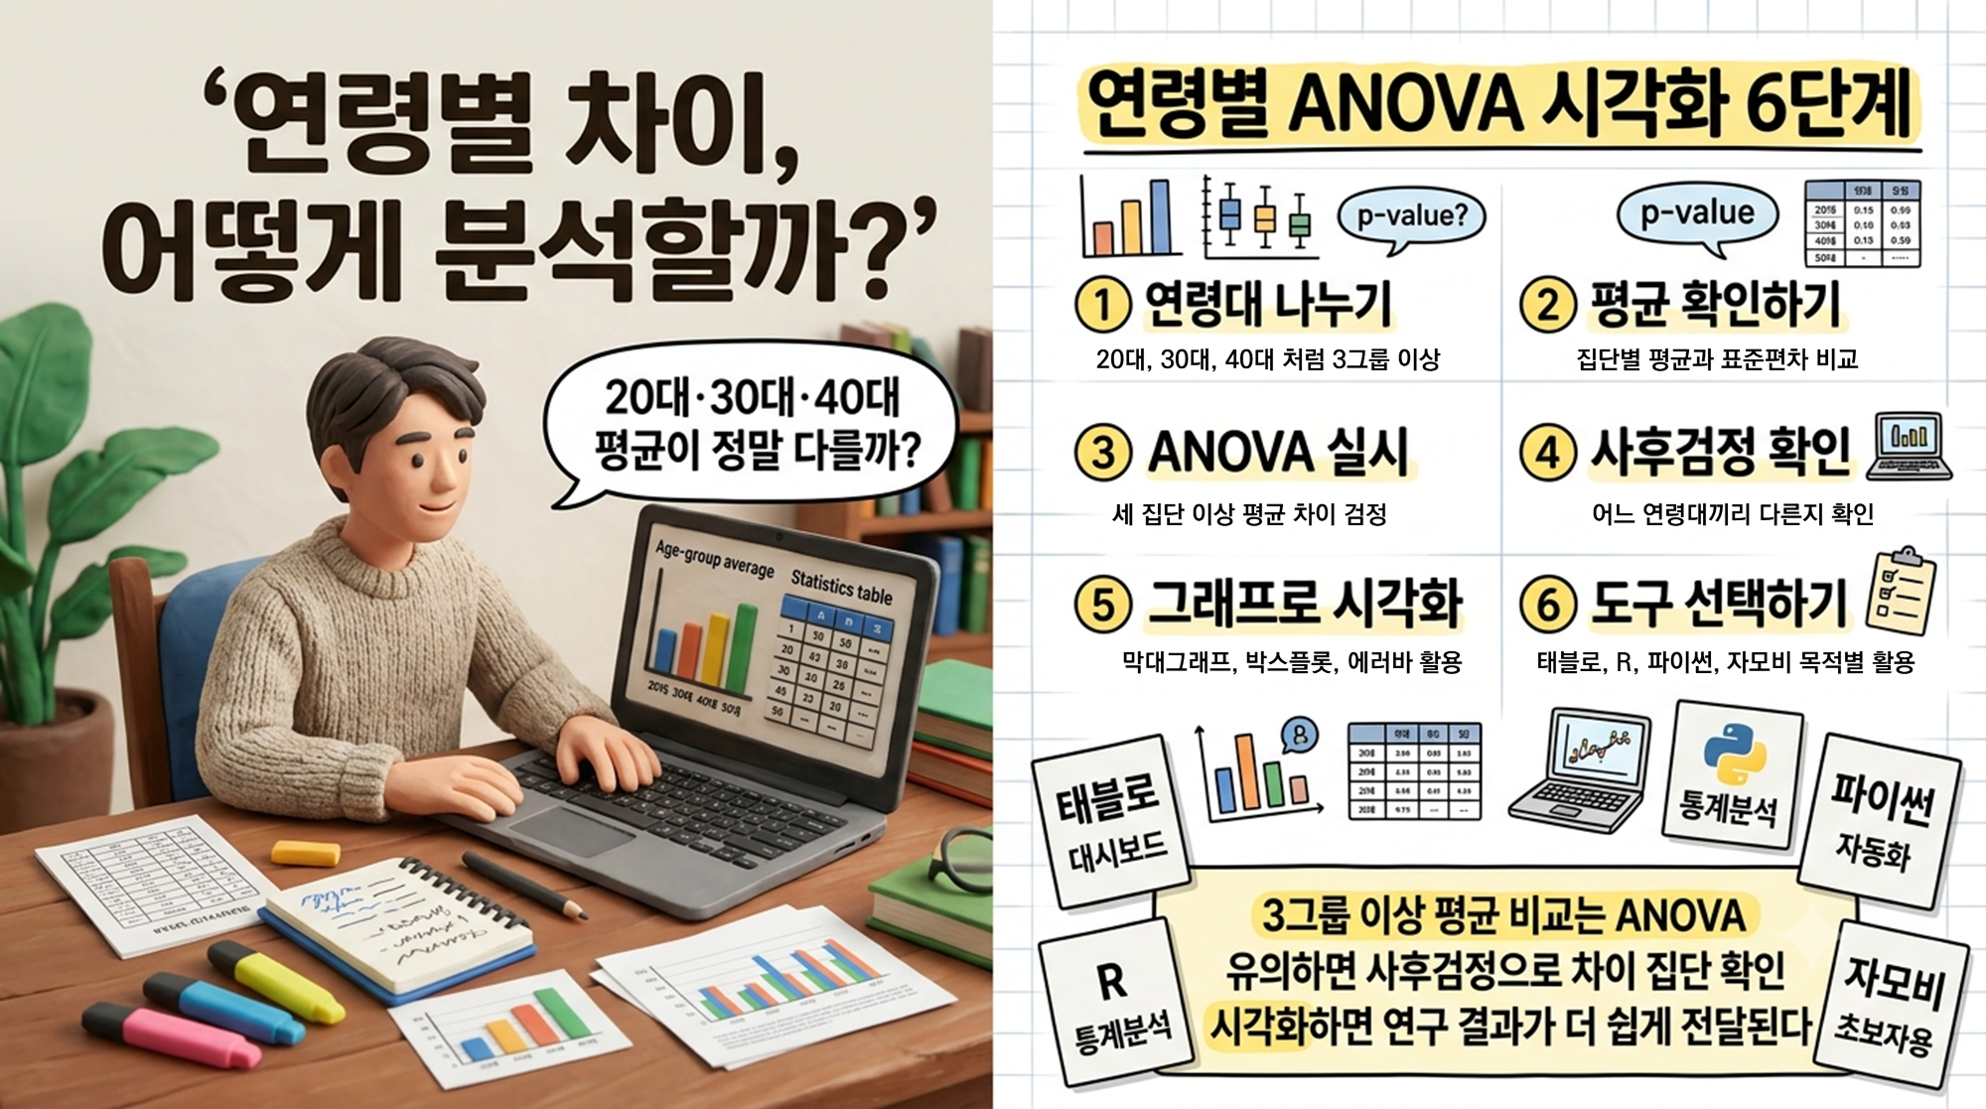
1) 세 집단 이상의 차이를 보려고 t-검정을 3번 반복해서 돌리면 제1종 오류(Type I Error)가 누적되어 왜곡이 발생한다. 반드시 ANOVA(분산분석)와 사후검정(Post-hoc test)을 거쳐야 한다.
2) 독립변수가 범주형(예: 성별, 학력)인데 일반 다중회귀분석을 돌리려면 반드시 더미변수(Dummy Variable) 처리를 해야 한다.
실무 연구 시나리오: 회귀분석 vs 구조방정식모델(SEM) 👩💼👨💻
많은 연구자분들이 회귀분석과 SEM(구조방정식) 사이에서 가장 큰 고민을 한다.
"둘 다 인과관계를 보는 건데, 굳이 복잡한 SEM을 돌려야 하나요?"라는 질문을 정말 많이 받는다. 결정적 차이는 '측정 오차 통제'와 '동시 검증 능력'에 있다.
1. 독립변수, 매개변수, 종속변수와 같이 변수가 동시에 원인이자 결과가 되는 복합 경로가 존재할 때
2. 설문지 다문항(예: 브랜드 태도 4문항, 신뢰도 5문항)의 측정 오차(Measurement Error)를 제거하고 순수한 잠재개념 간 계수를 얻고자 할 때
3. 모델 전체의 적합도 지수(CMIN/DF, CFI, TLI, RMSEA 등)를 종합적으로 입증해야 할 때
실전 예시: 논문 가설과 분석 매핑 사례 📚
실제 프랜차이즈 카페 고객 만족도 연구를 진행한다고 가정하고, 가설 설계부터 분석 기법 매핑까지 전개해보겠다.
연구 배경 및 수집 데이터
- 변수 A: 성별 (남성/여성 - 명목척도 2개)
- 변수 B: 방문 빈도 (월 1~2회, 주 1~2회, 주 3회 이상 - 서열/명목척도 3개)
- 변수 C, D, E: 서비스 품질(원인), 고객 만족도(매개), 재방문 의도(결과) - 각 4~5문항 리커트 5점 척도
가설별 기법 매핑 프로세스
가설 1: "성별에 따라 고객 만족도에 차이가 있을 것이다." 독립표본 t-검정 (2개 집단 평균 비교)
가설 2: "방문 빈도 집단에 따라 재방문 의도에 차이가 있을 것이다." 일원배치 분산분석(ANOVA) (3개 집단 평균 비교)
가설 3: "서비스 품질은 고객 만족을 매개로 재방문 의도에 유의한 영향을 미칠 것이다." 구조방정식모델(SEM) 또는 부트스트래핑 기반 매개회귀분석(Process Macro)
분석 결과 해석 방향
- t-검정 결과 p < .05 여부를 통해 집단 간 유의차 확인
- 구조방정식 모형 적합도를 먼저 입증한 뒤 경로계수(Path Coefficient)의 통계적 유의성을 해석
이처럼 연구 모델이 복잡해 보여도, 각 가설의 문장 구조를 뜯어보면 매핑해야 할 통계 기법은 단 하나로 귀결된다. 변수 유형을 명확히 정의하는 순간 고민의 90%는 해결되는 셈이다.
핵심 내용 요약 📝
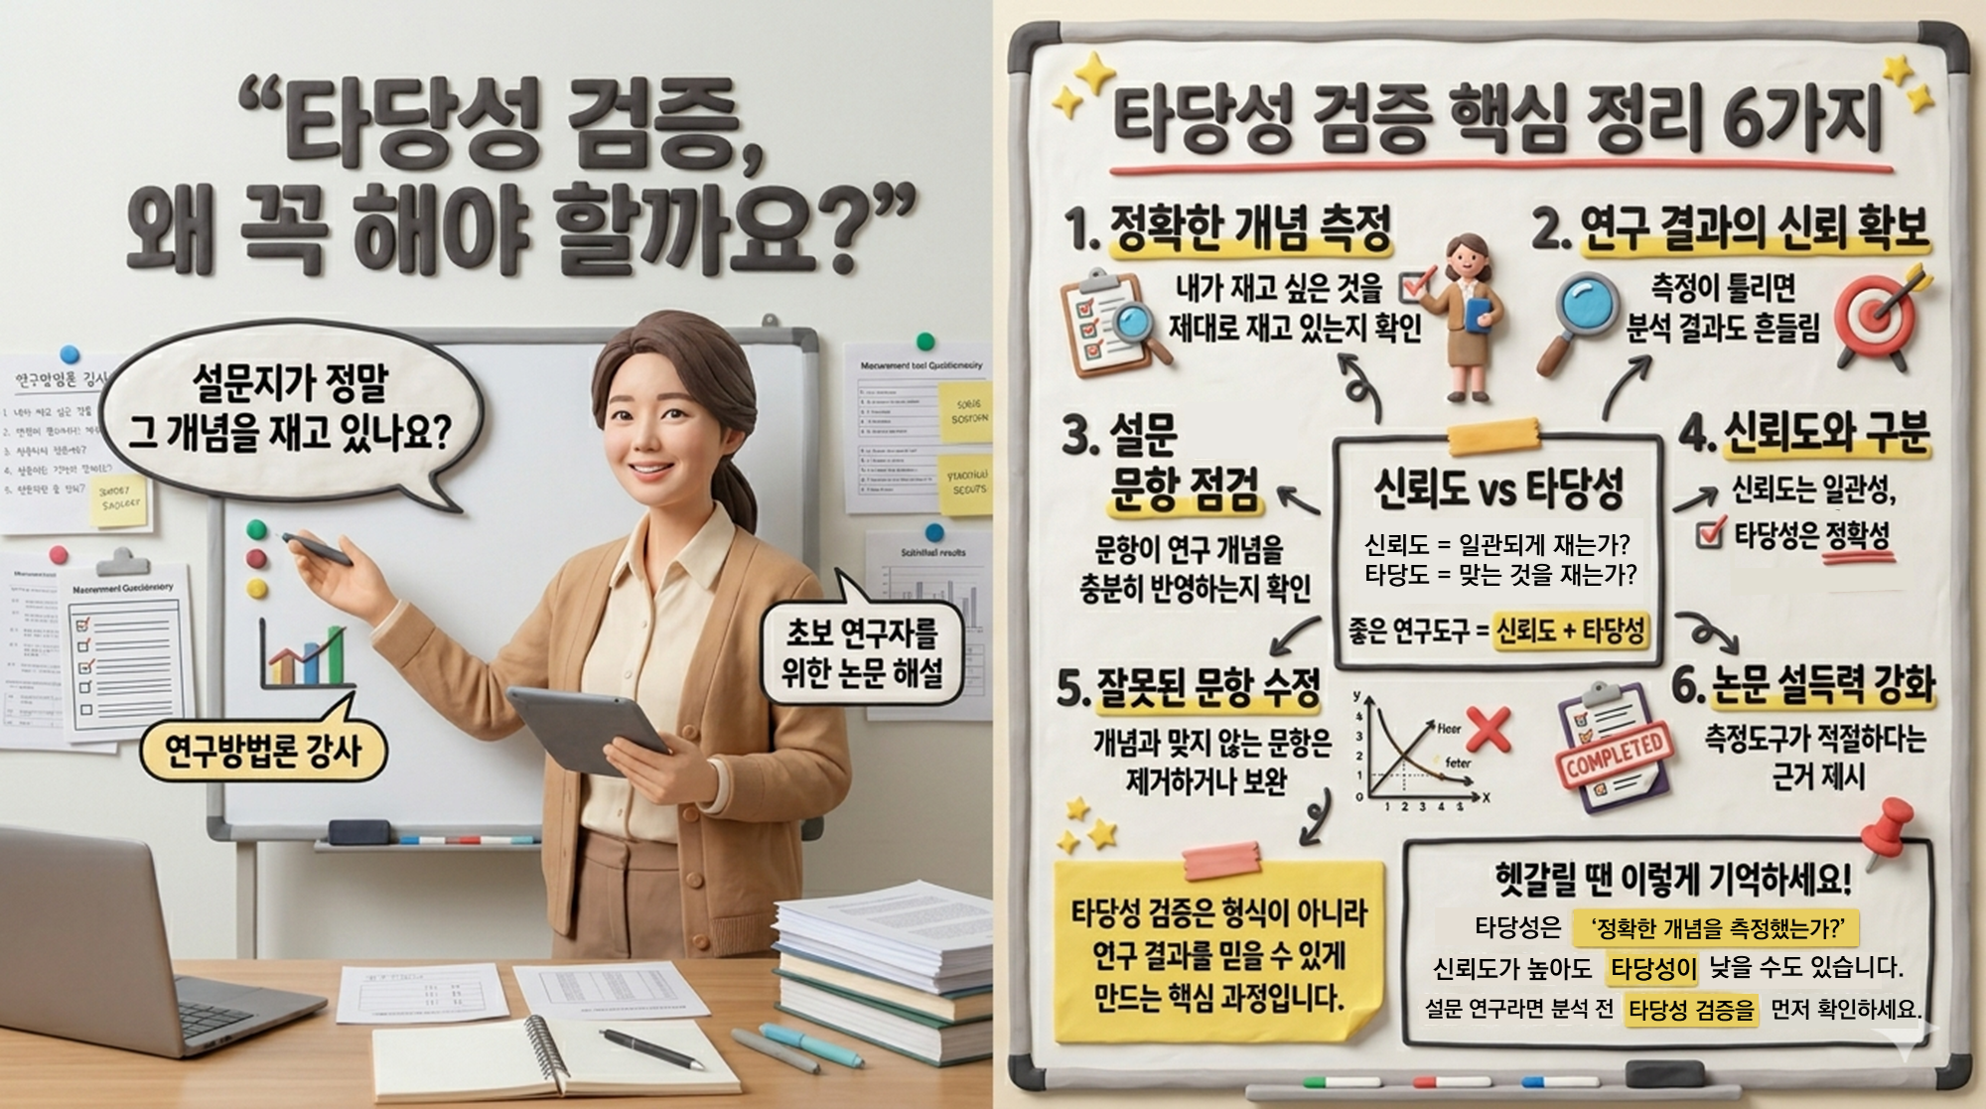
논문 통계 분석 기법의 선정은 가설의 타당성을 입증하는 뼈대이자 연구의 신뢰도를 좌우하는 나침반이다.
아무리 복잡한 데이터 분석이라도 기본 공식은 동일합니다. 여러분의 연구 모델 속 독립변수와 종속변수 척도를 다시 한번 점검해보자.
가설-통계기법 매핑 핵심 요약
자주 묻는 질문 ❓
'연구데이터분석' 카테고리의 다른 글
| 데이터 시각화 연구 완벽 정리 : 질적 연구 접근법 (0) | 2026.07.31 |
|---|---|
| 데이터 시각화 연구 완벽 정리 : 양적 연구 접근법 (0) | 2026.07.25 |
| 목적에 맞는 시각화 차트 고르는 방법 (0) | 2026.07.21 |
| 막대그래프의 모든 것: 종류, 장점, 그리고 올바른 쓰임새 (0) | 2026.07.17 |
| 논문 쓸 때 매번 헷갈리는 표(Table)와 그림(Figure) 제목 위치, 완벽 정리 (0) | 2026.07.06 |