연구를 진행하거나 논문을 쓰다 보면 성별, 학력, 지역, 소속 기업 규모 같은 질적 자료를 회귀분석 모델에 어떻게 넣어야 할지 막막했던 적이 있으셨을 거다.
숫자로 측정되지 않는 문자를 통계 패키지가 바로 계산해줄 수는 없으니까요....
저 역시 학위 논문을 작성하던 시절, 범주형 변수를 그냥 1, 2, 3으로 입력했다가 엉뚱한 계수가 나와 당황했던 경험이 생생하다.
오늘은 질적 데이터를 정량적 분석 모델의 강력한 독립변수로 탈바꿈시키는 마법의 열쇠, 바로 더미변수(Dummy Variable)의 개념과 실전 연구 활용법을 상세히 살펴보자! 😊
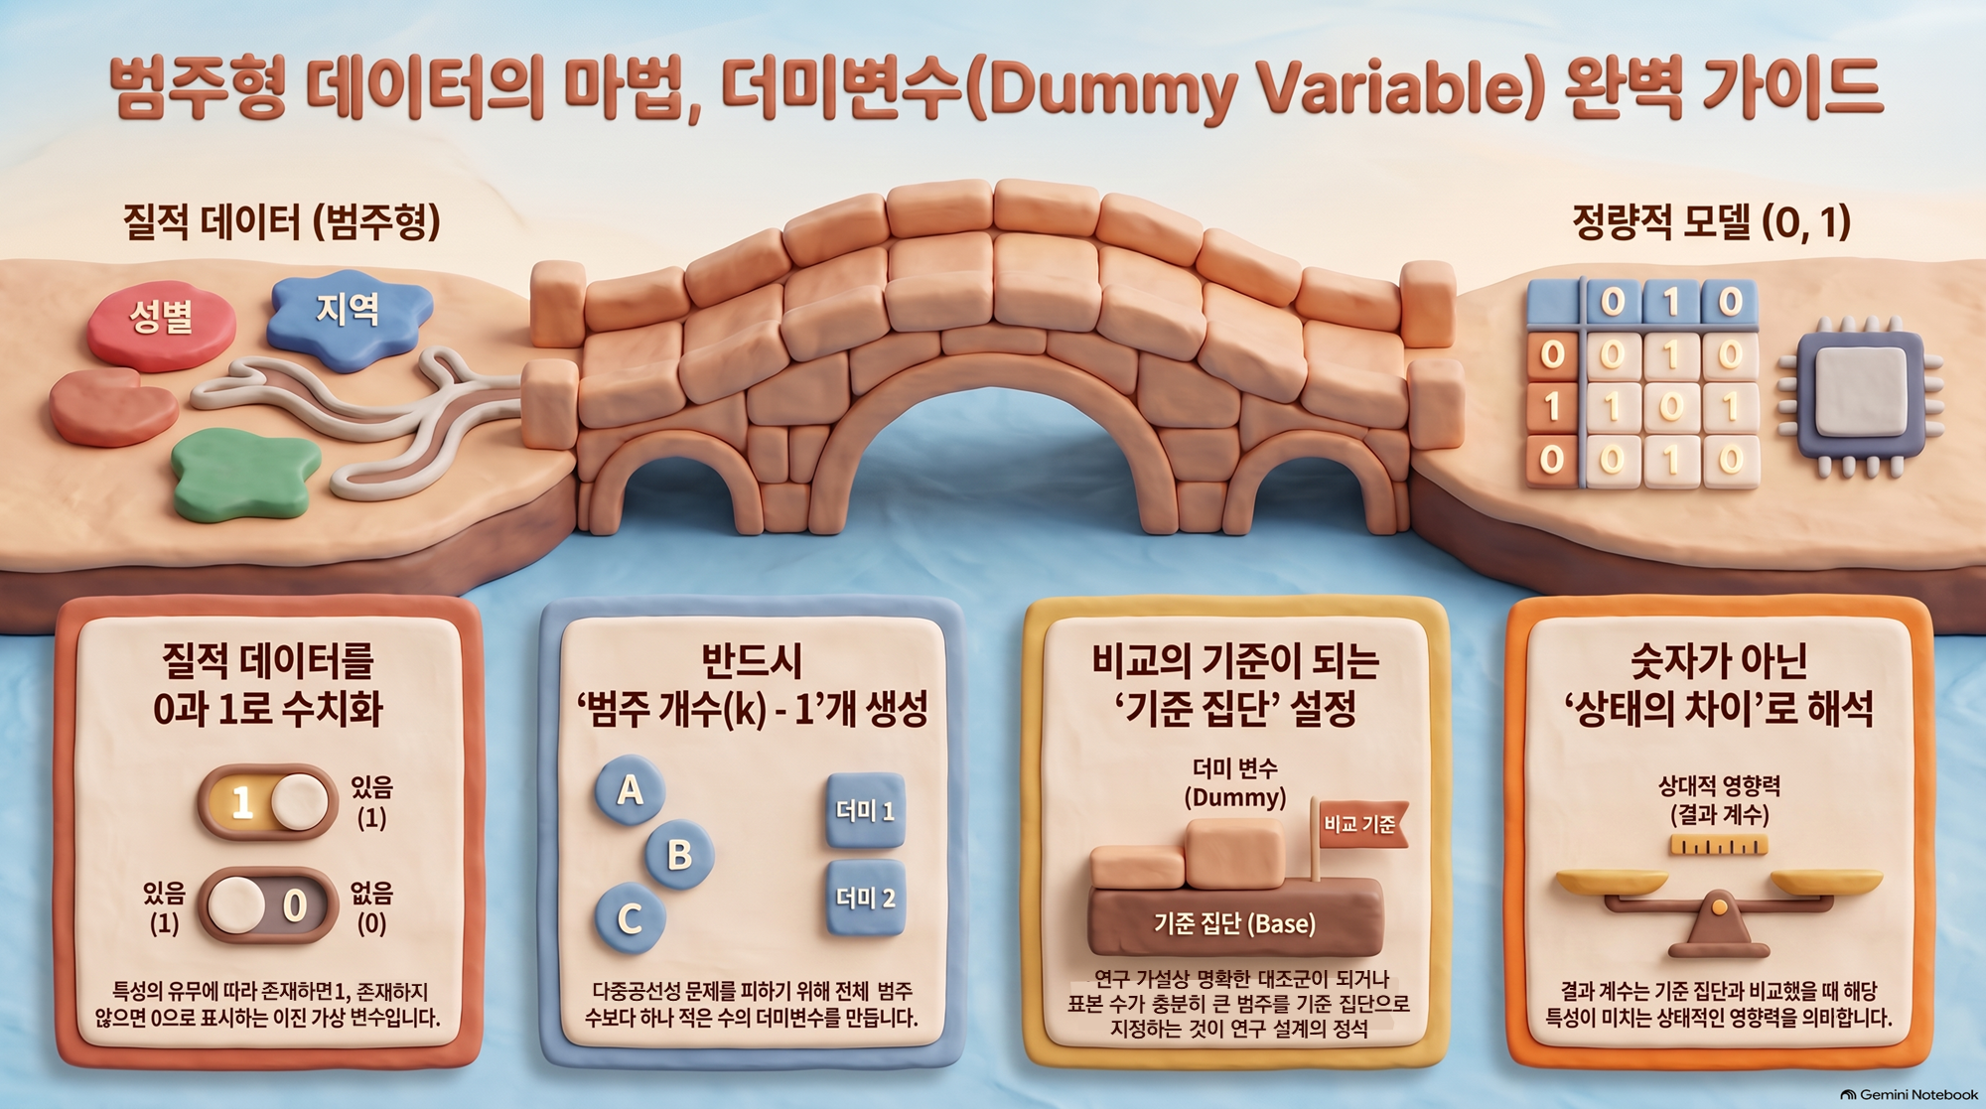
1. 더미변수란 무엇인가? 기본 개념 잡기 🤔
더미변수는 쉽게 말해 '어떤 특성이 존재하는가(1) 혹은 존재하지 않는가(0)'만을 나타내는 이진(Binary) 가상 변수이다.
통계 분석의 회귀분석(Regression Analysis)은 기본적으로 연속형 수치 데이터를 전제로 설계되어 있다.
하지만 현실 연구의 중요한 설명변수 중 상당수는 '수도권/비수도권', '정규직/비정규직', '대기업/중소기업'처럼 성질이나 종류를 나타내는 질적 범주(Categorical Data) 형태를 뛴다.
만약 학력을 고졸=1, 대졸=2, 대학원졸=3으로 코딩하여 회귀분석에 그대로 넣는다면 어떤 오류가 생길까?
모델은 고졸에서 대졸로 갈 때의 차이와 대졸에서 대학원졸로 갈 때의 차이가 수학적으로 정확히 1단위로 같다고 잘못 가정하게 된다.
이를 해결하기 위해 각 범주의 특성 유무를 0과 1의 숫자 신호로 변환해주는 것이 바로 더미 코딩(Dummy Coding)이다.
더미변수의 값 0과 1은 수학적 수량이나 크기(크다/작다)를 의미하지 않고, 특정 속성의 '유무(Absent/Present)'를 식별하는 스위치 역할을 합니다.
2. 더미 코딩의 핵심 규칙: (k-1) 규칙과 기준 집단 📊
범주형 변수를 더미변수로 변환할 때는 철저한 수학적 규칙이 존재한다.
범주의 개수가 \(k\)개라면, 생성해야 하는 더미변수의 개수는 반드시 (k - 1)개여야 한다는 점이다.
나머지 1개의 범주는 더미변수로 만들지 않고 모델의 비교 바탕이 되는 기준 집단(Reference Group 또는 Baseline)으로 남겨둔다.
만약 3개 범주에 대해 더미변수 3개를 모두 모델에 포함하면 어떤 일이 벌어질까?
상수항과 더미변수 간의 완전한 선형종속 관계가 발생하여 역행렬을 계산할 수 없게 되는데,
이를 통계학에서는 더미변수의 함정(Dummy Variable Trap) 또는 완전 다중공선성(Multicollinearity) 문제라고 부른다.
근무지역(3개 범주)의 올바른 더미 코딩 구조
| 근무지역 범주 | 더미 1 (서울 여부, D1) | 더미 2 (경기 여부, D2) | 해석상 지위 |
|---|---|---|---|
| 지방 (기타 지역) | 0 | 0 | 기준 집단 (Reference) |
| 서울 | 1 | 0 | 지방 대비 서울의 효과 |
| 경기 | 0 | 1 | 지방 대비 경기의 효과 |
기준 집단을 무엇으로 설정하느냐에 따라 더미변수 회귀계수의 부호와 유의확률이 완전히 달라집니다. 연구 가설상 명확한 대조군이 되거나 표본 수가 충분히 큰 범주를 기준 집단으로 지정하는 것이 연구 설계의 정석입니다.
3. 학술연구에서의 대표적 활용 분야 👩💼👨💻
더미변수는 단순한 변수 변환을 넘어 현대 사회과학 및 경영·경제학 연구 방법론의 근간을 이룬다.
특히 정책 평가 연구에서 널리 쓰이는 이중차분법(DID; Difference-in-Differences)은 더미변수의 꽃이라고 불린다.
처치집단 더미(Treatment Dummy)와 정책시행 사후 더미(Post Dummy)의 상호작용항 계수가 순수한 정책 처치효과를 나타내기 때문이다.
1. 패널데이터 분석의 고정효과 모델(Fixed Effects Model): 시간 불변의 개별 특성을 제거하기 위한 개체 더미 및 시점 더미 투입
2. 사건연구(Event Study): 인수합병(M&A), 신제품 발표 등 특정 이벤트 발생 전후의 비정상수익률 측정
3. 로짓/프로빗 회귀분석: 부도 여부(0/1), 구매 전환 여부(0/1) 등 종속변수 자체를 더미변수로 설정하는 이항 반응 모델
실전 예시: 스타트업 R&D 지원 정책의 효과성 검증 연구 📚
이해를 돕기 위해 정부의 창업 연구개발(R&D) 지원금 수혜가 벤처기업의 특허 출원 수에 미치는 영향을 검증하는 실제 논문 모형 사례를 살펴보자.
연구 설계 및 가설 모형
- 종속변수: 연간 특허 출원 수 (건)
- 핵심 설명변수: R&D 지원 수혜 더미 (지원받음=1, 미지원=0)
- 통제변수: 기업 업력(년), 연구원 수(명), 자본금(억 원)
회귀분석 추정 결과
1) 회귀모형: 특허수 = 1.20 + 2.85 × (R&D수혜더미) + 0.15 × (연구원수) + 통제변수들
2) R&D 수혜 더미 계수(\(\delta\)): +2.85 (\(p < 0.01\))
최종 연구 시사점
- 기업 업력과 연구원 수 등 기업 고유 특성을 통제하고도, 정부 R&D 지원을 받은 기업은 그렇지 않은 기업에 비해 연간 특허 출원 수가 평균 2.85건 더 많았습니다.
- 이처럼 더미변수를 활용하면 질적인 정책 개입 여부의 순수 기여도를 수치로 명확하게 입증할 수 있습니다.
결국 더미변수는 복잡하고 질적인 현실 세계의 다양한 조건들을 통계 모델이라는 수학적 구조물에 매끄럽게 연결해주는 핵심 다리 역할을 수행한다.
핵심 내용 요약 📝
오늘 정리한 더미변수의 본질과 활용법을 요약하면 다음과 같습니다. 연구 설계를 할 때 범주형 변수를 마주한다면 주저하지 말고 더미 코딩을 적용해 보세요.
- 질적 자료의 정량화: 0과 1의 이진 코딩을 통해 범주형 데이터를 회귀분석에 투입 가능하도록 변환합니다.
- k-1 규칙 준수: 다중공선성 문제를 피하기 위해 범주 수보다 1개 적게 더미를 만들고, 1개는 기준 집단으로 둡니다.
- 계수의 차별적 해석: 절편 더미는 기본 수준의 평균 차이를, 상호작용 더미는 기울기(효과의 크기) 차이를 검증합니다.
더미변수를 올바르게 코딩하고 해석하는 것만으로도 학술 연구와 데이터 분석의 신뢰도는 한 단계 도약할 수 있다. 😊