빅데이터 분석과 대학원 석·박사 논문 컨설팅을 오랫동안 진행하다 보면, 통계 프로그램을 돌려보고 무척 상기된 표정으로 찾아오시는 연구자분들을 정말 자주 뵙게 된다.
"대표님! 독립변수와 종속변수 간 피어슨 상관계수가 무려 0.85가 나왔습니다. 가설대로 인과관계가 확실하게 입증된 것 맞죠?"라며 기뻐하시죠. 😊
하지만 안타깝게도 제 답변은 늘 냉정할 수밖에 없다.
"아닙니다. 그것은 두 변수가 함께 움직인다는 증거일 뿐, 인과관계의 증거는 전혀 되지 못합니다."
학술지 심사위원들이 논문 프로포절이나 본심사에서 가장 날카롭게 지적하는 단골 지적 사항이기도 하다. 과연 왜 높은 상관계수가 결코 인과관계를 입증하지 못하는지, 그리고 회귀계수와는 수학적·구조적으로 무엇이 다른지 하나씩 짚어보겠다.
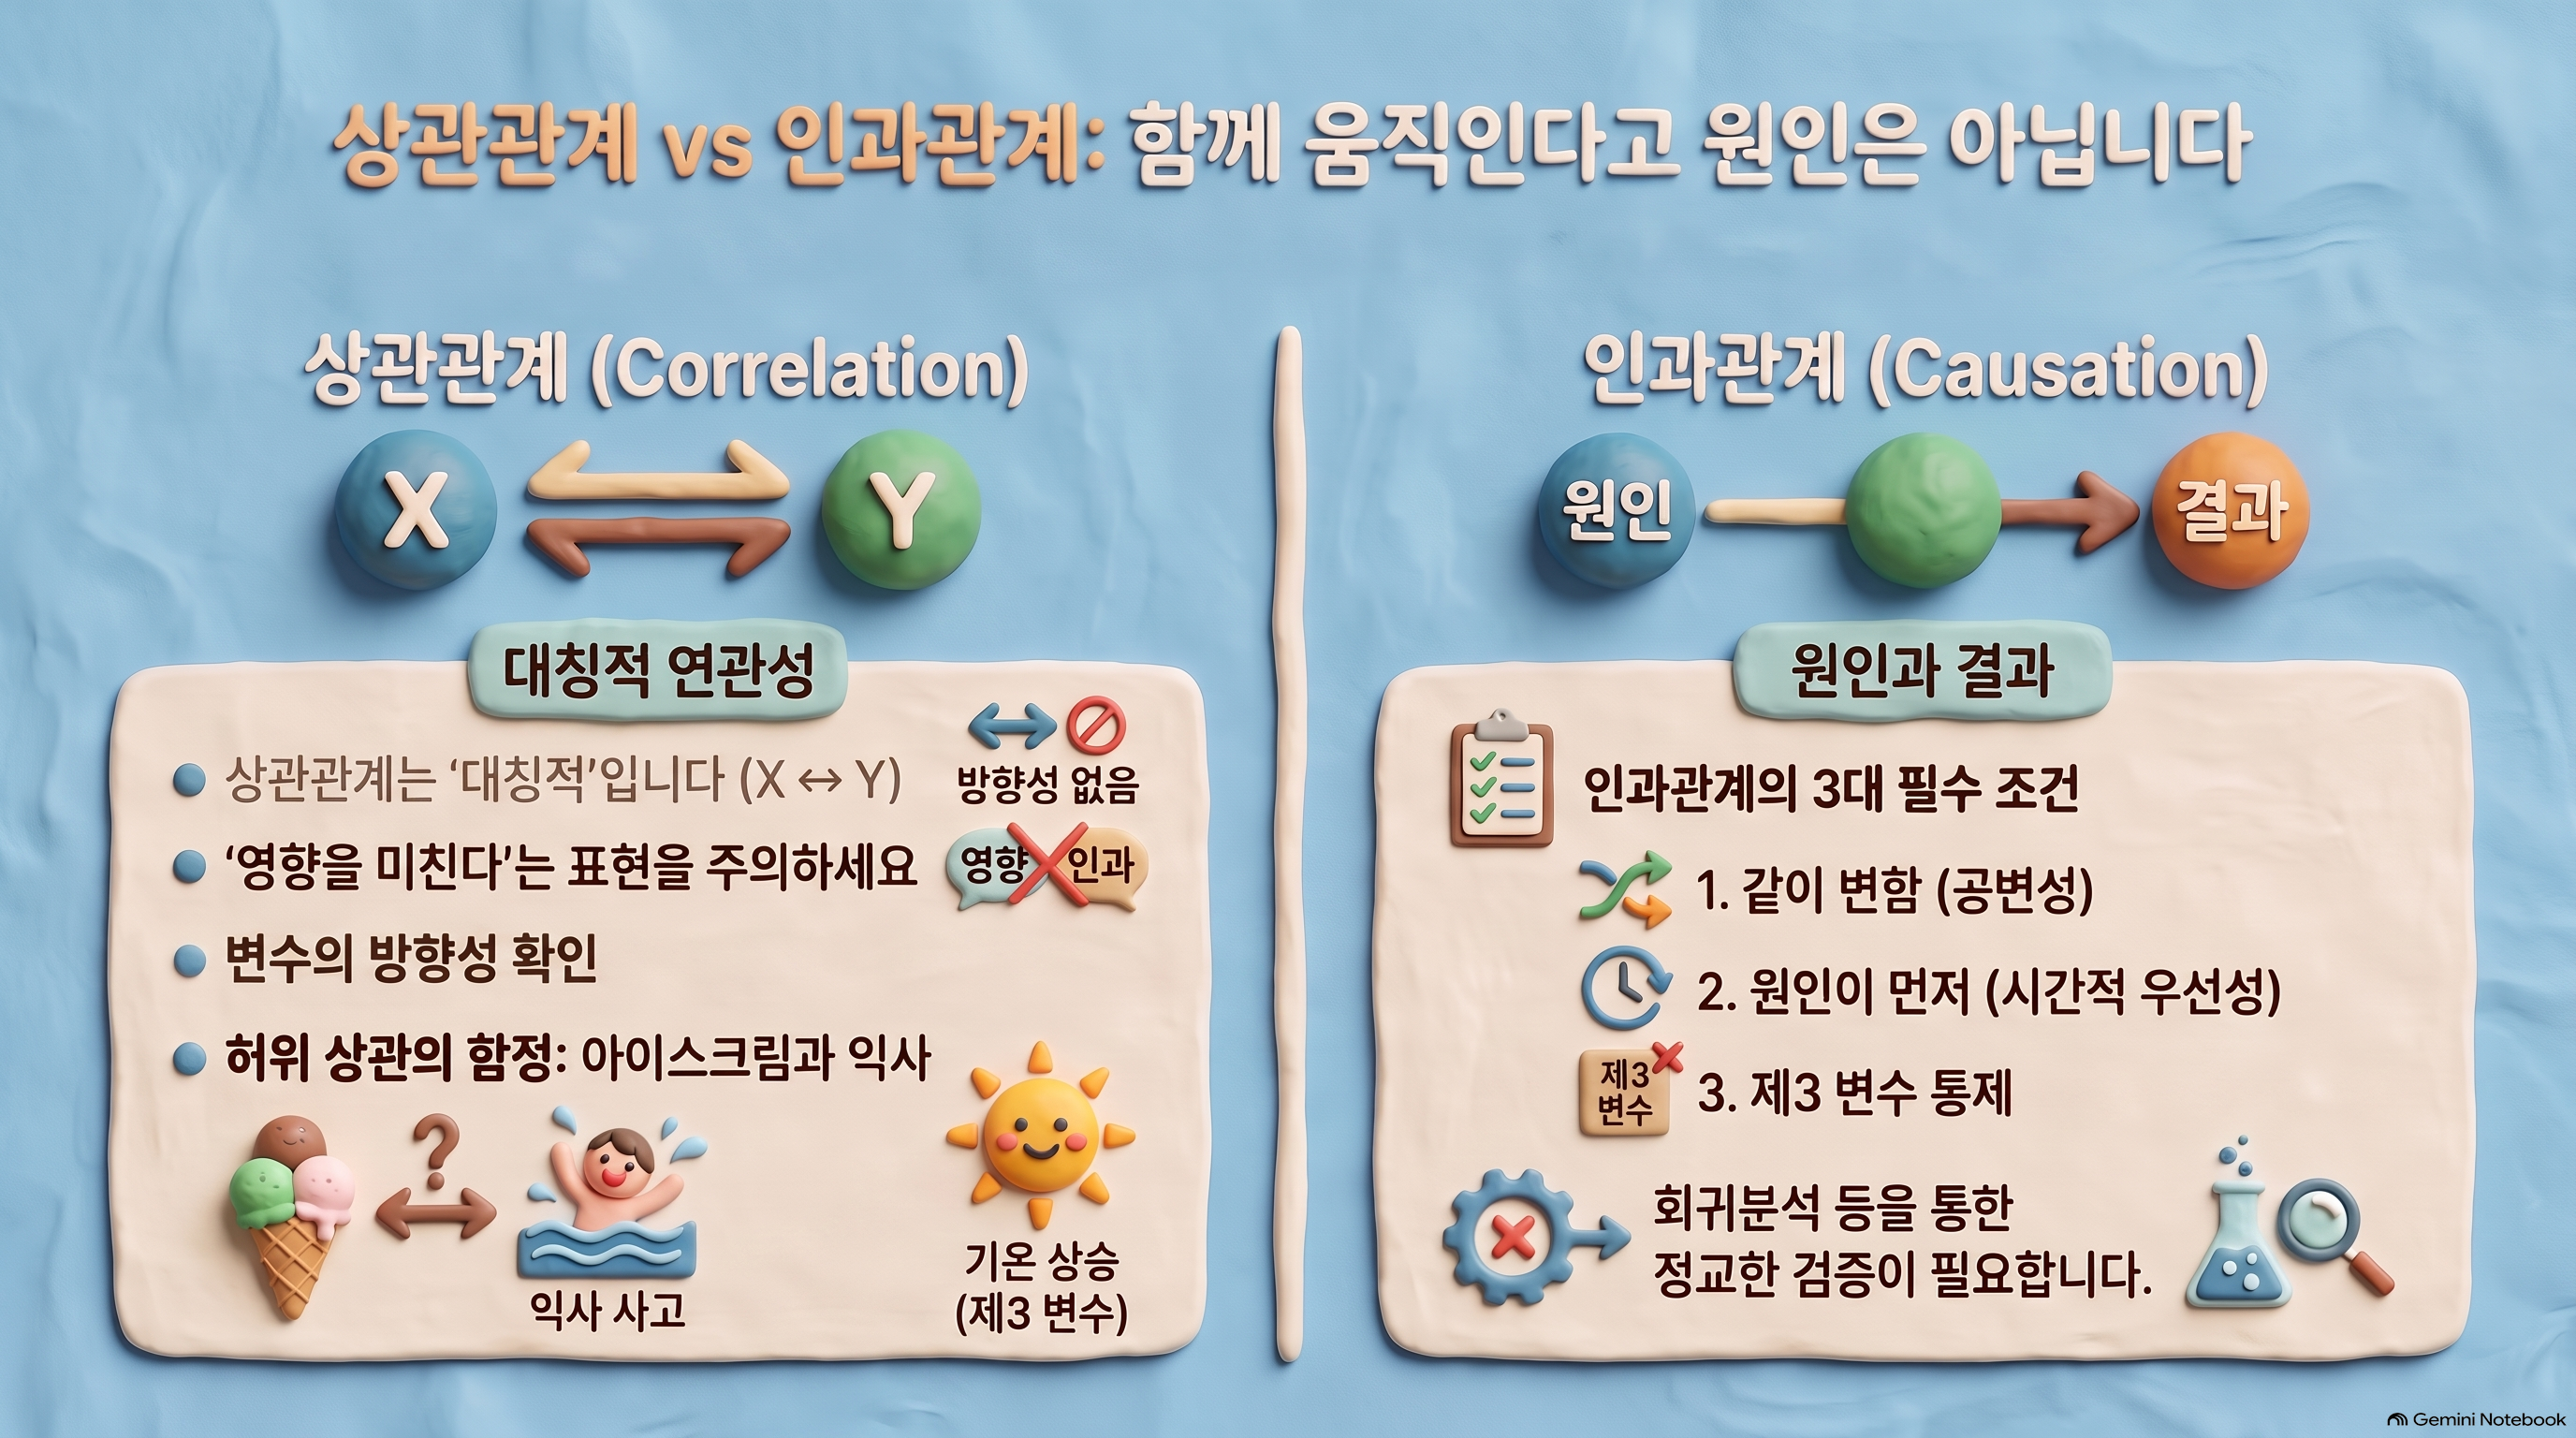
1. 피어슨 상관분석: '방향 없는 연관성'의 한계 🤔
피어슨 상관분석(Pearson Correlation Analysis)에서 산출되는 상관계수는 정규분포를 따르는 두 연속형 변수 간의 선형적 연관성의 강도와 방향만을 측정하는 무차원 표준화 지수이다.
값의 범위는 -1에서 +1 사이에 위치한다.
여기서 핵심은 상관계수의 완벽한 '대칭성(Symmetry)'에 있다.
변수 X와 변수 Y의 상관계수는 변수 Y와 변수 X의 상관계수와 완전히 동일합니다. 즉, 상관분석 알고리즘 내부에는 "누가 원인이고 누가 결과인가"를 식별할 수 있는 축 자체가 아예 존재하지 않는다.
상관계수는 두 변수 간 공분산(Covariance)을 각 변수의 표준편차의 곱으로 나눈 수치이다. 수학적으로 분모와 분자 모두에서 변수의 위치를 바꾸어도 결과값이 동일하므로, '원인(Cause)'과 '결과(Effect)'라는 시간적·논리적 비대칭성을 절대 반영할 수 없다.
2. 통계학적 인과관계의 3대 필수 조건 📊
통계학과 계량경제학, 연구방법론에서 과학적 인과관계를 성립시키기 위해서는 다음 세 가지 조건이 단 하나도 빠짐없이 동시에 충족되어야만 한다. 단순 상관계수는 이 중 겨우 첫 번째 요건만 만족할 뿐이다.
- 1) 공변 관계(Covariation): 원인 변수 X가 변할 때 결과 변수 Y도 함께 일정한 패턴으로 변화해야 한다. (상관관계가 확인해 주는 유일한 영역)
- 2) 시간적 우선성(Temporal Precedence): 원인 변수 X의 발생 시점이 결과 변수 Y의 발생 시점보다 반드시 시간상 앞서야 한다.
- 3) 외생변수의 통제(Non-spuriousness): 제3의 혼란변수(Confounding Variable)나 외생적 요인에 의해 두 변수 간의 관계가 왜곡되거나 허위로 나타난 것이 아니어야 한다.
동일한 시점에 설문지를 배포하여 회수한 횡단면 데이터(Cross-sectional data) 기반의 상관분석은 시간적 우선성을 입증할 수 없으며, 제3의 잠재 변수를 통제할 수학적 기제도 전혀 갖추고 있지 못한다.
상관분석 vs 회귀분석의 본질적 차이 비교
| 비교 항목 | 피어슨 상관분석 (Correlation) | 단순/다중 선형회귀분석 (Regression) |
|---|---|---|
| 분석의 목적 | 두 변수 간 선형적 연관성의 강도 및 방향 측정 | 독립변수가 종속변수에 미치는 영향력 추정 및 예측 |
| 변수 간 관계 | 대칭적 관계 | 비대칭적 인과 모형 |
| 제3변수 통제 | 불가능 (단순 이변량 분석) | 가능(통제변수를 모형에 투입하여 부분 효과 추정) |
| 핵심 산출 지수 | 상관계수 ($r$, 무차원 지수) | 비표준화 계수, 표준화 회귀계수 |
여름철 아이스크림 판매량과 익사 사고 사망자 수는 매우 높은 양(+)의 상관계수(r > 0.8)를 보인다. 하지만 아이스크림이 익사 사고를 유발하는 인과관계는 아니다. 배후에 '기온 상승'이라는 제3의 외생변수가 숨어있기 때문이다. 이를 통계학에서는 허위 상관(Spurious Correlation)이라 부른다.
3. 연구 논문 작성 시 자주 범하는 논리적 오류 👩💼👨💻
학위논문이나 등재학술지(KCI) 투고 시 가장 엄격하게 검증받는 부분이 연구가설의 서술 방식이다.
상관분석 결과표를 제시하면서 인과적 표현을 사용하는 것은 치명적인 결격 사유가 된다.
예를 들어, "직무스트레스는 이직의도에 유의미한 정(+)의 영향을 미칠 것이다"라는 가설을 세워놓고 상관분석의 r=0.62(p < .001)만으로 가설을 채택하면 즉시 수정 보완 지시가 떨어진다.
상관분석은 단지 "두 변수 간에 통계적으로 유의한 정적 상관관계가 존재한다"고만 서술해야 한다.
회귀분석에서도 회귀계수의 유의성이 확보되었다고 해서 기계적으로 인과관계가 자동 입증되는 것은 아닙니다. 탄탄한 선행 연구 고찰과 이론적 배경(Theoretical Framework)이 뒷받침되어야 비로소 계량 모형의 결과가 인과적 논리로 정당화될 수 있습니다.
4. 실전 분석 사례: 연구 데이터의 올바른 해석 📚
실제 중소기업 구성원 300명을 대상으로 수집한 직무 환경 데이터의 분석 결과를 바탕으로, 분석 기법에 따른 해석의 차이를 구체적으로 비교해 보겠다.
실제 분석 수치 데이터
- 변수: 근로시간(X_1), 조직몰입도(X_2), 이직의도(Y)
- 피어슨 단순상관: 근로시간과 이직의도 r = 0.58 (p < .01)
- 다중회귀분석: 조직몰입도 통제 후 근로시간의 표준화 계수 beta = 0.18 (p = .12)
분석 및 해석 비교
1) 상관분석 해석: 근로시간이 길수록 이직의도가 높아지는 경향이 있음 (단순 공변성 확인)
2) 다중회귀 해석: 조직몰입도를 통제했을 때 근로시간이 이직의도에 미치는 직접적 영향은 통계적으로 유의하지 않음
연구적 시사점
- 단순 상관계수만 보고 "근로시간 단축이 이직 방지의 직접적 원인이다"라고 결론지으면 잘못된 정책 수립을 초래한다.
- 실질적으로는 근로시간이 조직몰입도를 저하시키고, 낮아진 몰입도가 이직의도를 높이는 매개 구조일 가능성을 파악할 수 있다.
이처럼 상관분석에만 머무르면 데이터 이면에 존재하는 정밀한 동적 구조를 놓치기 쉽다. 따라서 논문의 모형 설계 단계에서부터 이론적 인과 모형을 구축하고 다중회귀, 매개·조절 효과 분석, 혹은 구조방정식 모형(SEM)으로 확장해 나가는 체계적인 접근이 필수적이다.
핵심 내용 요약 📝
데이터는 거짓말을 하지 않지만, 연구자가 잘못된 통계적 프레임으로 데이터를 바라보면 왜곡된 진실을 보게 된다. 높은 상관계수를 인과관계의 완성으로 오판하지 않는 것이 데이터 과학과 학술 연구의 가장 중요한 첫걸음이다.😊
상관과 인과의 핵심 가이드
자주 묻는 질문 ❓
'연구데이터분석' 카테고리의 다른 글
| 설문 응답 이상치, 결측값 완벽 정제 기준 (0) | 2026.09.29 |
|---|---|
| 요인분석 문항 제거, 요인 적재량 0.5 미만은 무조건 삭제해야 할까? (0) | 2026.09.28 |
| 크론바흐 알파(Cronbach's α) 0.6 이하일 때 긴급 대처법 4단계 (0) | 2026.09.27 |
| p값 0.05 초과로 가설 기각 시 설문조사 다시 해야 할까? 명쾌한 대처법 (0) | 2026.09.26 |
| "내 데이터는 어떤 분석을 돌릴까?" 척도와 통계 기법 매핑 (0) | 2026.09.25 |