학위 논문이나 연구 보고서를 준비할 때 가장 답답한 표본 수(N수) 결정 기준을 명쾌하게 정리해 드립니다. G*Power(지파워) 설정값부터 모집단 산출 공식까지 한 번에 확인하고 연구의 신뢰도를 확실하게 확보해 보세요!
연구자분들과 논문 컨설팅을 진행하다 보면 열에 아홉은
"대표님, 제 설문지는 최소 몇 명한테 돌려야 통과되나요?"
라는 질문을 먼저 한다.
사실 100명이면 충분하다는 선배 말만 믿고 설문지를 돌렸다가,
막상 심사장에 들어가서 통계적 검정력(Statistical Power) 부족으로 데이터 전체를 다시 수집해야 하는 안타까운 상황도 적지 않게 봤다. 😅
표본 크기를 결정하는 일은 단순히 발품을 얼마나 파느냐의 문제가 아니다.
내가 검증하려는 가설의 통계 기법, 효과 크기, 그리고 모집단의 성격에 맞춰 과학적 근거를 제시해야 심사위원들을 완벽하게 설득할 수 있다.
통계 분석 기법별 최소 표본 수 기준 🤔
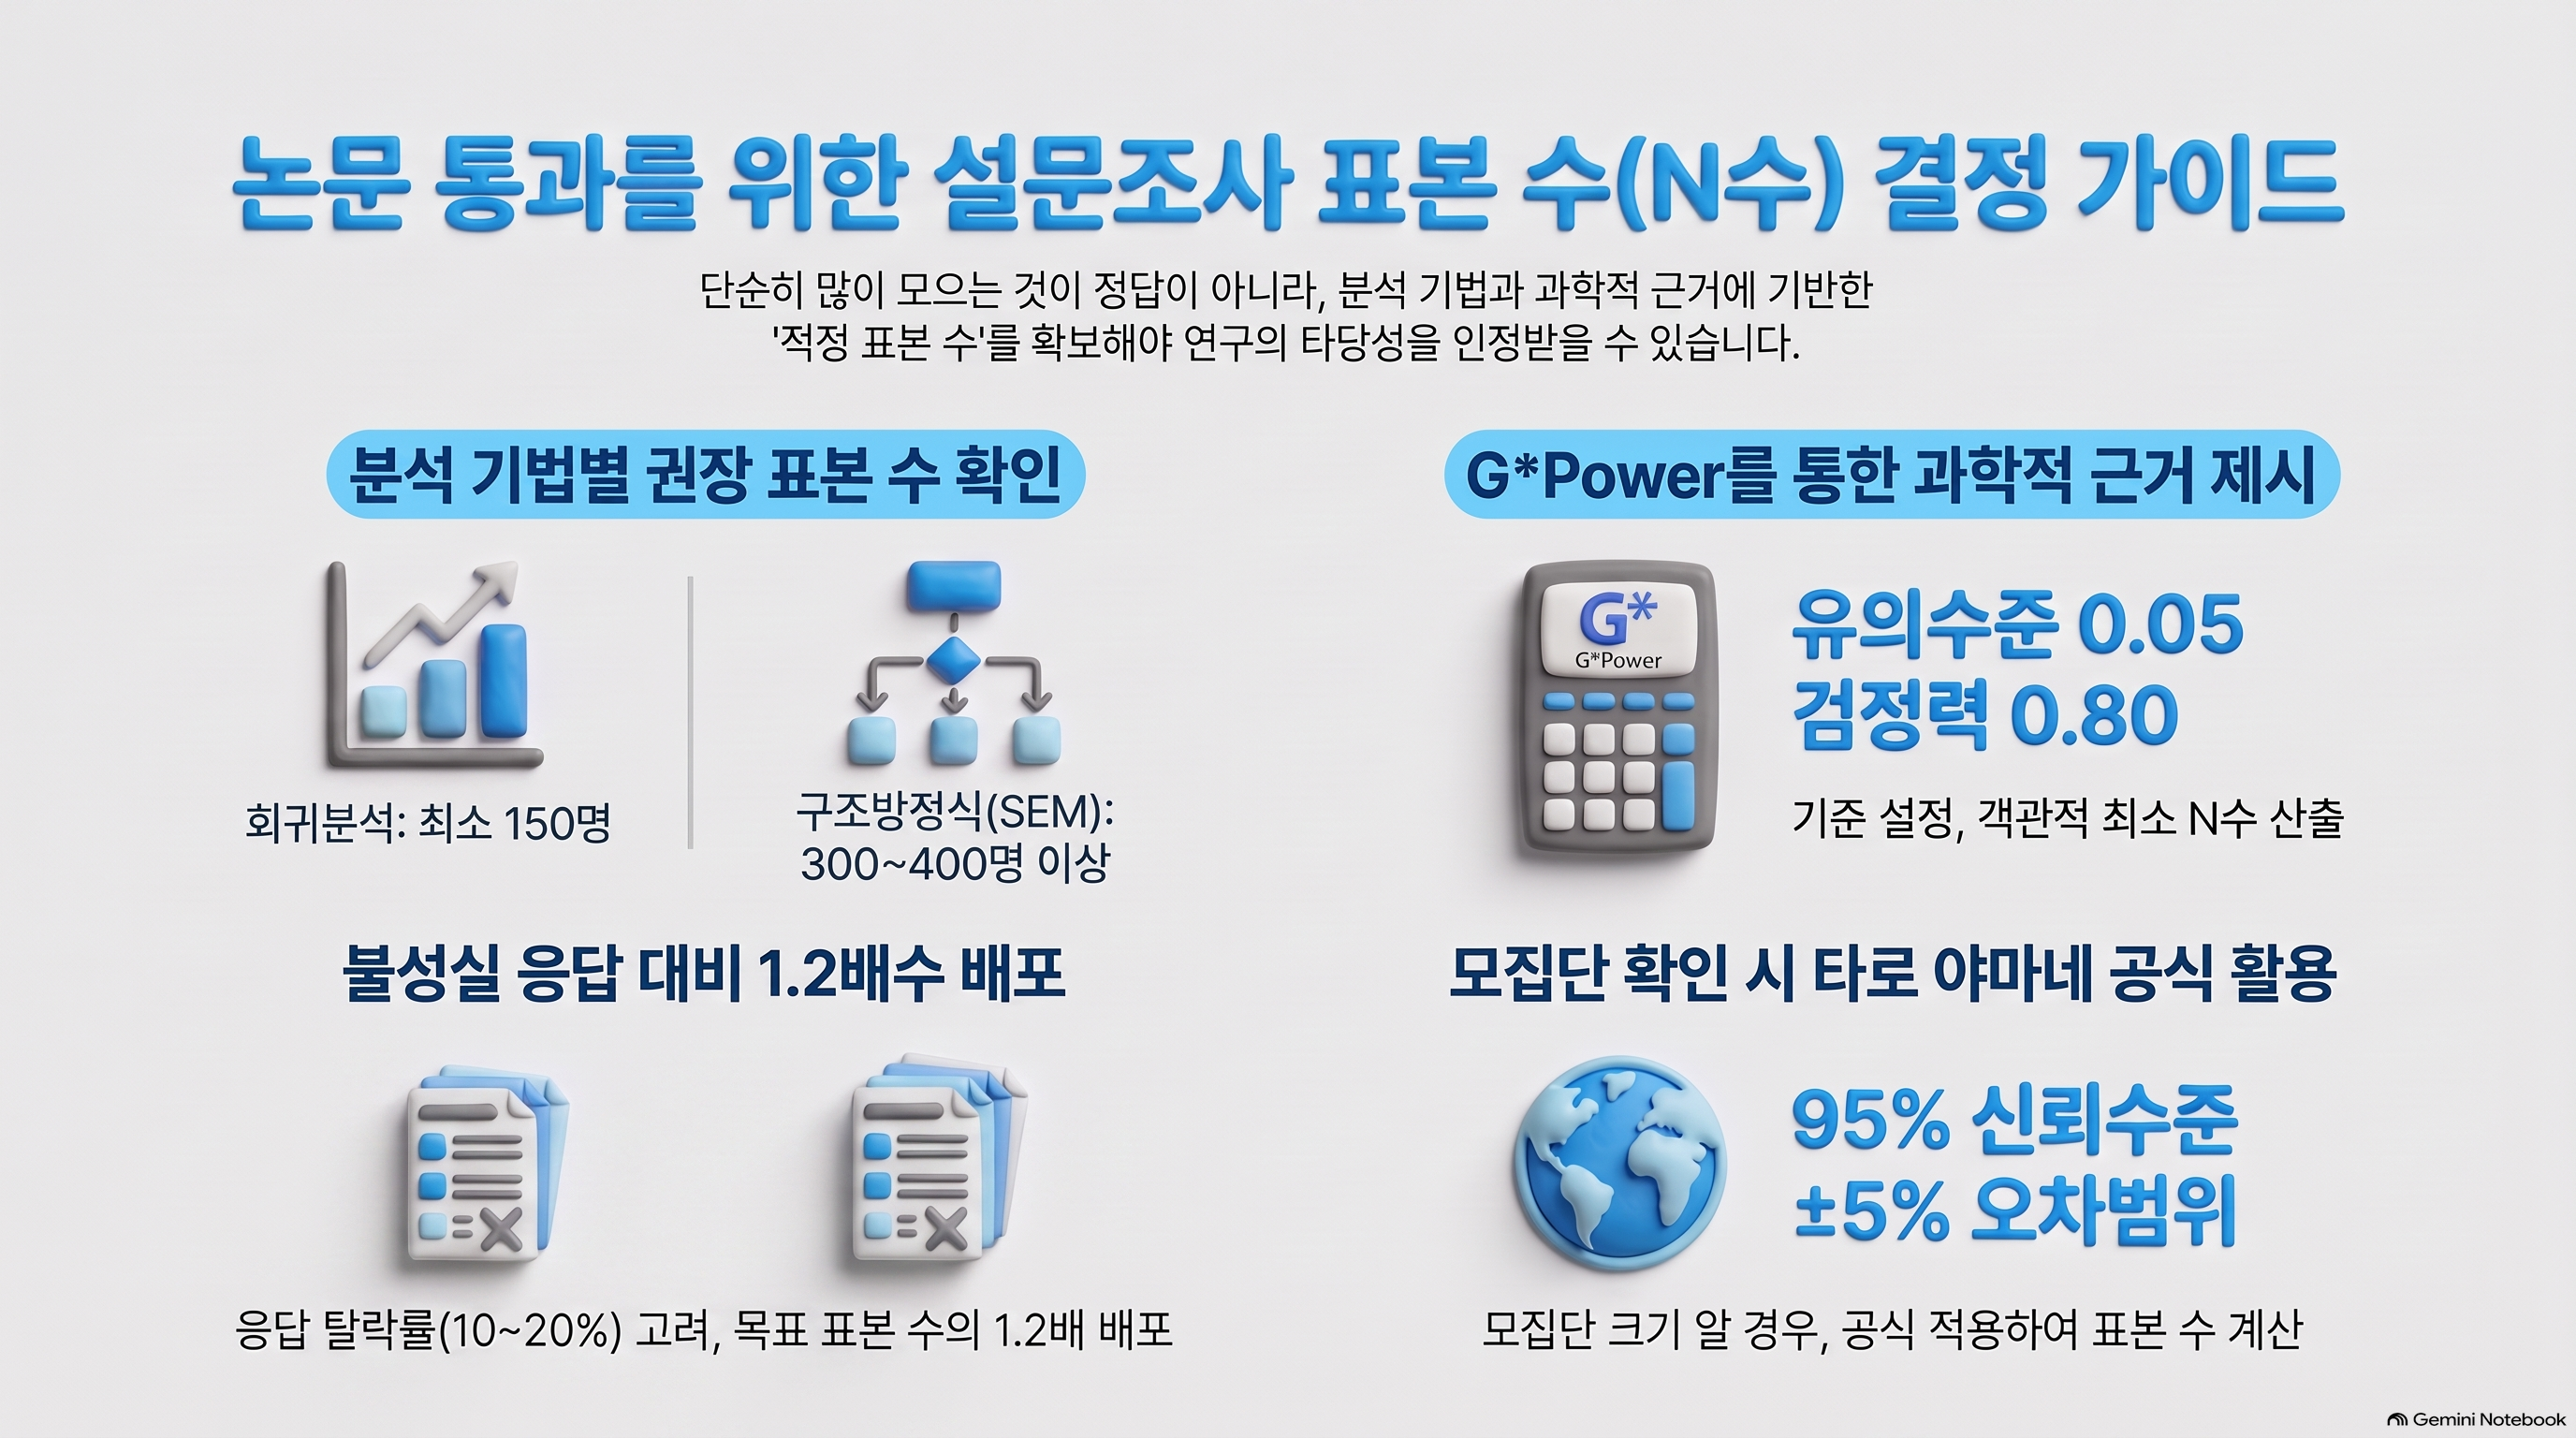
흔히 현장에서 회귀분석은 150명, 구조방정식모델(SEM, Structural Equation Modeling)은 300명 이상이어야 한다는 이야기를 들어보셨을 거다.
이러한 관례적인 기준은 통계적 추정 알고리즘이 안정적으로 수렴하기 위한 최소한의 경험 법칙(Rule of Thumb)에서 출발했다.
예를 들어 다중회귀분석(Multiple Regression Analysis)에서는 독립변수 1개당 최소 10~15개의 관측치가 필요하며, 탐색적 요인분석(EFA, Exploratory Factor Analysis)에서는 문항 수의 5~10배에 달하는 응답자가 확보되어야 요인 구조가 왜곡되지 않는다.
분석 모델의 변수 수가 많아질수록 요구되는 표본 크기는 비례해서 증가한다는 점을 꼭 기억해야 한다.
구조방정식(SEM) 분석 시 최대우도법(ML, Maximum Likelihood)을 사용할 경우 표본이 200명 미만이면 모델 적합도 지수가 지나치게 민감해지거나 공분산 행렬 오류가 발생하기 쉽다. 안정적인 경로계수 도출을 위해서는 최소 200~300명 이상을 목표로 잡는 것이 안전하다.
주요 분석 기법별 권장 표본 수 비교 📊
설문조사 설계를 시작할 때 내가 사용할 최종 통계 기법이 무엇인지 먼저 확정해야 한다.
분석 기법의 복잡도와 모수 추정 방식에 따라 필요한 데이터의 볼륨이 크게 달라지기 때문이다.
아래 표는 국내외 학술지 및 학위논문 심사에서 보편적으로 인정받는 분석 기법별 권장 표본 크기를 정리한 표이다.
주요 연구 분석 모형별 권장 표본 가이드
| 분석 기법 | 경험적 최소 기준 | 권장 표본 크기 | 주요 고려 요소 |
|---|---|---|---|
| 독립표본 t-검정 | 집단당 30명 (총 60명) | 집단당 64명 이상 | 중간 효과크기(d=0.5), 정규성 충족 |
| 일원분산분석 (ANOVA) | 집단당 20명 | 총 150~200명 내외 | 3개 이상 집단 간 분산 동질성 |
| 다중회귀분석 | 독립변수 수 × 10명 | 150명 ~ 200명 | 다중공선성 및 수정된 결정계수 안정성 |
| 구조방정식 (SEM) | 최소 200명 | 300명 ~ 400명 이상 | 잠재변수 측정 문항 수, 적합도 지수 |
설문 응답을 수집했다고 해서 전원 유효 표본이 되는 것은 아니다!
불성실 응답(중복 체크, 한 줄 밀려 쓰기, 결측치 다수 등)으로 약 10~20%가 탈락하므로, 계획 단계에서 목표 N수의 1.2배를 목표치로 설정해야 데이터 수집 실패를 방지할 수 있다.
G*Power를 활용한 사전 표본 수 산출법 🧮
학위논문이나 KCI 등재 학술지에 표본 산출 근거를 서술할 때 가장 신뢰받는 도구가 바로 독일 하인리히 하이네 대학교에서 개발한 G*Power(지파워) 프로그램이다.
통계적 검정력 분석(Power Analysis)을 통해 제1종 오류(α)와 제2종 오류(β)를 통제하는 과학적인 표본 크기를 계산해 준다.
📝 G*Power 다중회귀분석 기본 입력 표준 파라미터
검정력(Power) = 1 - β (표준 0.80 또는 엄격한 기준 0.95 적용)
가장 널리 활용되는 다중회귀분석(F tests -> Linear multiple regression: Fixed model, R² deviation from zero)의 설정 절차는 다음과 같다.
1) Test family: F tests 선택
2) Statistical test: Linear multiple regression: Fixed model, R² deviation from zero 선택
3) Type of power analysis: A priori: Compute required sample size 지정
4) 파라미터 입력: 효과크기(Effect size f²) = 0.15 (중간 크기), 유의수준(α err prob) = 0.05, 검정력(Power: 1-β err prob) = 0.80, 독립변수 수(Number of predictors) = 5개
→ Calculate 버튼 클릭: 최소 표본 수 N = 92명 도출 (탈락률 15% 감안 시 약 110부 배포 필요)
모집단 크기를 아는 경우: 타로 야마네 공식 👩💼👨💻
전체 고객이나 특정 조직의 임직원처럼 모집단 크기(N)가 유한하게 정해져 있는 경우에는 신뢰수준(Confidence Level)과 표본오차(Margin of Error)를 적용하는 '타로 야마네(Taro Yamane)' 공식이나 코크란(Cochran) 공식을 적용할 수 있다.
경영학 및 사회과학 연구에서 가장 널리 쓰이는 기준은 95% 신뢰수준에 허용오차 ±5%(0.05) 조건이다. 모집단 수가 수만 명에 달하더라도 허용오차 5% 기준을 충족하는 표본 수는 대략 380~400명 선에서 수렴하게 된다.
타로 야마네 산출 공식: n = N / (1 + N * e²) (여기서 n은 표본 수, N은 모집단 크기, e는 허용오차).
예를 들어 특정 기업 직원 1,000명을 대상으로 5% 오차범위를 적용하면 1000 / (1 + 1000 * 0.0025) = 약 286명의 응답이 요구된다.
실전 예시: 석사학위 논문 표본 설계 사례 📚
실제 연구 현장에서 연구자들이 심사보고서에 표본 산출 근거를 어떻게 명시하는지 실제 사례 구조를 통해 살펴보자.
김 연구원의 연구 조건
- 연구 주제: 생성형 AI 도구 활용이 직무 몰입에 미치는 영향 분석
- 통계 모형: 독립변수 3개, 매개변수 1개, 조절변수 1개를 포함한 다중회귀 및 조절효과 분석
- 분석 소프트웨어: SPSS 및 PROCESS Macro 활용 예정
G*Power 산출 및 배포 계획
1) G*Power 3.1.9.7 적용: 유의수준 α=0.05, 검정력 1-β=0.85, 중간 효과크기 f²=0.15, 총 예측변수 5개 설정
2) 최소 필요 유효 표본 산출 결과: 102명 요구 확인
3) 온라인 설문 특성상 불성실 응답률(20%) 반영: 102 ÷ 0.8 = 총 128부 배포 결정
최종 수집 결과
- 총 수집 부수: 140부 수집 완료
- 유효 데이터: 불성실 응답 15부 제외 후 최종 125부 확보로 통계적 검정력 완벽 충족!
이렇게 연구계획서와 본문 조사설계 장에 G*Power 수치와 배포율 산출 근거를 텍스트와 캡처 화면으로 남겨두면, 심사위원의 표본 대표성 관련 지적을 원천 차단할 수 있다.
마무리: 핵심 내용 요약 📝
설문조사 표본 크기 결정은 단순한 감(Feeling)이 아니라 연구 타당도를 결정짓는 시작점이다.
목표로 하는 분석 모형에 맞추어 G*Power 프로그램을 통해 객관적 검정력을 먼저 계산하고, 회수 탈락률을 감안하여 배포 계획을 세우자! 😊
표본 수(N수) 결정 핵심 요약
자주 묻는 질문 ❓
'학술·학위논문' 카테고리의 다른 글
| 논문 표절률 10% 맞추는 법: 카피킬러 6어절 원리와 실전 패러프레이징 가이드 (0) | 2026.09.20 |
|---|---|
| 학위논문 목차 잡는 법: 장별 필수 수록 내용과 10-25-20-30-15 황금 비율 (0) | 2026.09.19 |
| 논문에 딱 맞는 통계는? 양적 연구 vs 질적 연구 방법론 선택 방법 (0) | 2026.09.17 |
| 지도교수 피드백 메일 작성법과 논문 심사(디펜스) 완벽 통과 전략 (0) | 2026.09.16 |
| 논문 프로포절 심사 단골 질문 10가지와 교수님을 설득하는 안전한 모범 답변법 (0) | 2026.09.15 |