얼마 전 대학원 논문 지도와 심사 컨설팅을 진행하다가 정말 등골이 서늘해지는 경험을 했다.
한 초보 연구자분이 통계 분석 챕터를 아주 깔끔하고 세련되게 정리해 오셨다.
회귀분석 계수도 딱 맞아떨어지고 가설 검증 표도 그럴듯해서 흐뭇하게 살펴보던 중이었다.
그런데 제 연구 방법론 레이더에 아주 결정적인 빈틈 하나가 딱 걸렸다. 😊
바로 연구 방법론 어디에도 어떤 통계 분석 패키지 소프트웨어를 사용했는지(SPSS, R, Python, STATA 등)가 한 줄도 적혀 있지 않았던 거다.
심지어 분석 도구의 영문 풀네임(Full Name)이나 버전, 옵션 세부 정보가 완전히 증발해 있었다.
"연구자님, 이 분석 어떤 툴로 돌리셨어요?"라고 조심스레 여쭤봤더니 목소리가 떨리게 대답했다.
그리고는 한참을 머뭇거리시더니 "사실... 챗GPT한테 데이터 파일 업로드하고 그냥 분석표 그려달라고 했어요"라고 실토했다.
생성형 AI(Generative Artificial Intelligence)가 코딩도 해주고 표도 만들어주니 마냥 편리하다고 생각하셨겠지만, 이건 학계에서 단순 실수가 아니라 심각한 연구 진실성 결여로 이어질 수 있는 중대한 문제이다.
초보 연구자 여러분이 이런 치명적인 덫에 걸리지 않도록 왜 이런 일이 발생하는지, 그리고 어떻게 대처해야 하는지 차근차근 짚어드린다!
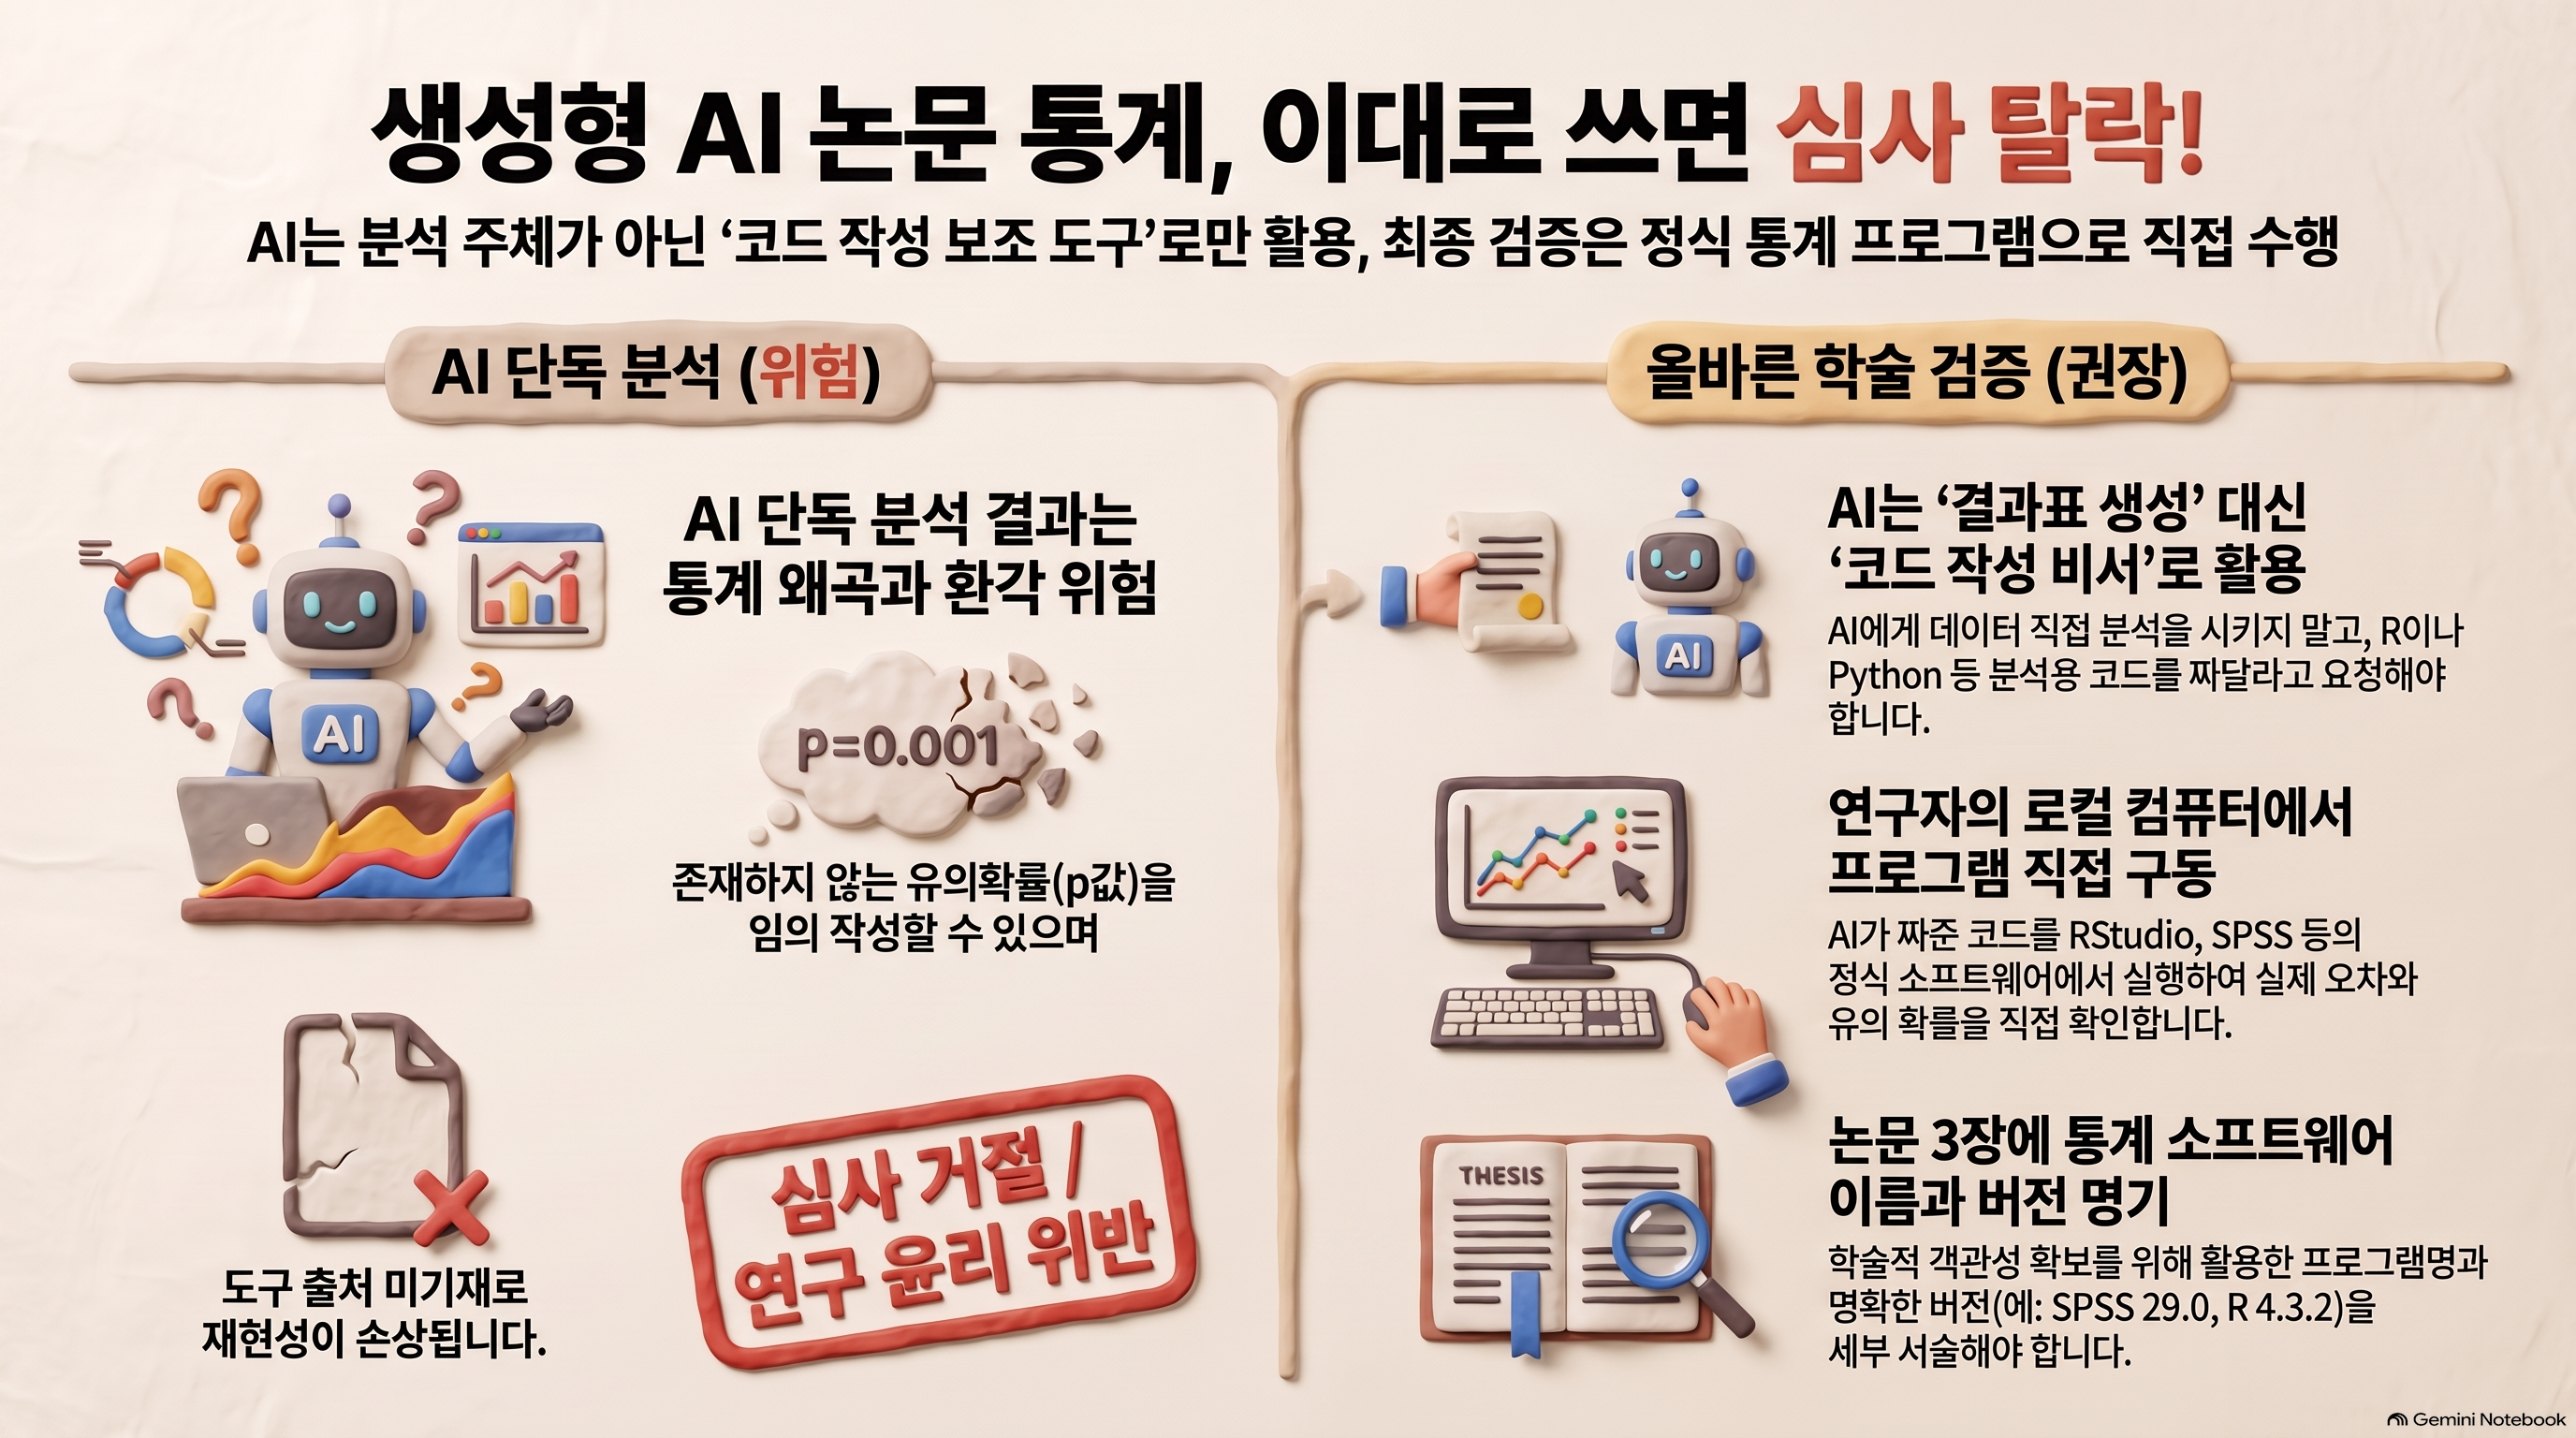
왜 AI 통계 분석은 '도구 누락'으로 들통날까? 🤔
전문 연구자나 논문 심사위원들은 논문의 3장 '연구 방법'과 4장 '실증 분석 결과'를 볼 때 일종의 규칙화된 표준 양식을 확인한다.
전통적인 통계학에서는 어떤 소프트웨어의 몇 버전을 썼는지, 결측치 처리는 어떤 알고리즘을 거쳤는지를 명시하는 것이 재현성(Reproducibility)을 위한 절대적인 필수 조건이다.
하지만 대규모 언어 모델(LLM, Large Language Model)에 프롬프트로 "이 엑셀 데이터로 가설 검증하고 결과 해석해 줘"라고 던지면, AI는 결과 텍스트와 요약 표만 매끄럽게 뽑아낼 뿐 전통적인 학술 프로토콜인 도구 출처를 명시하지 않는다.
즉, 연구자가 도구에 대한 개념 없이 복사-붙여넣기만 했다는 결정적 증거가 바로 그 '도구 설명의 부재'에서 고스란히 드러나는 셈이다.
학술 논문에서 통계 패키지 명시는 선택이 아닌 필수예요. 예컨대 "본 연구의 자료 분석은 SPSS(Statistical Package for the Social Sciences) Ver 28.0을 활용하여..."와 같이 공인된 소프트웨어와 버전, 통계 기법의 명확한 출처가 명시되어야만 학술적 객관성을 인정받을 수 있습니다.
전통 통계 소프트웨어 vs 대화형 AI 분석 비교 📊
그렇다면 연구 현장에서 왜 AI의 단독 통계 분석을 위험하다고 경고하는 걸까요?
전통적인 통계 패키지와 대화형 AI 도구 사이에는 학술적 엄밀성 측면에서 하늘과 땅 차이의 간극이 존재하기 때문이다.
두 방식의 차이를 한눈에 비교해 볼 수 있도록 정리해 드릴 테니, 본인의 연구가 어디에 해당하는지 꼭 점검해 보자!
분석 도구별 학술적 특성 비교
| 구분 | 검증성 및 재현성 | 투명한 알고리즘 | 학술지 투고 가능 여부 |
|---|---|---|---|
| 전용 소프트웨어 (SPSS, SAS) |
동일 원자료 투입 시 100% 동일한 산출물 보장 | 표준 통계 수식 및 수학적 패키지 탑재 | 국내외 KCI/SSCI 등 등재 학술지 표준 충족 |
| 오픈소스 코드 (R, Python) |
스크립트(Script) 공유를 통한 완벽한 사후 검증 | 사용한 라이브러리 및 패키지 원본 코드 투명 공개 | 코드 원본 부록 제출 시 높은 학술적 신뢰도 인정 |
| 생성형 AI 단독 프롬프트 |
확률적 텍스트 생성으로 동일 자료라도 결과값 변동 가능 | 블랙박스 구조로 중간 연산 과정 추적 불투명 | 도구 및 연산 근거 미제시 시 게재 불가 또는 심사 탈락 |
| AI 기반 코드 생성 + 사후 검증 | 생성된 R/Python 코드를 로컬 환경에서 재실행하여 일치 검증 | 실제 컴퓨터 콘솔 로그와 산출물 완전 일치 확인 | 연구 윤리 가이드라인 준수 하에 정상 심사 인정 가능 |
AI가 생성한 통계 수치에는 '환각 현상(Hallucination)'이 포함될 수 있어요. 실제 p값이 0.12인데도 연구자가 원하는 가설 방향에 맞춰 임의로 p < .05로 출력해 버리는 무서운 통계 왜곡이 발생하기도 합니다. AI 결과를 맹신하고 논문에 적었다가는 연구 부정행위(데이터 위·변조) 혐의를 받을 수 있으니 각별히 유의해야 해요!
연구 신뢰도 점수 자가 진단 및 위험도 측정 🧮
내가 쓴 논문 초안이 학술 심사에서 "AI 의존 통계 의혹"을 받을 위험이 얼마나 되는지 사전에 수치로 환산해 볼 수 있다.
논문 데이터의 신뢰도 지수를 간단한 수식으로 점검해 볼까요?
📝 통계 신뢰도 위험 지수 공식
위험 지수(Risk Index) = (미기재 항목 수 × 25) - (재현 코드 보유 가중치 × 10)
실제 심사 현장 기준을 적용한 예시를 통해 내 논문의 위치를 가늠해 보세요:
1) 첫 번째 단계: 필수 항목(도구명, 버전, 분석 옵션, 원자료 로그) 중 3개를 누락한 경우 (3 × 25점 = 75점)
2) 두 번째 단계: 재현 가능한 스크립트 코드나 로그 파일이 없는 경우 (가중치 0점 차감)
→ 최종 위험 지수 75점 (심사 거절 및 전면 재작성 권고 수준)
초보 연구자가 꼭 지켜야 할 'AI 통계 3대 원칙' 👩💼👨💻
그렇다면 연구 현장에서 인공지능을 통계 분석에 아예 활용하면 안 되는 걸까요?
전혀 그렇지 않다.
도구는 죄가 없으며, 중요한 것은 '연구자가 주도권을 쥐고 검증할 수 있는가'이다.
올바른 학술적 AI 활용 루틴을 반드시 기억해 두자!
- 결과 생성이 아닌 '분석 코드 작성 비서'로만 활용하기: AI에게 "분석해서 결과표 만들어줘"라고 시키지 마시고, "R 프로그래밍으로 다중회귀분석을 돌릴 수 있는 코드를 작성해 줘"라고 명령하세요.
- 연구자의 로컬 컴퓨터 환경에서 직접 코드 실행하기: AI가 건네준 파이썬(Python)이나 R 스크립트를 내 컴퓨터의 RStudio나 주피터 노트북에 붙여 넣고 직접 데이터를 구동해 보세요. 그래야 콘솔 창에 찍히는 실제 오차와 유의확률을 두 눈으로 확인할 수 있습니다.
- 논문 3장 방법론에 도구 명칭과 버전을 100% 명기하기: "본 연구의 통계 분석을 위해 R 4.3.2 버전의 'lavaan' 패키지를 활용하였으며..."와 같이 표준 학술 규격에 맞춰 구체적으로 서술해야 합니다.
미국심리학회(APA, American Psychological Association) 7판 스타일 및 유수 학술지 윤리 규정에서는 생성형 AI를 저자로 인정하지 않으며, 데이터 생성이나 결과 도출에 AI를 무단 개입시키는 행위를 연구 부정행위로 엄격히 규제하고 있어요. 정당한 도구로 활용했더라도 서문이나 방법론에 AI 활용 내역을 투명하게 공개(Disclosure)해야 당당한 학술 연구가 됩니다.
실전 사례: AI 통계 덜컥 썼다가 심사 탈락 위기 겪은 김 석사 이야기 📚
실제 컨설팅 현장에서 마주쳤던 가장 아찔했던 케이스를 하나 각색해서 소개해 드릴게요. 많은 대학원생분들이 시간에 쫓기다 보면 비슷한 유혹에 빠지곤 하거든요.
사례 연구자: 경영대학원 석사 4학기 김 연구원
- 상황: 직장 병행으로 논문 마감 기한이 임박하자 설문지 300부 데이터를 챗봇에 넣고 "가설 검증표를 표 양식으로 만들어줘"라고 요청
- 문제 발생: 예비 심사에서 심사위원이 "t값과 F값 산출 시 등분산 가정이 충족되었는가? SPSS의 Levene 검정 수치는 왜 빠져있는가?"를 기습 질의
위기 극복 솔루션
1) 즉시 AI가 임의로 만든 숫자 표를 폐기하고, 원자료 CSV 파일을 학내 라이선스 SPSS에 업로드
2) 신뢰도 분석(Cronbach's Alpha)부터 구조방정식 모형까지 정석 프로세스로 재분석 수행 및 출력 파일(.spv) 백업
최종 결과
- 결과 1: 놀랍게도 AI가 뱉어냈던 p값 중 2개는 실제 SPSS 구동 시 유의수준 5%를 충족하지 못하는 허위 수치였음이 판명됨
- 결과 2: 데이터 왜곡을 사전에 바로잡고 정직한 연구 분석 챕터를 완성하여 최종 본심사에서 무사 통과
만약 이분이 정식 소프트웨어로 재검증하지 않고 본심사에 들어갔다면 어떻게 되었을까요?
생각만 해도 등줄기에 식은땀이 흐르지 않나요? AI가 요약해 준 숫자는 그럴듯해 보이지만 연구의 생명인 '정직성과 신뢰성'을 지켜주지는 못한다.
핵심 내용 요약 📝
오늘 나눈 논문 통계와 생성형 AI 사용 주의점, 마지막으로 핵심만 가슴에 새겨두자!
- 도구 미기재는 명백한 결격 사유: 통계 분석 도구의 이름과 버전이 없는 논문은 학술적 가치를 인정받을 수 없습니다.
- 결과 복사는 절대 금물: AI는 확률적 언어 모델일 뿐 공인된 통계 연산 엔진이 아니므로 환각 수치를 양산할 수 있습니다.
- 코드 생성 도구로 쓰고 직접 실행할 것: 스크립트를 생성받아 내 환경에서 돌리고 투명한 로그를 남기는 것이 유일한 해법입니다.
시간이 조금 더 걸리더라도 내 연구를 지키는 가장 확실하고 정직한 길을 걸으셨으면 좋겠다. 😊
논문 통계 분석 안전 요약 카드
자주 묻는 질문 ❓
'AI 시대 연구 생존 전략' 카테고리의 다른 글
| 논문 통계분석, AI로 작성하면 왜 가설과 수치 순서가 꼬일까? (0) | 2026.10.10 |
|---|---|
| 논문작성방법, AI를 써도 막히는 4가지 이유와 해결법 (0) | 2026.08.27 |
| AI 논문 작성, 초보자가 반드시 확인할 5가지 기준 (0) | 2026.08.26 |
| 논문 작성 시 가장 빈번하게 저지르는 치명적 실수: 숫자와 통계 검증을 건너뛰는 이유 (0) | 2026.08.25 |
| 그럴듯한 '가짜 논문'의 습격: 없는 논문이 참고문헌에 들어간 이유 (0) | 2026.08.24 |