대학원에서 프로포절 시즌이나 논문 심사가 다가오면 연구실에서 매일같이 오가는 대화가 있다.
"선배님, 제 주제는 SPSS만 돌려도 될까요? 아니면 요즘 다들 R이나 파이썬 쓴다는데 코딩 학원이라도 등록해야 하나요?"라는 막막한 질문이다.
제가 수많은 석·박사 연구자들을 지도하고 컨설팅하면서 정말 수백 번은 넘게 들은 고민이기도 하다.
결론부터 말씀드리면, 연구 모형과 데이터 성격에 맞지 않는 과도한 도구 학습은 소중한 학위 과정의 시간을 갉아먹는 주범이 된다. 도구는 수단일 뿐 본질은 가설과 연구 설계에 있다. 😊
통계 패키지의 기본 본질: 연구 모형이 프로그램을 결정한다 🤔
연구자들이 겪는 불안감의 시작은 대개 남들의 시선에서 출발한다.
옆 연구실 동기가 복잡한 코딩 화면을 띄워놓고 있으면, 왠지 클릭 몇 번으로 끝나는 메뉴 방식의 분석이 뒤처져 보이고 심사위원에게 낮은 평가를 받을 것 같은 착각에 빠지게 된다.
하지만 학위논문 심사나 한국연구재단 등재지(KCI) 논문 심사위원들이 확인하는 핵심은 '어떤 화려한 도구를 썼는가'가 아니다.
설정한 연구 가설을 검증하기 위해 통계 기법이 타당하게 선택되었는가?, 그리고 그 산출 결과를 학술적 이론에 입각하여 올바르게 해석했는가?이다.
연구 방법론의 세계에서 도구의 우열은 없습니다. 집 앞에 가벼운 산책을 가는데 항공기를 탈 필요가 없듯이, 단일 매개효과나 t-검정, 다중회귀분석이 목적인 연구에서 굳이 파이썬 머신러닝 라이브러리를 동원할 이유는 전혀 없습니다.
SPSS, AMOS, R, Python 4대 분석 도구 비교 분석 📊
현재 국내외 사회과학, 경영학, 교육학, 보건학 분야에서 가장 널리 쓰이는 대표 소프트웨어들은 저마다 고유한 강점과 명확한 적용 영역을 지니고 있다.
각 프로그램의 진입 장벽과 적합한 분석 범위를 표로 한눈에 정리해 두었으니, 본인의 연구 모형이 어느 그룹에 속하는지 면밀히 확인해 보자.
논문 데이터 분석 소프트웨어 핵심 비교
| 구분 | 학습 난이도 | 주요 적합 모형 | 비고 및 추천 대상 |
|---|---|---|---|
| SPSS (Statistical Package for the Social Sciences) |
낮음 (GUI 마우스 클릭 기반) |
기술통계, 상관분석, t-test, ANOVA, 회귀분석, Hayes PROCESS macro 기반 매개·조절효과 | 석사 학위논문 및 표준적인 설문조사 실증 연구의 80% 이상 충족 |
| AMOS (Analysis of Moment Structures) |
보통 (다이어그램 드로잉 기반) |
확인적 요인분석(CFA), 공분산 기반 구조방정식 모형(CB-SEM), 다중집단분석 | 잠재변수가 다수 얽힌 복합 인과관계를 검증하는 박사논문 및 학술지 필수 도구 |
| R | 높음 (R 통계 프로그래밍 스크립트 작성) |
메타분석, 시계열 분석, 패널회귀분석, PLS-SEM, 최신 통계 알고리즘 적용 | 오픈소스 무료 패키지, 데이터 시각화 및 재현성이 중요한 엄격한 투고 논문 |
| Python | 매우 높음 (소프트웨어 개발 언어 기반) |
웹 크롤링 데이터 수집, 텍스트 마이닝, 자연어 처리(NLP), 머신러닝 및 딥러닝 예측 모형 | 정형 설문조사보다는 비정형 소셜 빅데이터 기반 융합 연구에 최적화 |
연구 마감 기한이 3~4개월밖에 남지 않은 상태에서 설문지 데이터를 분석하겠다고 R이나 Python 코딩 기초 문법부터 공부하기 시작하는 것은 논문 탈락으로 가는 지름길입니다. 도구 학습 곡선(Learning Curve)에 갇혀 연구 내용 집필을 놓치지 마세요.
내 논문에 맞는 통계 도구 진단 판별 🧮
그렇다면 과연 내 논문은 어디까지 학습해야 할까요? 통계 분석 도구를 선택하는 결정 공식은 매우 단순하고 직관적이다.
📝 최적 툴 결정 공식
최적 선택 = (데이터 형태 × 연구 가설의 복잡도) – 남은 학기 일정
이 공식에 따른 단계별 판단 기준을 실제 흐름에 맞추어 점검해 볼 수 있습니다:
1) 첫 번째 단계: 데이터가 리커트 5점 척도의 일반 설문지인가? → SPSS만으로 100% 가능 (PROCESS 매크로 포함 시 복잡한 조절된 매개효과까지 완전 해결)
2) 두 번째 단계: 잠재변수 간의 측정오차를 통제하고 전체 모형의 적합도(Fit Index)를 봐야 하는가? → SPSS + AMOS 조합 필수
3) 세 번째 단계: 뉴스 기사 기계학습이나 대용량 트랜잭션 로그 분석인가? → R 또는 Python 필수
→ 자신의 연구 질문이 리커트 척도 기반 인과관계 규명이라면 코딩 프로그램에 대한 부담을 즉시 내려놓아도 됩니다.
심사위원이 실제로 평가하는 핵심 기준 👩💼👨💻
많은 연구자들이 오해하는 것 중 하나가 "R이나 파이썬으로 짠 코드를 부록에 넣어야 논문이 멋있어 보인다"는 생각입니다. 하지만 심사위원 교수님들의 입장은 정반대일 때가 많다.
오히려 난해한 코드를 돌려 산출한 결과표의 수치들을 본인 스스로 제대로 방어하지 못해 구두심사(디펜스)에서 큰 곤욕을 치르는 경우가 비일비재하다.
통계표의 유의확률(p값), 표준오차, 회귀계수의 의미를 명확히 구술할 수 있는지가 평가 점수의 핵심이다.
연구자의 첫 번째 덕목은 '해석력과 재현성'입니다. SPSS로 산출한 기본 회귀계수표라도 다중공선성(VIF) 검토와 잔차 분석이 완벽하게 기술되어 있다면 훌륭한 학위논문으로 인정받습니다.
실전 예시: 박사과정 김 연구원의 실패 없는 선택 📚
실제 컨설팅 현장에서 올바른 툴 선택으로 심사 일정을 극적으로 단축했던 연구원의 실제 사례를 공유해 드린다.
사례 주인공의 상황
- 전공 및 대상: 경영학 석·박사 통합과정 김 연구원 (디펜스까지 잔여 4개월)
- 연구 모형: 조직구성원 320명 대상 직무스트레스와 이직의도 간의 매개 및 조절효과 분석
도구 전환 전략
1) 첫 번째 단계: 주변 권유로 시작했던 R 프로그래밍 학습을 과감히 전면 중단
2) 두 번째 단계: 기존에 다룰 줄 알던 SPSS에 앤드루 헤이즈 교수의 무료 플러그인인 PROCESS Macro 모델 4번 및 모델 7번을 연동
최종 결과
- 소요 시간 절감: 툴 학습 시간을 2주로 단축하고, 절약한 두 달 동안 선행연구 고찰 및 본문 작성 집중
- 심사 결과: 모형의 이론적 논거와 수치 해석이 완벽하다는 호평과 함께 수정 없이 본심 통과
이 사례가 주는 교훈은 자명한다.
도구에 끌려다니지 않고 내 일정과 모형에 통제권을 쥐는 순간, 논문 완성의 속도는 비약적으로 빨라진다.
마무리: 핵심 내용 요약 📝
논문 통계 패키지 선택의 핵심 기준들을 깔끔하게 요약해 드린다.
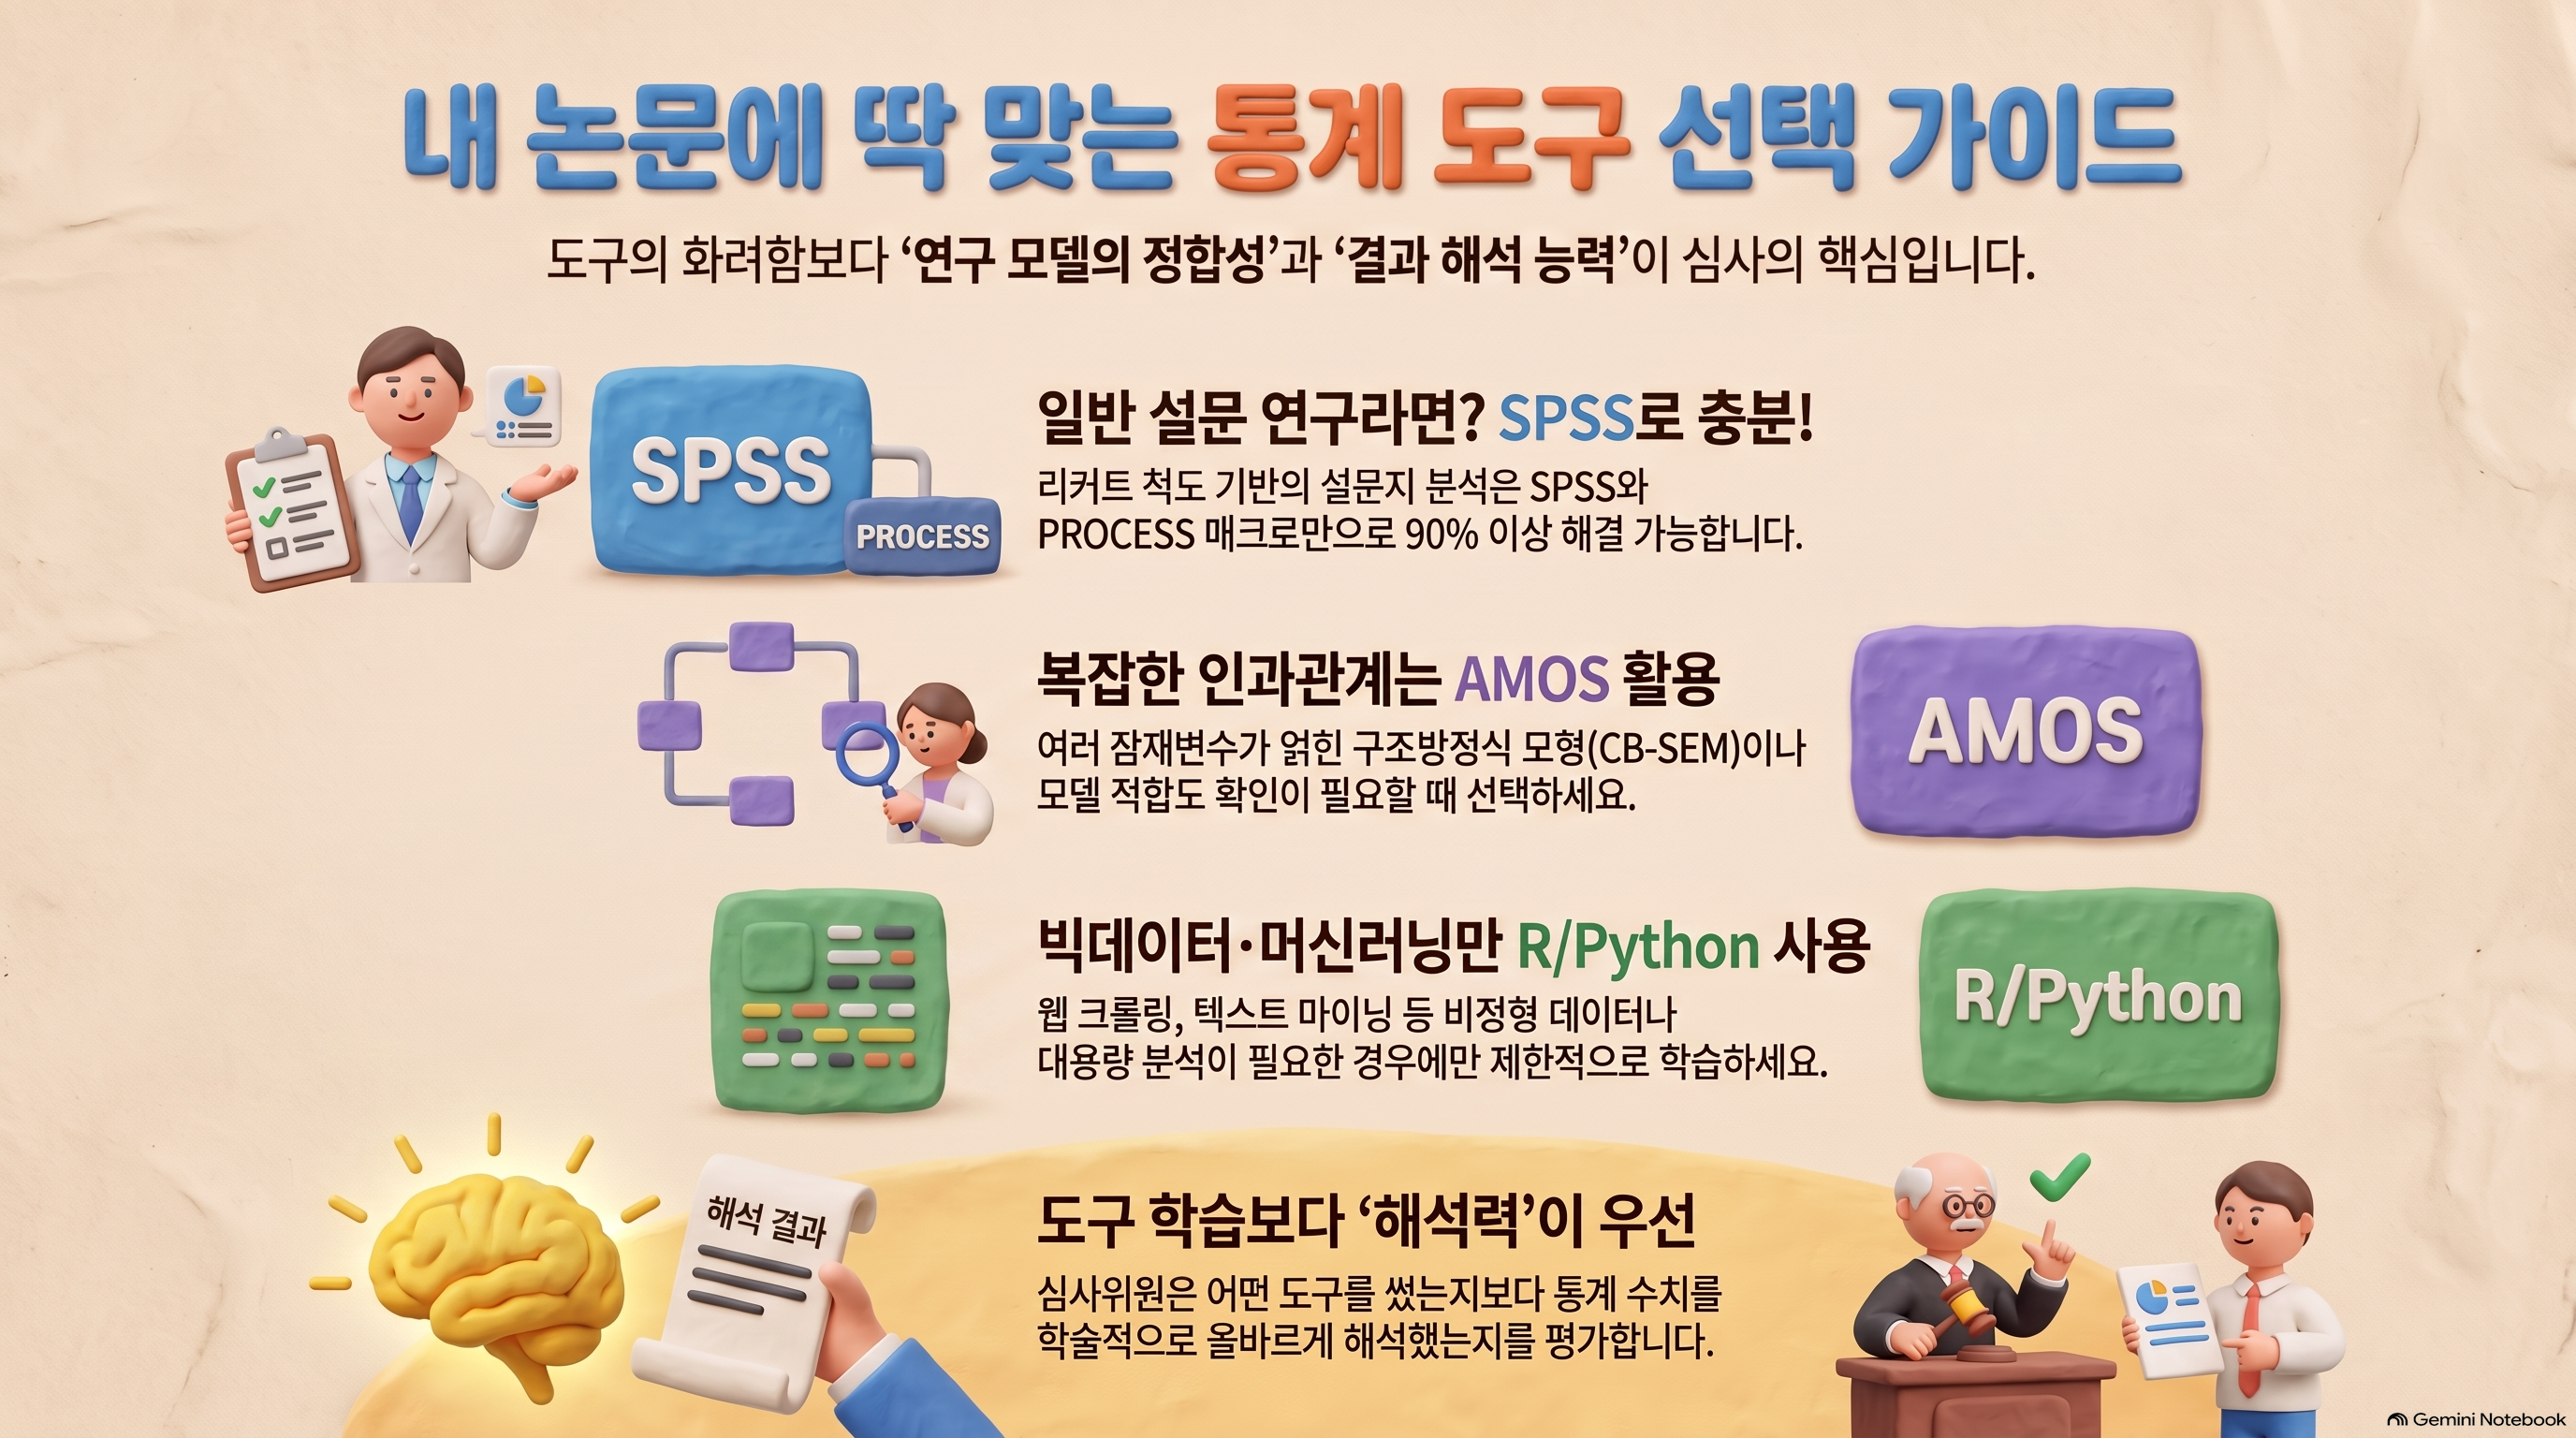
- SPSS의 유효성: 일반 설문조사 실증 연구는 SPSS와 PROCESS 매크로 조합만으로 90% 이상 충분히 통과할 수 있습니다.
- AMOS의 필요 영역: 복수의 잠재변수가 얽힌 공분산 구조방정식 모형(CB-SEM)과 확인적 요인분석이 필수일 때 선택합니다.
- R과 Python의 영역: 웹 데이터 크롤링, 비정형 텍스트마이닝, 머신러닝 모형 또는 무료 오픈소스 연구 환경이 절대적으로 필요할 때 한정적으로 학습합니다.
- 우선순위의 원칙: 학위논문 디펜스의 핵심은 도구의 난이도가 아니라 연구 모형의 정합성과 결과에 대한 학술적 해석 능력에 있습니다.
연구는 긴 호흡을 요구하는 지적인 여정이다.
불필요한 도구에 에너지를 낭비하지 마시고,
여러분의 뛰어난 연구 가설을 입증하는 본질적인 글쓰기에 집중해 보자~ 😊
논문 통계 도구 한 장 정리
자주 묻는 질문 ❓
'연구데이터분석' 카테고리의 다른 글
| p값(p-value)과 유의확률: p < .05, .01, .001 별표의 정확한 의미 (0) | 2026.10.05 |
|---|---|
| 논문 통계 핵심 지표 총정리: t값, p값, F값, R², VIF 한눈에 이해하기 (0) | 2026.10.04 |
| 다중공선성이란? VIF 기준치 확인부터 논문 심사위원 완벽 소명 전략까지 (0) | 2026.10.03 |
| 논문 설문지 역코딩 설계 및 전처리 가이드 (0) | 2026.10.02 |
| 부트스트래핑이란? 통계 분석에서 수천 번 반복 추출하는 진짜 이유 (0) | 2026.10.01 |