대학원 논문을 준비하시거나 데이터 기반 비즈니스 기획서를 쓰다 보면 통계 분석 결과표 하단에 작게 적힌 *p < .05, **p < .01, ***p < .001 같은 문구를 한 번쯤 보셨을 거다.
저 역시 초보 연구자 시절에는 통계 프로그램(SPSS나 R) 돌려서 별표만 많이 뜨면 마냥 신났던 기억이 난다. 😊
하지만 심사위원 교수님께서 "그래서 이 p값의 통계적 의미가 정확히 뭡니까?"라고 불시에 질문을 던지면 순간 머릿속이 하얘지곤 한다.
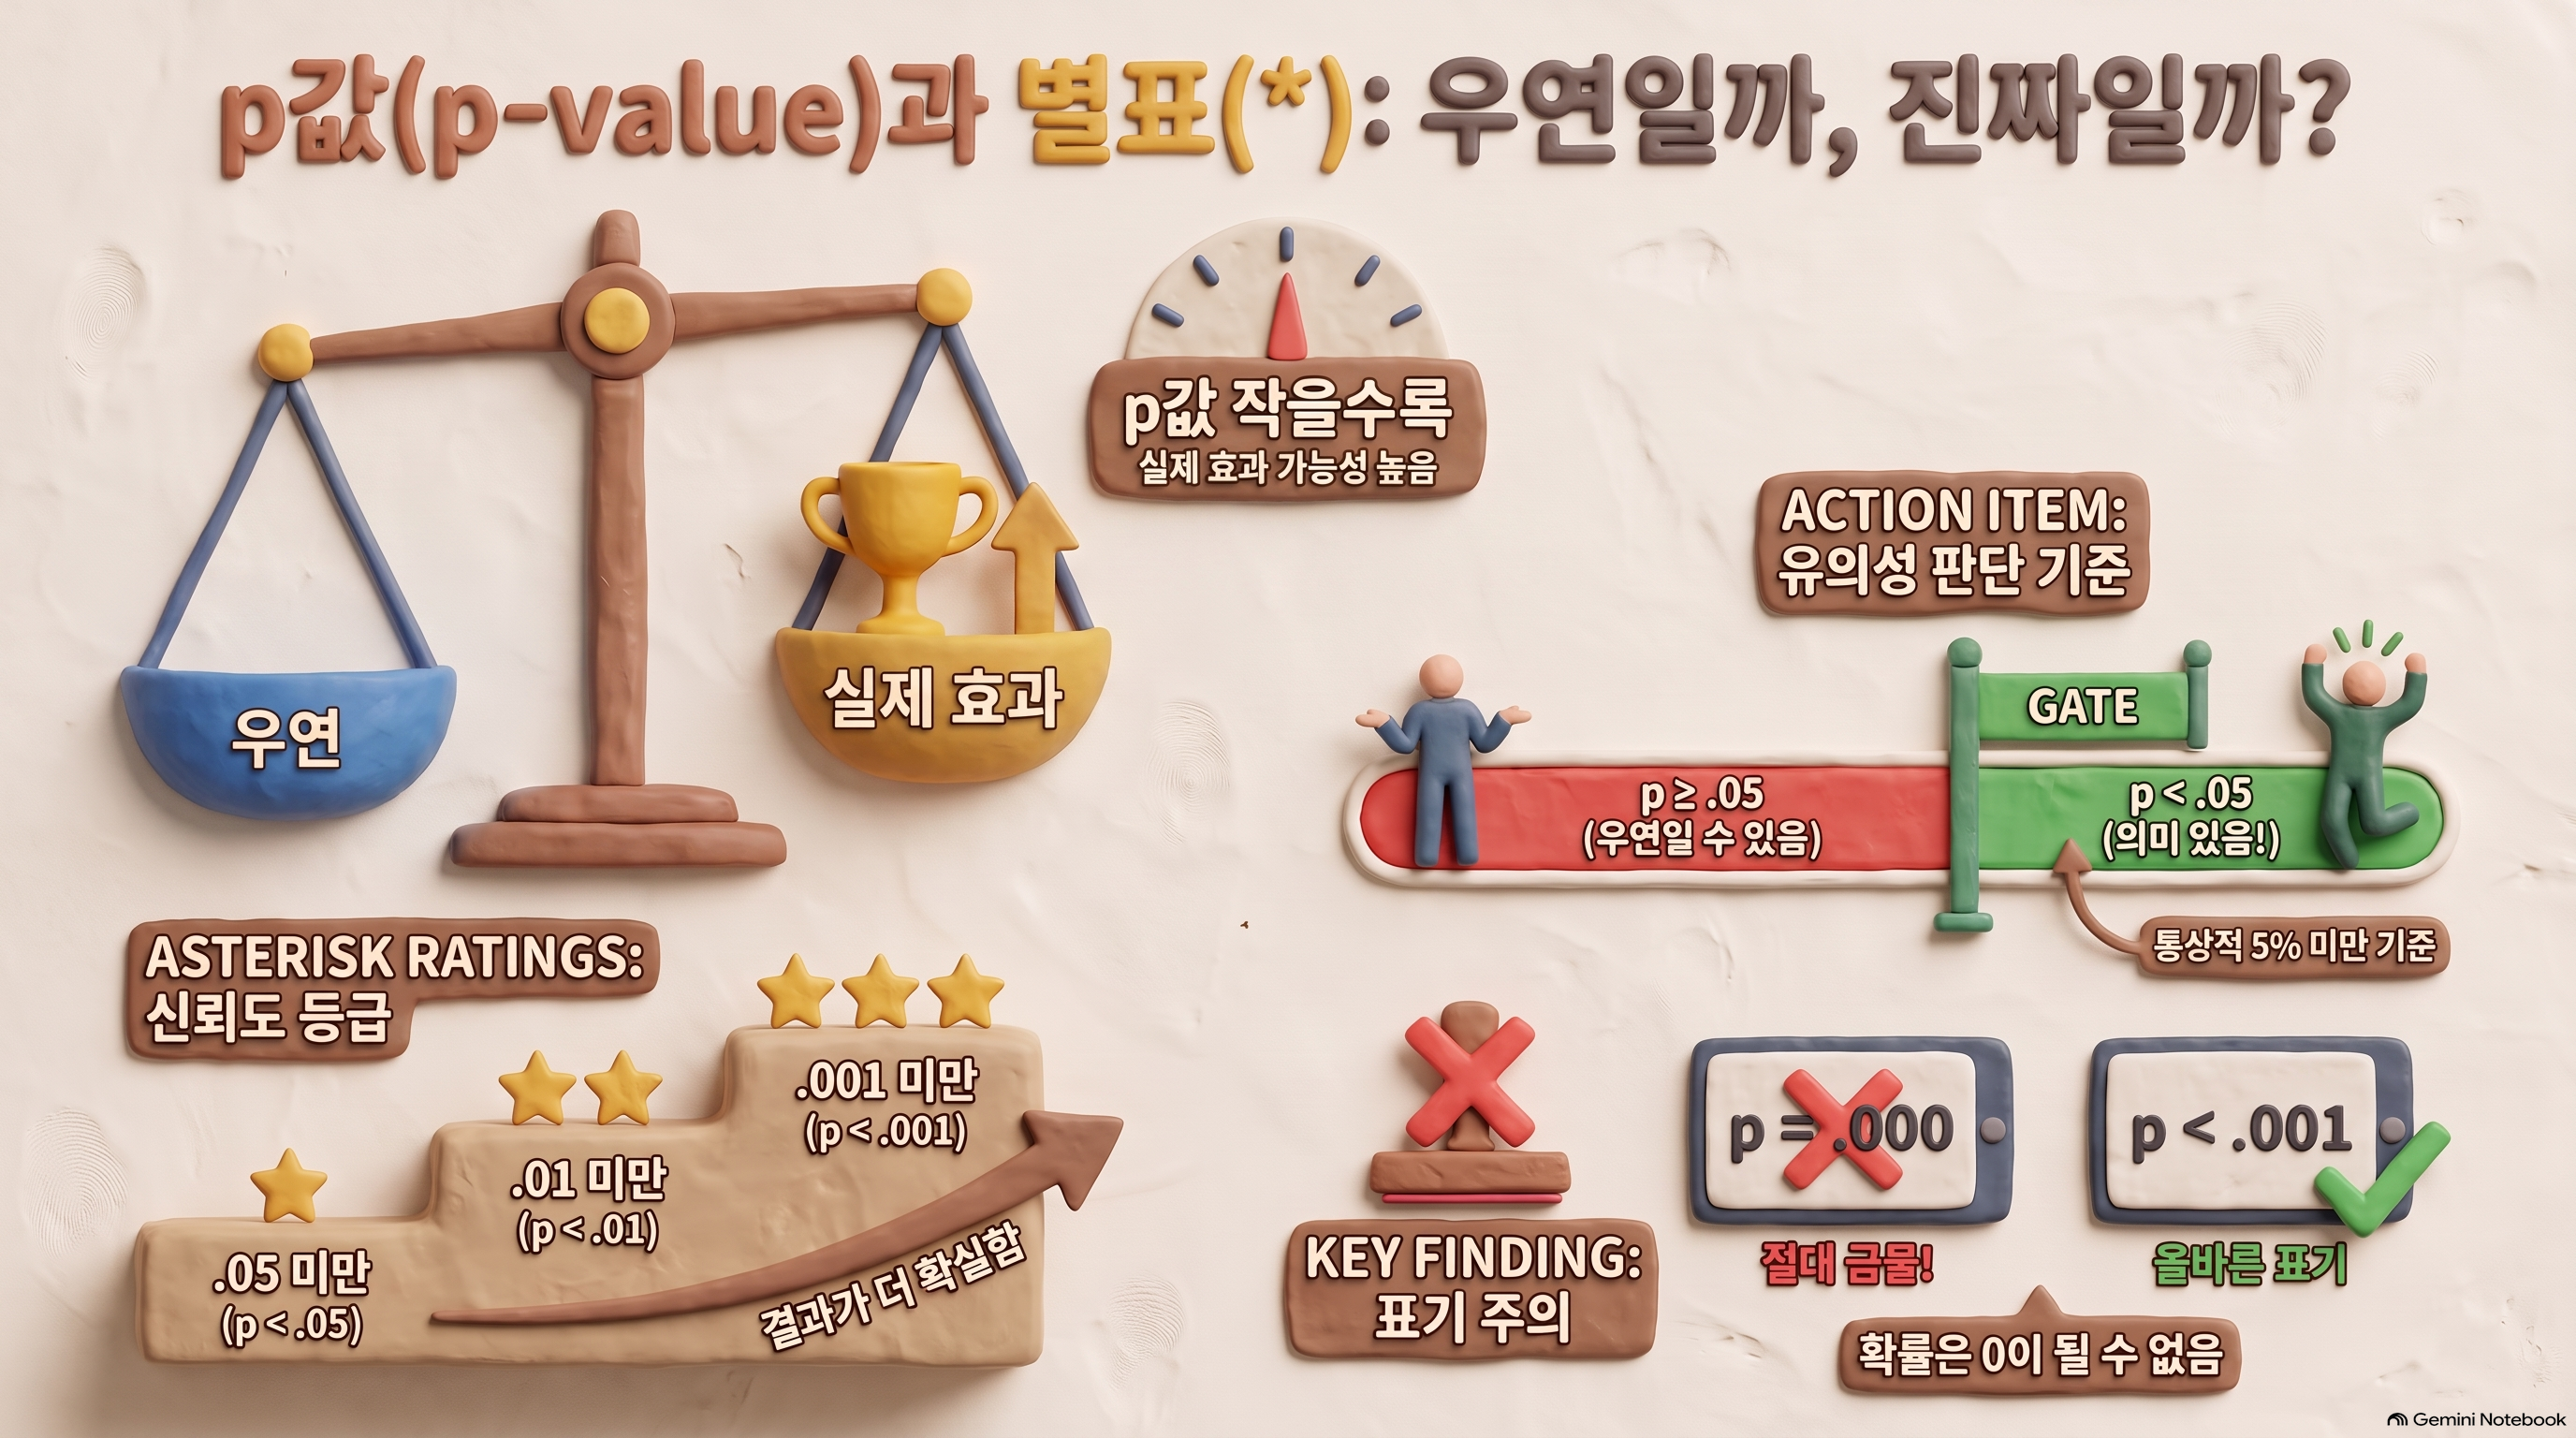
유의확률은 단순한 통과 도장이 아니라, 우리의 연구 결과가 단순한 우연의 일치인지 아니면 실제 의미 있는 효과인지를 판정해 주는 과학적 잣대이다.
1. p값(유의확률, Probability-value)이란 무엇인가? 🤔
통계학에서 p값(유의확률)의 정식 명칭은 Probability-value(유의확률, 有意確率)이다.
한자 뜻 그대로 풀면 '의미가 있다고 인정할 수 있는 확률'을 따지는 기준이 된다.
조금 더 전문적인 통계학 정의로 들어가 볼까요? p값은 '귀무가설(영가설, Null Hypothesis: 차이나 효과가 없다)이 참이라는 전제하에, 현재 관측된 데이터만큼 극단적인 결과가 순전히 우연에 의해 발생할 확률'을 뜻한다.
친구가 앞뒤 확률이 반반인 정상 동전을 던진다고 합시다(귀무가설). 그런데 연속 10번 모두 앞면이 나왔습니다. 공정한 동전에서 이런 일이 일어날 확률은 약 0.00098(0.1% 미만)입니다. 이 0.00098이 바로 p값입니다. 확률이 너무 희박하므로 우리는 "이 동전은 조작된 동전이다(대립가설 채택)"라고 합리적 의심을 품게 되는 것입니다.
2. 별표(*, **, ***)의 의미와 유의수준(α) 기준 📊
학술 논문이나 데이터 분석 보고서 표(Table)를 보면 수치 옆에 붙은 별표(Asterisk)를 자주 발견할 수 있다.
이는 학계의 통상적인 관례로, 유의수준(Significance Level, α)을 기준으로 연구 가설이 채택되었음을 직관적으로 알리기 위한 시각적 표현이다.
사회과학 및 경영학 분야에서는 주로 미국심리학회(APA: American Psychological Association) 표기법을 준용하며, 아래 표와 같이 세 가지 문턱값(Threshold)을 사용한다.
유의확률 기준과 별표 표기 체계
| 표기 형식 | 수치적 기준 | 학술적 판정 명칭 | 우연 발생 확률(오차 위험) |
|---|---|---|---|
| * (Single Star) | p < .05 | 통계적으로 유의함 (Significant) |
우연일 가능성 5% 미만 (95% 신뢰) |
| ** (Double Star) | p < .01 | 매우 유의함 (Highly Significant) |
우연일 가능성 1% 미만 (99% 신뢰) |
| *** (Triple Star) | p < .001 | 극히 유의함 (Extremely Significant) |
우연일 가능성 0.1% 미만 (99.9% 신뢰) |
| ns (Non-Significant) | p ≥ .05 | 유의하지 않음 (가설 기각 실패) |
우연일 가능성 5% 이상 (효과 입증 불가) |
SPSS 같은 통계 프로그램 출력창에 간혹 `p = .000`으로 뜰 때가 있습니다. 이를 그대로 논문에 "p = .000"이라고 적으면 논문 심사 때 크게 지적받습니다! 확률은 절대 0이 될 수 없으며 소수점 넷째 자리 이하에서 잘린 것이므로, 반드시 p < .001로 고쳐 적어야 합니다.
3. p값 판정 시뮬레이터와 판정 공식 🧮
p값을 통한 가설 검정의 수학적 판정 공식은 매우 단순하고 명확하다.
미리 정해둔 제1종 오류 허용 수준(유의수준 α)과 계산된 p값을 직접 비교하는 방식이다.
📝 가설 채택 판정 공식
판정 기준: p-value < α (유의수준, 통상 0.05) → 귀무가설(H₀) 기각 & 대립가설(H₁) 채택
4. p값을 반드시 표기해야 하는 학술적 이유 👩💼👨💻
왜 연구계에서는 귀찮게 느껴질 정도로 p값과 별표 표기를 엄격하게 요구할까?
그 핵심 이유는 '표본 오차의 위험성을 통제하고 제1종 오류를 방지하기 위함'에 있다.
우리는 대한민국 전체 성인이나 전 세계 고객을 전수조사할 수 없으므로 필연적으로 표본(Sample)을 추출해 조사한다.
이때 우연히 특이한 응답자들만 뽑혀서 실제로는 효과가 없는데도 효과가 있는 것처럼 나타날 수 있는데, 이를 통계학에서는 제1종 오류(Type I Error, 위양성)라고 부른다.
1. 객관적 재현성 보장: 다른 연구자가 동일한 실험을 반복했을 때 검증 가능한 공통의 기준선을 제공합니다.
2. 의사결정의 리스크 통제: 비즈니스나 정책 도입 시 실패할 확률을 5% 이내로 엄격히 제한합니다.
3. 정확한 수치 병기 권장: 최신 APA 7판 가이드라인에서는 단순 별표 표기뿐만 아니라 정확한 p값(예: p = .023)을 병기하도록 규정하고 있습니다.
5. 실전 사례: 회귀분석 결과표 읽는 법 📚
가장 널리 쓰이는 다중회귀분석(Multiple Linear Regression) 논문 표를 통해 실제 연구 보고서에서 p값이 어떻게 기재되고 해석되는지 살펴보자!!!
연구 사례: 플랫폼 서비스 만족도에 미치는 영향 요인
- 독립변수: 시스템 사용 편의성, 고객센터 응대 신속성, UI 심미성
- 종속변수: 플랫폼 전반적 재이용 의도 (N = 350)
통계 분석 수치 요약
1) 시스템 사용 편의성: β = .342, t = 4.812, p = .000 (***)
2) 고객센터 응대 신속성: β = .156, t = 2.245, p = .026 (*)
3) UI 디자인 심미성: β = .041, t = 0.812, p = .417 (ns)
학술적 최종 해석 결과
- 시스템 사용 편의성은 p < .001 수준에서 재이용 의도에 매우 유의한 정(+)의 영향을 미침이 검증되었습니다.
- 반면 UI 심미성은 p = .417로 유의수준 .05를 초과하므로, 통계적으로 유의미한 영향력이 입증되지 않았다고 보고합니다.
이처럼 별표의 유무를 통해 독자는 어떤 독립변수가 실제로 작동하는 핵심 요인인지 한눈에 파악할 수 있게 된다.
핵심 내용 요약 📝
p값과 유의확률은 통계적 가설 검정이라는 긴 항해에서 연구자에게 올바른 방향을 제시해 주는 나침반과 같다.
별표 하나하나에 담긴 통계적 엄밀성을 이해하고 정확하게 표기할 때, 여러분의 연구와 보고서는 비로소 학술적 신뢰와 설득력을 얻게 된다~ 😊
한눈에 정리하는 p값 핵심 요약
자주 묻는 질문 ❓
'연구데이터분석' 카테고리의 다른 글
| 논문 통계 핵심 지표 총정리: t값, p값, F값, R², VIF 한눈에 이해하기 (0) | 2026.10.04 |
|---|---|
| 다중공선성이란? VIF 기준치 확인부터 논문 심사위원 완벽 소명 전략까지 (0) | 2026.10.03 |
| 논문 설문지 역코딩 설계 및 전처리 가이드 (0) | 2026.10.02 |
| 부트스트래핑이란? 통계 분석에서 수천 번 반복 추출하는 진짜 이유 (0) | 2026.10.01 |
| 상관관계 vs 인과관계 완벽 정리 (0) | 2026.09.30 |