123개

"내 데이터는 어떤 분석을 돌릴까?" 척도와 통계 기법 매핑
No Image
연구가설과 연구모형 설정법: 독립/종속/매개/조절변수 개념 도식화 완벽 가이드
No Image
석·박사 논문 선행연구 몇 편이나 읽어야 할까? 플랫폼별 검색 전략과 인용 기준
No Image
생성형 AI 논문 작성 허용 범위: 연구 윤리 위반 안 걸리는 4가지 원칙
No Image
APA MLA 인용 양식 총정리: 논문 참고문헌 작성법과 EndNote 툴 활용 가이드
No Image
논문 표절률 10% 맞추는 법: 카피킬러 6어절 원리와 실전 패러프레이징 가이드
No Image
학위논문 목차 잡는 법: 장별 필수 수록 내용과 10-25-20-30-15 황금 비율
No Image
설문조사 표본 수(N수)는 최소 몇 명?
No Image
논문에 딱 맞는 통계는? 양적 연구 vs 질적 연구 방법론 선택 방법
No Image
지도교수 피드백 메일 작성법과 논문 심사(디펜스) 완벽 통과 전략
No Image

"내 데이터는 어떤 분석을 돌릴까?" 척도와 통계 기법 매핑


"내 가설에는 어떤 통계 분석을 돌려야 할까?" 독립변수와 종속변수의 측정 척도(명목, 서열, 등간, 비율)만 정확히 파악해도 t-검정, 분산분석(ANOVA), 회귀분석, 구조방정식모델(SEM) 중 무엇을 선택해야 할지 바로 해답이 나옵니다. 헷갈리던 통계 기법 매핑의 기준을 명확하게 짚어드립니다!


연구 계획서를 작성하거나 설문지 데이터를 받아 들었을 때 가장 막막한 순간이 언제일까요?


아마도 "교수님, 제 연구 모형은 어떤 분석을 돌려야 하나요?"라는 질문 앞에서 통계 패키지 메뉴만 하염없이 들여다볼 때일 거다.

많은 대학원생과 연구자분들이 가설은 멋지게 세워두고도 변수의 성격을 제대로 분류하지 못해 엉뚱한 분석 기법을 적용하다 심사에서 지적받곤 한다. 😭

하지만 전혀 두려워할 필요 없다!


복잡해 보이는 통계 기법도 결국 '독립변수(원인)와 종속변수(결과)가 어떤 척도로 측정되었는가'라는 데이터의 유형과 '가설 검증의 목적(집단 간 차이 비교인가, 인과관계 영향력 파악인가)'이라는 두 가지 열쇠만 쥐면 퍼즐처럼 완벽하게 맞아떨어진다. 😊


* 이미지 출처 : Gemino NotebookLM


1단계: 변수의 성격 규명, 4대 측정 척도 완벽 정리 🤔

통계 기법을 결정하는 가장 핵심적인 출발점은 데이터의 척도(Scale of Measurement)를 파악하는 작업이다.

변수가 어떤 숫자로 구성되어 있는지 모른 채 기법부터 고르려고 하면 무조건 실패한다.


척도는 측정 수준에 따라 질적 척도(명목척도, 서열척도)와 양적 척도(등간척도, 비율척도)로 나뉜다.

통계 분석 기법의 대다수는 이 척도 조합에 의해 기계적으로 결정된다고 해도 과언이 아니다.

💡 알아두세요! 척도 구분의 황금률
• 명목척도(Nominal Scale): 분류 목적의 척도. 산술 연산이 불가능하며 단순 집단을 구분한다. (예: 성별, 거주지역, 구매여부)
• 서열척도(Ordinal Scale): 순서와 등급이 존재하나 간격이 동일하지 않다. (예: 직급, 학력 수준, 만족도 순위)
• 등간척도(Interval Scale): 속성의 간격이 동일하며 임의의 원점(0이 '없음'을 뜻하지 않음)을 가진다. (예: 리커트 5점/7점 척도, 온도)
• 비율척도(Ratio Scale): 절대 영점(0은 부재를 의미)이 존재하고 사칙연산이 모두 가능하다. (예: 매출액, 연령, 재방문 횟수, 근무연수)


독립·종속변수 척도별 통계 기법 매핑 매트릭스 📊

연구 가설에서 설정한 원인 변수(독립변수, Independent Variable)와 결과 변수(종속변수, Dependent Variable)를 대입해보자.


설문지에서 주로 활용하는 리커트 5점(or 7점) 척도는 통상 학술 연구에서 등간척도(연속형 변수)로 간주하여 평균 분석이나 회귀분석, 구조방정식에 적극 활용한다.

주요 통계 기법 결정 기준표

                 가설 목적       독립변수(X)   종속변수(Y)              추천 분석 기법
두 집단 간 평균 차이 검증 범주형
(명목 2개 집단)
연속형
(등간/비율)
독립표본 t-검정
(Independent t-test)
세 집단 이상 평균 차이 검증 범주형
(명목 3개 이상 집단)
연속형
(등간/비율)
일원배치 분산분석
(One-way ANOVA)
인과적 영향력 및 예측 연속형
(단일/복수)
연속형
(등간/비율)
다중회귀분석
(Multiple Regression)
이분형 사건 발생 예측 연속형 또는 범주형 이분형 명목
(성공/실패 등)
로지스틱 회귀분석
(Logistic Regression)
다차원 인과망 및 매개/조절 검증 잠재변수
(다문항 측정)
잠재변수
(다문항 측정)
구조방정식모델(SEM: Structural Equation Modeling)
⚠️ 주의하세요! 흔히 저지르는 치명적 오류
1) 세 집단 이상의 차이를 보려고 t-검정을 3번 반복해서 돌리면 제1종 오류(Type I Error)가 누적되어 왜곡이 발생한다. 반드시 ANOVA(분산분석)와 사후검정(Post-hoc test)을 거쳐야 한다.
2) 독립변수가 범주형(예: 성별, 학력)인데 일반 다중회귀분석을 돌리려면 반드시 더미변수(Dummy Variable) 처리를 해야 한다.


실무 연구 시나리오: 회귀분석 vs 구조방정식모델(SEM) 👩‍💼👨‍💻

많은 연구자분들이 회귀분석과 SEM(구조방정식) 사이에서 가장 큰 고민을 한다.

"둘 다 인과관계를 보는 건데, 굳이 복잡한 SEM을 돌려야 하나요?"라는 질문을 정말 많이 받는다. 결정적 차이는 '측정 오차 통제'와 '동시 검증 능력'에 있다.


📌 알아두세요! 언제 SEM으로 넘어가야 할까?
1. 독립변수, 매개변수, 종속변수와 같이 변수가 동시에 원인이자 결과가 되는 복합 경로가 존재할 때
2. 설문지 다문항(예: 브랜드 태도 4문항, 신뢰도 5문항)의 측정 오차(Measurement Error)를 제거하고 순수한 잠재개념 간 계수를 얻고자 할 때
3. 모델 전체의 적합도 지수(CMIN/DF, CFI, TLI, RMSEA 등)를 종합적으로 입증해야 할 때


실전 예시: 논문 가설과 분석 매핑 사례 📚

실제 프랜차이즈 카페 고객 만족도 연구를 진행한다고 가정하고, 가설 설계부터 분석 기법 매핑까지 전개해보겠다.

연구 배경 및 수집 데이터

  • 변수 A: 성별 (남성/여성 - 명목척도 2개)
  • 변수 B: 방문 빈도 (월 1~2회, 주 1~2회, 주 3회 이상 - 서열/명목척도 3개)
  • 변수 C, D, E: 서비스 품질(원인), 고객 만족도(매개), 재방문 의도(결과) - 각 4~5문항 리커트 5점 척도

가설별 기법 매핑 프로세스

가설 1: "성별에 따라 고객 만족도에 차이가 있을 것이다." 독립표본 t-검정 (2개 집단 평균 비교)

가설 2: "방문 빈도 집단에 따라 재방문 의도에 차이가 있을 것이다." 일원배치 분산분석(ANOVA) (3개 집단 평균 비교)

가설 3: "서비스 품질은 고객 만족을 매개로 재방문 의도에 유의한 영향을 미칠 것이다." 구조방정식모델(SEM) 또는 부트스트래핑 기반 매개회귀분석(Process Macro)

분석 결과 해석 방향

- t-검정 결과 p < .05 여부를 통해 집단 간 유의차 확인

- 구조방정식 모형 적합도를 먼저 입증한 뒤 경로계수(Path Coefficient)의 통계적 유의성을 해석

이처럼 연구 모델이 복잡해 보여도, 각 가설의 문장 구조를 뜯어보면 매핑해야 할 통계 기법은 단 하나로 귀결된다. 변수 유형을 명확히 정의하는 순간 고민의 90%는 해결되는 셈이다.


핵심 내용 요약 📝

논문 통계 분석 기법의 선정은 가설의 타당성을 입증하는 뼈대이자 연구의 신뢰도를 좌우하는 나침반이다.

아무리 복잡한 데이터 분석이라도 기본 공식은 동일합니다. 여러분의 연구 모델 속 독립변수와 종속변수 척도를 다시 한번 점검해보자. 

 
💡

가설-통계기법 매핑 핵심 요약

✨ 2개 집단 차이: 독립표본 t-검정 (독립: 2범주 명목 / 종속: 연속형)
📊 3개 이상 집단 차이: 일원배치 분산분석(ANOVA) + 사후검정
👩‍💻 다중 매개 및 잠재변수: 구조방정식모델(SEM) (측정오차 통제 및 통합 추정)

자주 묻는 질문 ❓

Q: 리커트 5점 척도는 서열척도인데 왜 회귀분석이나 평균 비교가 가능한가요?
A: 엄밀한 수학적 정의상 서열척도이지만, 사회과학 및 경영학 실무 연구에서는 각 점수 간 간격이 일정하다고 가정하여 등간척도(연속형 변수)로 간주하고 모수통계(t-test, ANOVA, 회귀분석, SEM)를 적용하는 것이 일반적인 학술적 관례입니다.
Q: 3개 집단 차이를 볼 때 t-검정을 여러 번 돌리면 왜 안 되나요?
A: 유의수준 5% 기준으로 검정을 3회 반복하면 전체 검정에서 귀무가설이 참인데도 기각할 확률(제1종 오류 누적)이 약 14.3%까지 치솟기 때문입니다. 따라서 분산분석(ANOVA)으로 전체 차이를 검증한 뒤 사후검정을 거쳐야 합니다.
Q: 독립변수가 성별이나 직업 같은 범주형일 때 회귀분석을 돌리려면 어떻게 하나요?
A: 더미변수(Dummy Variable) 변환 기법을 사용해야 합니다. k개의 범주가 있다면 k-1개의 0과 1로 구성된 가변수를 생성하여 기준 집단(Reference group) 대비 효과로 해석합니다.
Q: 회귀분석의 Process Macro와 구조방정식(AMOS, SmartPLS)의 차이는 무엇인가요?
A: Process Macro는 문항 평균값을 사용하는 관측변수 기반의 다중회귀 경로분석이며, AMOS나 PLS-SEM은 개별 측정 문항의 측정 오차를 분리하여 잠재요인 간의 관계를 검증한다는 구조적 차이가 있습니다. 복합 인과망에는 SEM이 더 권장됩니다.
Q: 정규성(Normality) 검정을 만족하지 못하면 어떤 기법을 적용해야 하나요?
A: 표본 수가 적거나 왜도/첨도가 심해 정규성을 충족하지 못하면 비모수 통계 기법을 사용합니다. t-검정 대신 맨-휘트니 U 검정(Mann-Whitney U), ANOVA 대신 크루스칼-왈리스 검정(Kruskal-Wallis)을 대안으로 채택합니다.

연구가설과 연구모형 설정법: 독립/종속/매개/조절변수 개념 도식화 완벽 가이드


연구가설과 연구모형, 도대체 어디서부터 시작해야 할까요?
독립/종속/매개/조절변수의 개념적 관계를 깔끔하게 도식화하고, 심사위원도 한눈에 납득하는 정교한 가설 진술법을 실전 템플릿과 함께 완벽 정리해 드립니다!


논문이나 학술 연구를 준비하면서 가장 첫 번째로 맞닥뜨리는 거대한 벽, 바로 '연구모형(Research Model)'과 '연구가설(Research Hypothesis)' 설정이다.


머릿속에는 검증해보고 싶은 아이디어가 가득한데, 막상 도면으로 그리고 문장으로 서술하려니 변수들끼리 엉켜서 멘붕에 빠진 적 다들 있으시죠? 😊


저도 현업에서 수많은 연구자와 원생분들을 컨설팅하다 보면


"매개효과랑 조절효과가 도대체 어떻게 다른 건가요?"

"가설 문장은 도대체 어떤 어미로 끝맺어야 하나요?"

라는 질문을 정말 매일같이 듣곤 한다.


개념의 뼈대만 제대로 잡으면 생각보다 아주 명쾌하게 풀리는 작업인데 말이다.


* 이미지 출처 : NotebookLM 내용 요약 생성


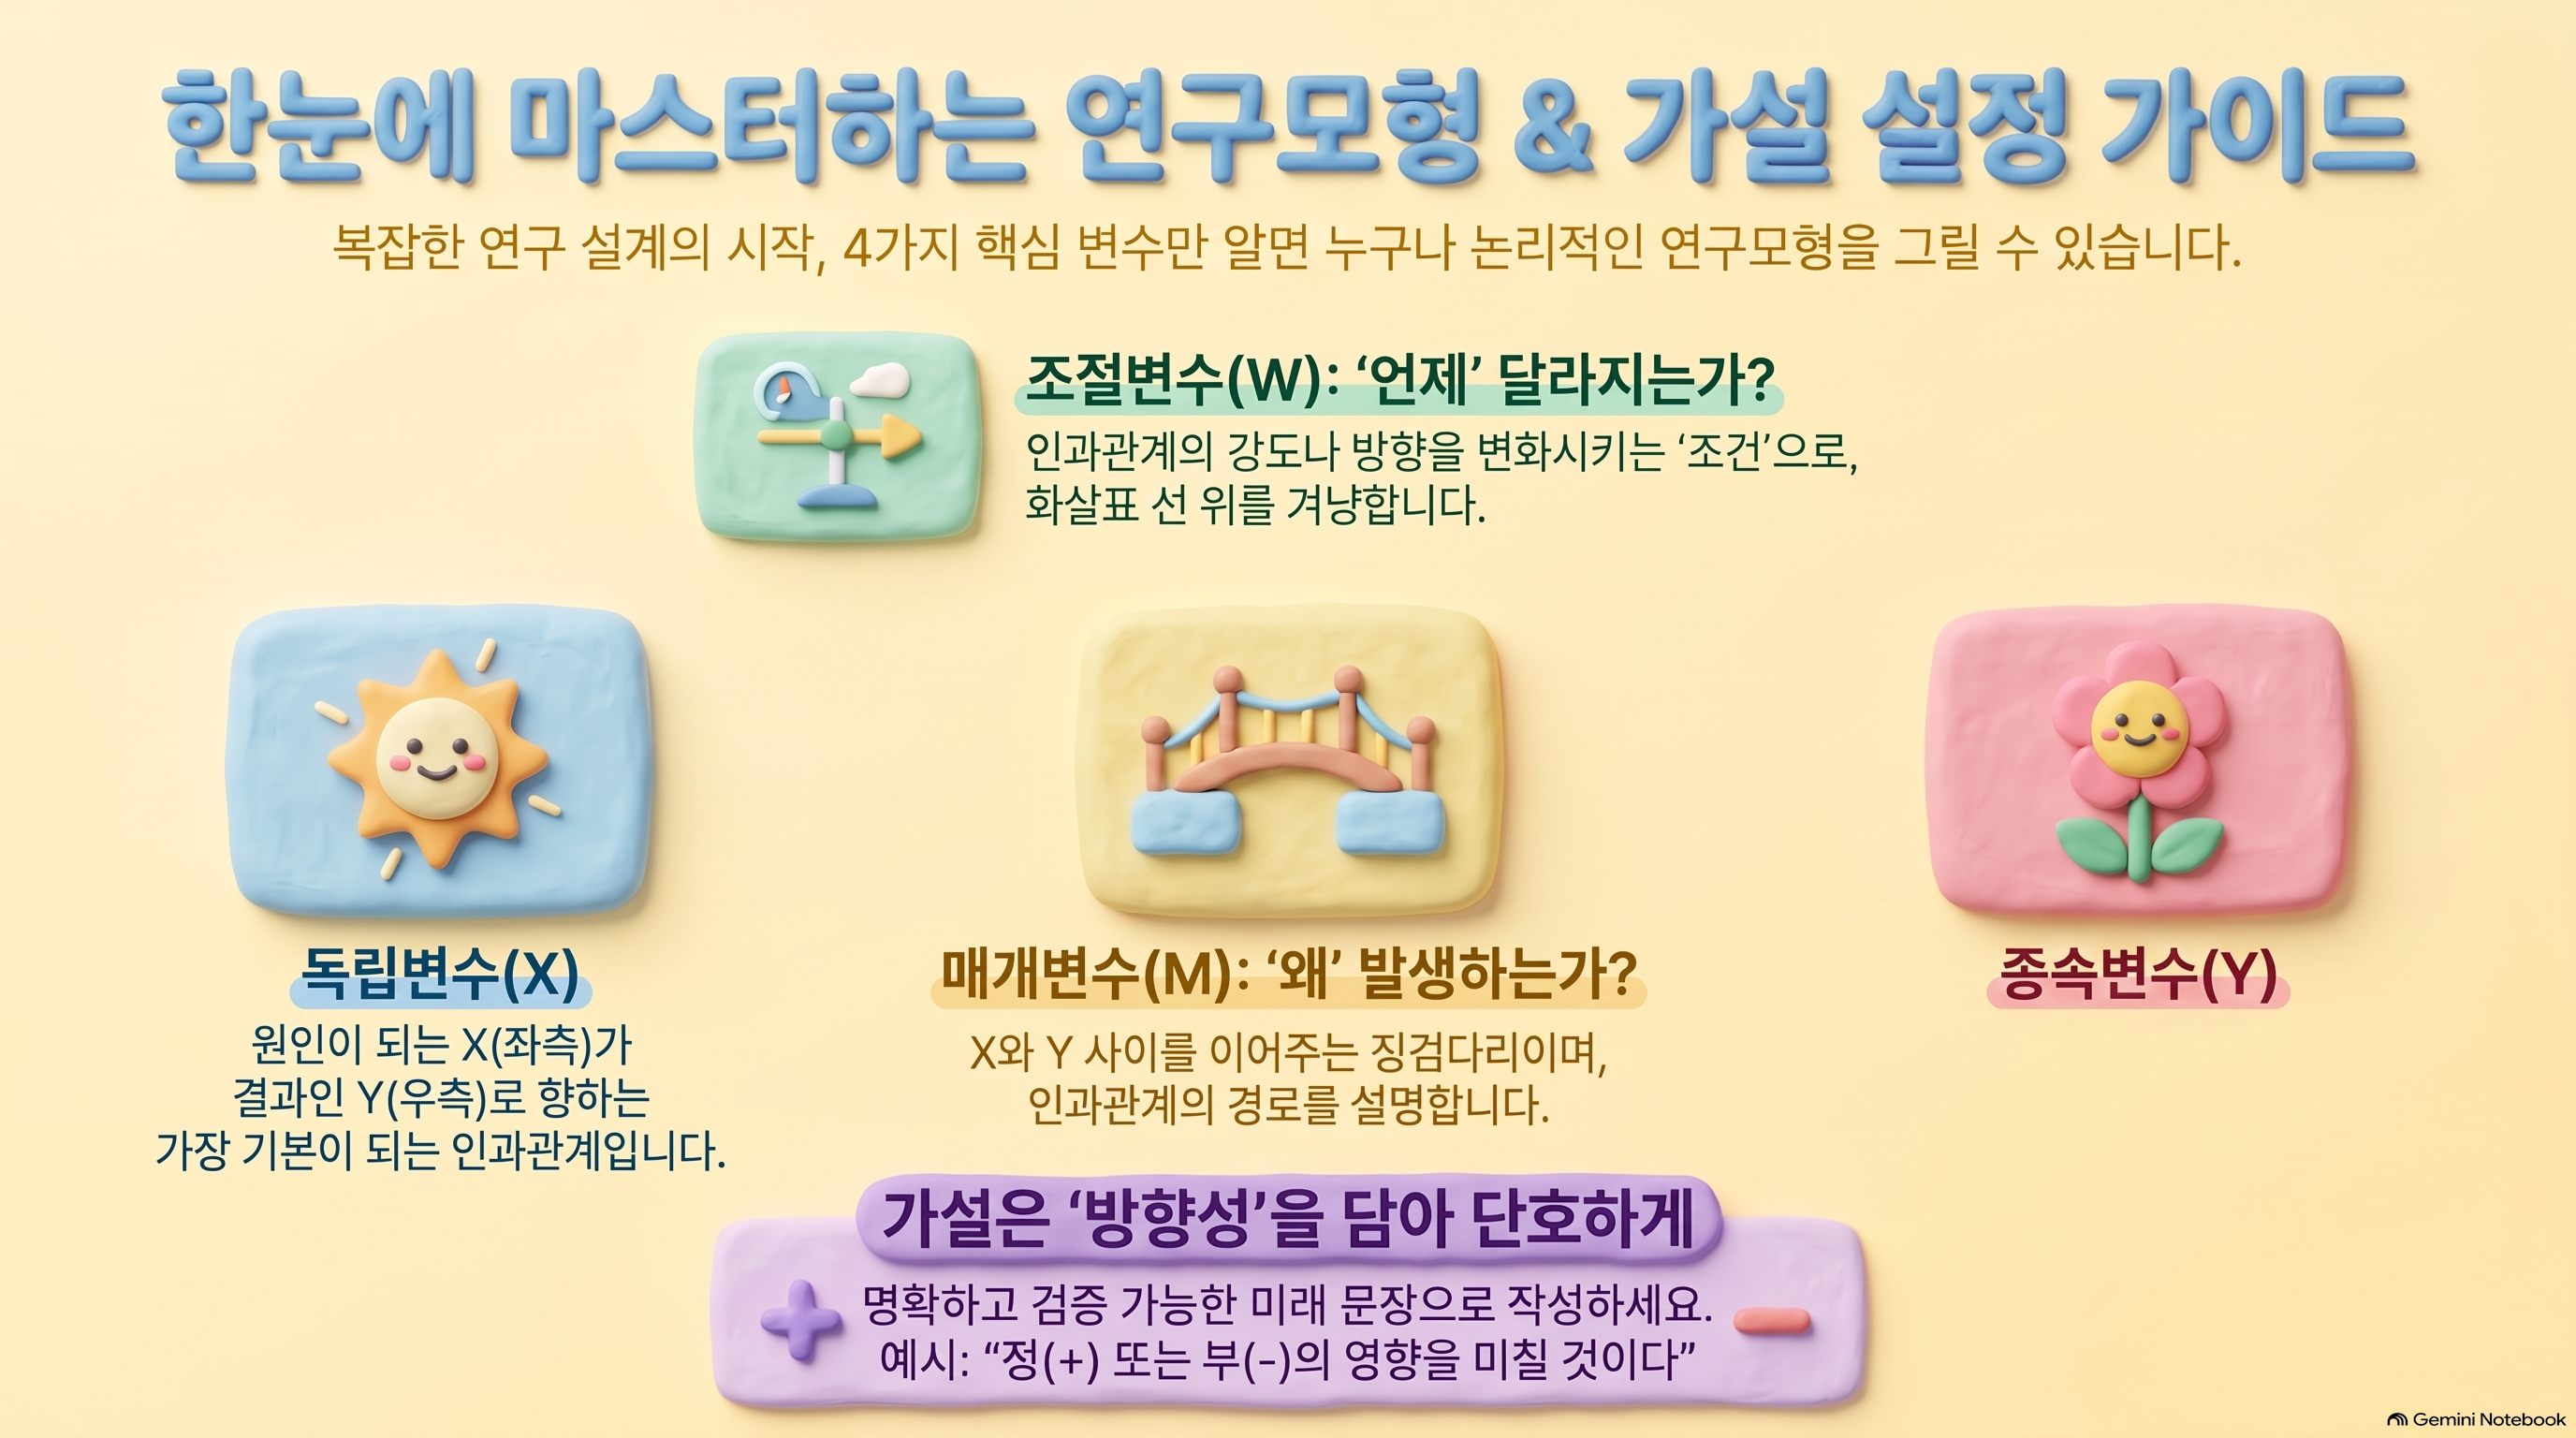
1. 4대 핵심 변수의 역할과 개념 구분 🤔

연구모형을 설계하기 위해서는 모형을 구성하는 기본 블록, 즉 4대 변수의 명확한 역할 정의가 선행되어야 한다.

변수의 속성을 헷갈리면 모형의 화살표 방향 자체가 꼬이게 된다.


가장 기본이 되는 독립변수(Independent Variable)는 다른 변수에 영향을 주는 '원인'이며, 종속변수(Dependent Variable)는 그 영향으로 변화하는 '결과'에 해당한다.


여기에 연구의 깊이를 더해주는 것이 바로 매개변수와 조절변수이다.

💡 알아두세요!
매개변수(Mediating Variable): 원인과 결과 사이를 이어주는 '다리(징검다리, Why/How)' 역할을 한다.
조절변수(Moderating Variable): 원인이 결과에 미치는 영향의 '강도나 방향(When/For whom)'을 달라지게 만드는 조건 역할을 한다.


2. 변수별 특성 비교 및 실전 매핑 📊

논문 지도 과정에서 가장 혼란스러워하는 매개변수와 조절변수의 본질적인 차이를 표로 한눈에 정리해 드린다.

연구 질문을 던질 때 '왜 그런가?'를 파고들면 매개변수가 되고, '언제/누구에게 더 효과적인가?'를 파고들면 조절변수가 된다.

연구모형 4대 변수 속성 비교표

변수 구분 핵심 기능 모형 상의 위치 비즈니스/연구 예시
독립변수 (X) 원인, 입력값, 예측 요인 화살표의 출발점 (맨 좌측) 직무 자율성, 서비스 품질
종속변수 (Y) 결과, 산출값, 최종 영향
변수
화살표가 최종 도달하는 곳 (맨 우측) 이직의도, 재구매의도
매개변수 (M) 인과적 전달 경로
(중간 단계)
X와 Y 사이의 중간 상자 (X → M → Y) 직무만족, 고객신뢰
조절변수 (W) 인과관계의 강도/방향
완충 및 강화
X → Y의 화살표 선 위를 향하는 화살표 조직지원인식, 가격민감도
⚠️ 주의하세요!
선행연구의 이론적 근거(Theoretical Background) 없이 그저 통계적으로 유의한 결과가 나올 것 같다는 이유로 매개변수나 조절변수를 마구 추가하면 연구 심사에서 논리성 결여로 지적받기 쉽다. 모형은 '복잡함'보다 '인과적 당위성'이 우선이다.


3. 관계의 개념적 도식화와 가설 진술 공식 🧮

연구가설은 막연한 서술문이 아니다.

검증 가능하도록 변수 간의 방향성(정(+), 부(-))을 포함하여 명확한 문법적 틀로 표현해야 한다.

📝 가설 진술의 기본 공식

직접효과: "[독립변수]는 [종속변수]에 정(+)/부(-)의 유의한 영향을 미칠 것이다."

매개효과: "[독립변수]와 [종속변수]의 관계에서 [매개변수]는 유의한 매개역할을 할 것이다."

조절효과: "[조절변수]는 [독립변수]가 [종속변수]에 미치는 영향을 유의하게 조절(강화/완화)할 것이다."

실제 모형 도식화(Diagramming)의 핵심 논리는 아래와 같이 간단한 단계로 구성된다.

도식화 및 가설 번호 매기기 단계

1) 1단계: 좌측에 독립변수(X), 우측에 종속변수(Y)를 박스로 배치하고 실선 화살표 연결 (가설 1)

2) 2단계: 중앙 상단에 매개변수(M)를 배치하고 X → M, M → Y 실선 화살표 연결 (가설 2, 가설 3 및 매개효과)

3) 3단계: 상단 또는 하단에 조절변수(W)를 배치하고 X → Y 화살표의 중간 '선'을 겨냥해 화살표 연결 (가설 4

4. 심사위원이 좋아하는 가설 서술의 디테일 👩‍💼👨‍💻

가설을 쓸 때 연구자들이 가장 많이 하는 실수 중 하나가 바로 서술어의 모호함이다.

"영향을 미칠 것이다"라고만 쓰면 양의 영향인지 음의 영향인지 알 수 없어 심사 과정에서 가설의 방향성(Directionality) 부재로 수정 요구를 받기 십상이다.

📌 알아두세요!
1. 방향성을 분명히: "관계가 있을 것이다"보다는 "정(+)의 영향을 미칠 것이다"처럼 방향을 명시하세요.
2. 검증 가능한 종결어미: "~일 것으로 사료된다"가 아니라 학술 표준 양식인 "~할 것이다"라는 단호한 미래 예측형 명제로 진술해야 합니다.
3. 단일 가설 단일 관계: 하나의 가설 번호에 두 개 이상의 종속변수를 묶지 마세요. (예: 만족도와 충성도에 영향을 미칠 것이다 ❌ → 각각 가설 1-1, 1-2로 분리 ⭕)


5. 실전 예시: 논문 연구모형 풀세트 구성 사례 📚

실제 경영학 및 사회과학 분야에서 자주 활용되는 연구 주제를 통해 4가지 변수가 한 모형 안에서 어떻게 어우러지는지 구체적인 예시로 확인해 보자!

연구 주제: 원격근무 환경이 혁신행동에 미치는 영향

  • 독립변수(X): 원격근무 자율성 (직원이 업무 시간/방식을 스스로 결정하는 정도)
  • 종속변수(Y): 혁신행동 (새로운 아이디어를 제안하고 실행하는 행동)
  • 매개변수(M): 심리적 주인의식 (일과 조직에 대해 주도적 책임을 느끼는 심리)
  • 조절변수(W): 디지털 협업도구 역량 (슬랙, 노션 등 협업툴 활용 숙련도)

도출된 연구가설 세트

H1: 원격근무 자율성은 심리적 주인의식에 정(+)의 유의한 영향을 미칠 것이다.

H2: 심리적 주인의식은 혁신행동에 정(+)의 유의한 영향을 미칠 것이다.

H3: 원격근무 자율성과 혁신행동의 관계를 심리적 주인의식이 유의하게 매개할 것이다.

H4: 디지털 협업도구 역량은 원격근무 자율성이 심리적 주인의식에 미치는 정(+)의 영향을 강화(조절)할 것이다.

설계 총평

원인(자율성)이 심리적 기제(주인의식)를 거쳐 결과(혁신행동)로 이어지는 흐름이 매우 자연스러우며, 개인 역량(협업도구 숙련도)에 따라 그 효과가 증폭된다는 조절효과까지 탄탄하게 논리적 구조를 갖추었다.


핵심 내용 요약 📝

연구모형과 연구가설은 단순히 통계 패키지를 돌리기 위한 수단이 아니라,

연구자가 세상을 바라보는 인과적 렌즈이자 연구의 지도와 같다.


처음부터 거창한 다중매개나 조절된 매개모형에 도전하기보다는,

오늘 살펴본 독립·종속·매개·조절의 4각 구도를 먼저 명확하게 다져보자.😊

 
💡

연구모형 & 가설설정 마스터 가이드

✨ 매개 vs 조절 구분: 매개는 왜(Why)/경로, 조절은 언제(When)/조건을 의미합니다.
📊 도식화 표준 규칙: 독립변수는 좌측 박스, 종속변수는 우측 박스, 조절효과는 화살표 선을 가리킵니다.
🧮 표준 가설 진술 공식:
직접가설 = X는 Y에 정(+)/부(-)의 영향을 미칠 것이다.
👩‍💻 심사 통과 핵심: 모호한 서술어를 버리고 방향성(+/-)과 검증 가능한 서술어를 확실히 지정하세요.

자주 묻는 질문 ❓

Q: 연구가설에 왜 꼭 정(+)이나 부(-)의 방향성을 명시해야 하나요?
A: "영향을 미친다"는 서술은 양측검정 시 모호함을 유발할 수 있습니다. 선행연구에 기반한 명확한 이론적 기대 방향을 정(+) 또는 부(-)로 제시해야 연구의 가설 기각/채택 기준이 명료해집니다.
Q: 매개변수와 조절변수를 하나의 모형에 함께 넣어도 되나요?
A: 가능합니다. 이를 통계학적으로 '조절된 매개효과(Moderated Mediation)' 또는 '매개된 조절효과(Mediated Moderation)'라고 부르며, 최근 많은 석박사 학위논문에서 활발히 채택하고 있습니다.
Q: 조절변수를 도식화할 때 왜 변수 박스가 아니라 화살표를 향하게 그리나요?
A: 조절변수는 종속변수 자체를 직접 변화시키는 것이 아니라, 독립변수가 종속변수에 미치는 '관계(영향력의 기울기)' 자체를 변화시키는 것이기 때문에 화살표 선 위로 연결하여 상호작용항을 개념화합니다.
Q: 통제변수(Control Variable)는 연구모형에 어떻게 표시하나요?
A: 통제변수는 보통 모형의 하단이나 종속변수 바로 아래에 별도 영역으로 두고, 종속변수로 향하는 점선 화살표로 연결하여 핵심 가설 검증 변수와 시각적으로 구별합니다.
Q: 가설 검증 결과 기각(Not Supported)되면 논문 작성을 실패한 건가요?
A: 전혀 아닙니다. 표본의 특수성이나 새로운 환경적 요인으로 인해 기각된 이유를 논리적으로 고찰(Discussion)하는 것 자체가 학술적으로 매우 가치 있는 기여가 됩니다.

석·박사 논문 선행연구 몇 편이나 읽어야 할까? 플랫폼별 검색 전략과 인용 기준


선행연구 조사, 어디서부터 시작하고 몇 편이나 읽어야 할까요?
RISS, DBpia, Google Scholar를 효과적으로 활용해 핵심 논문을 압축 선별하고, 학위 논문 심사를 통과하는 적정 인용 편수 기준을 확실하게 정리해 드립니다!


논문 작성을 결심하고 검색창을 열었을 때, 쏟아지는 수천 편의 자료 앞에서 눈앞이 캄캄해진 경험 다들 있으실 거다.

"도대체 어떤 자료부터 읽어야 하지?"
"남들은 몇 편이나 인용할까?"

밤새 모니터를 노려보다가 머리만 지끈거렸던 기억, 저 역시 대학원 시절 뼈저리게 겪어봤다. 😅

수많은 연구자가 저지르는 가장 흔한 실수는 닥치는 대로 논문을 다운로드해 쌓아두기만 하는 '자료 수집증'에 빠지는 일이다.


선행연구 조사는 단순히 활자를 많이 읽는 노동이 아니라, 내 연구의 좌표를 찍는 전략적인 지도 그리기 과정이다.


* 이미지 출처 : NotebookLM 내용 요약 생성


선행연구 조사의 출발점: 학술 플랫폼 3대장 공략법 🤔

논문 조사의 시작점은 무작정 구글 일반 검색을 돌리는 것이 아니다.

국내외 학술 DB의 특성을 파악하고 연구 단계에 맞춰 순서대로 접근하는 것이 시간과 체력을 아끼는 지름길이다.


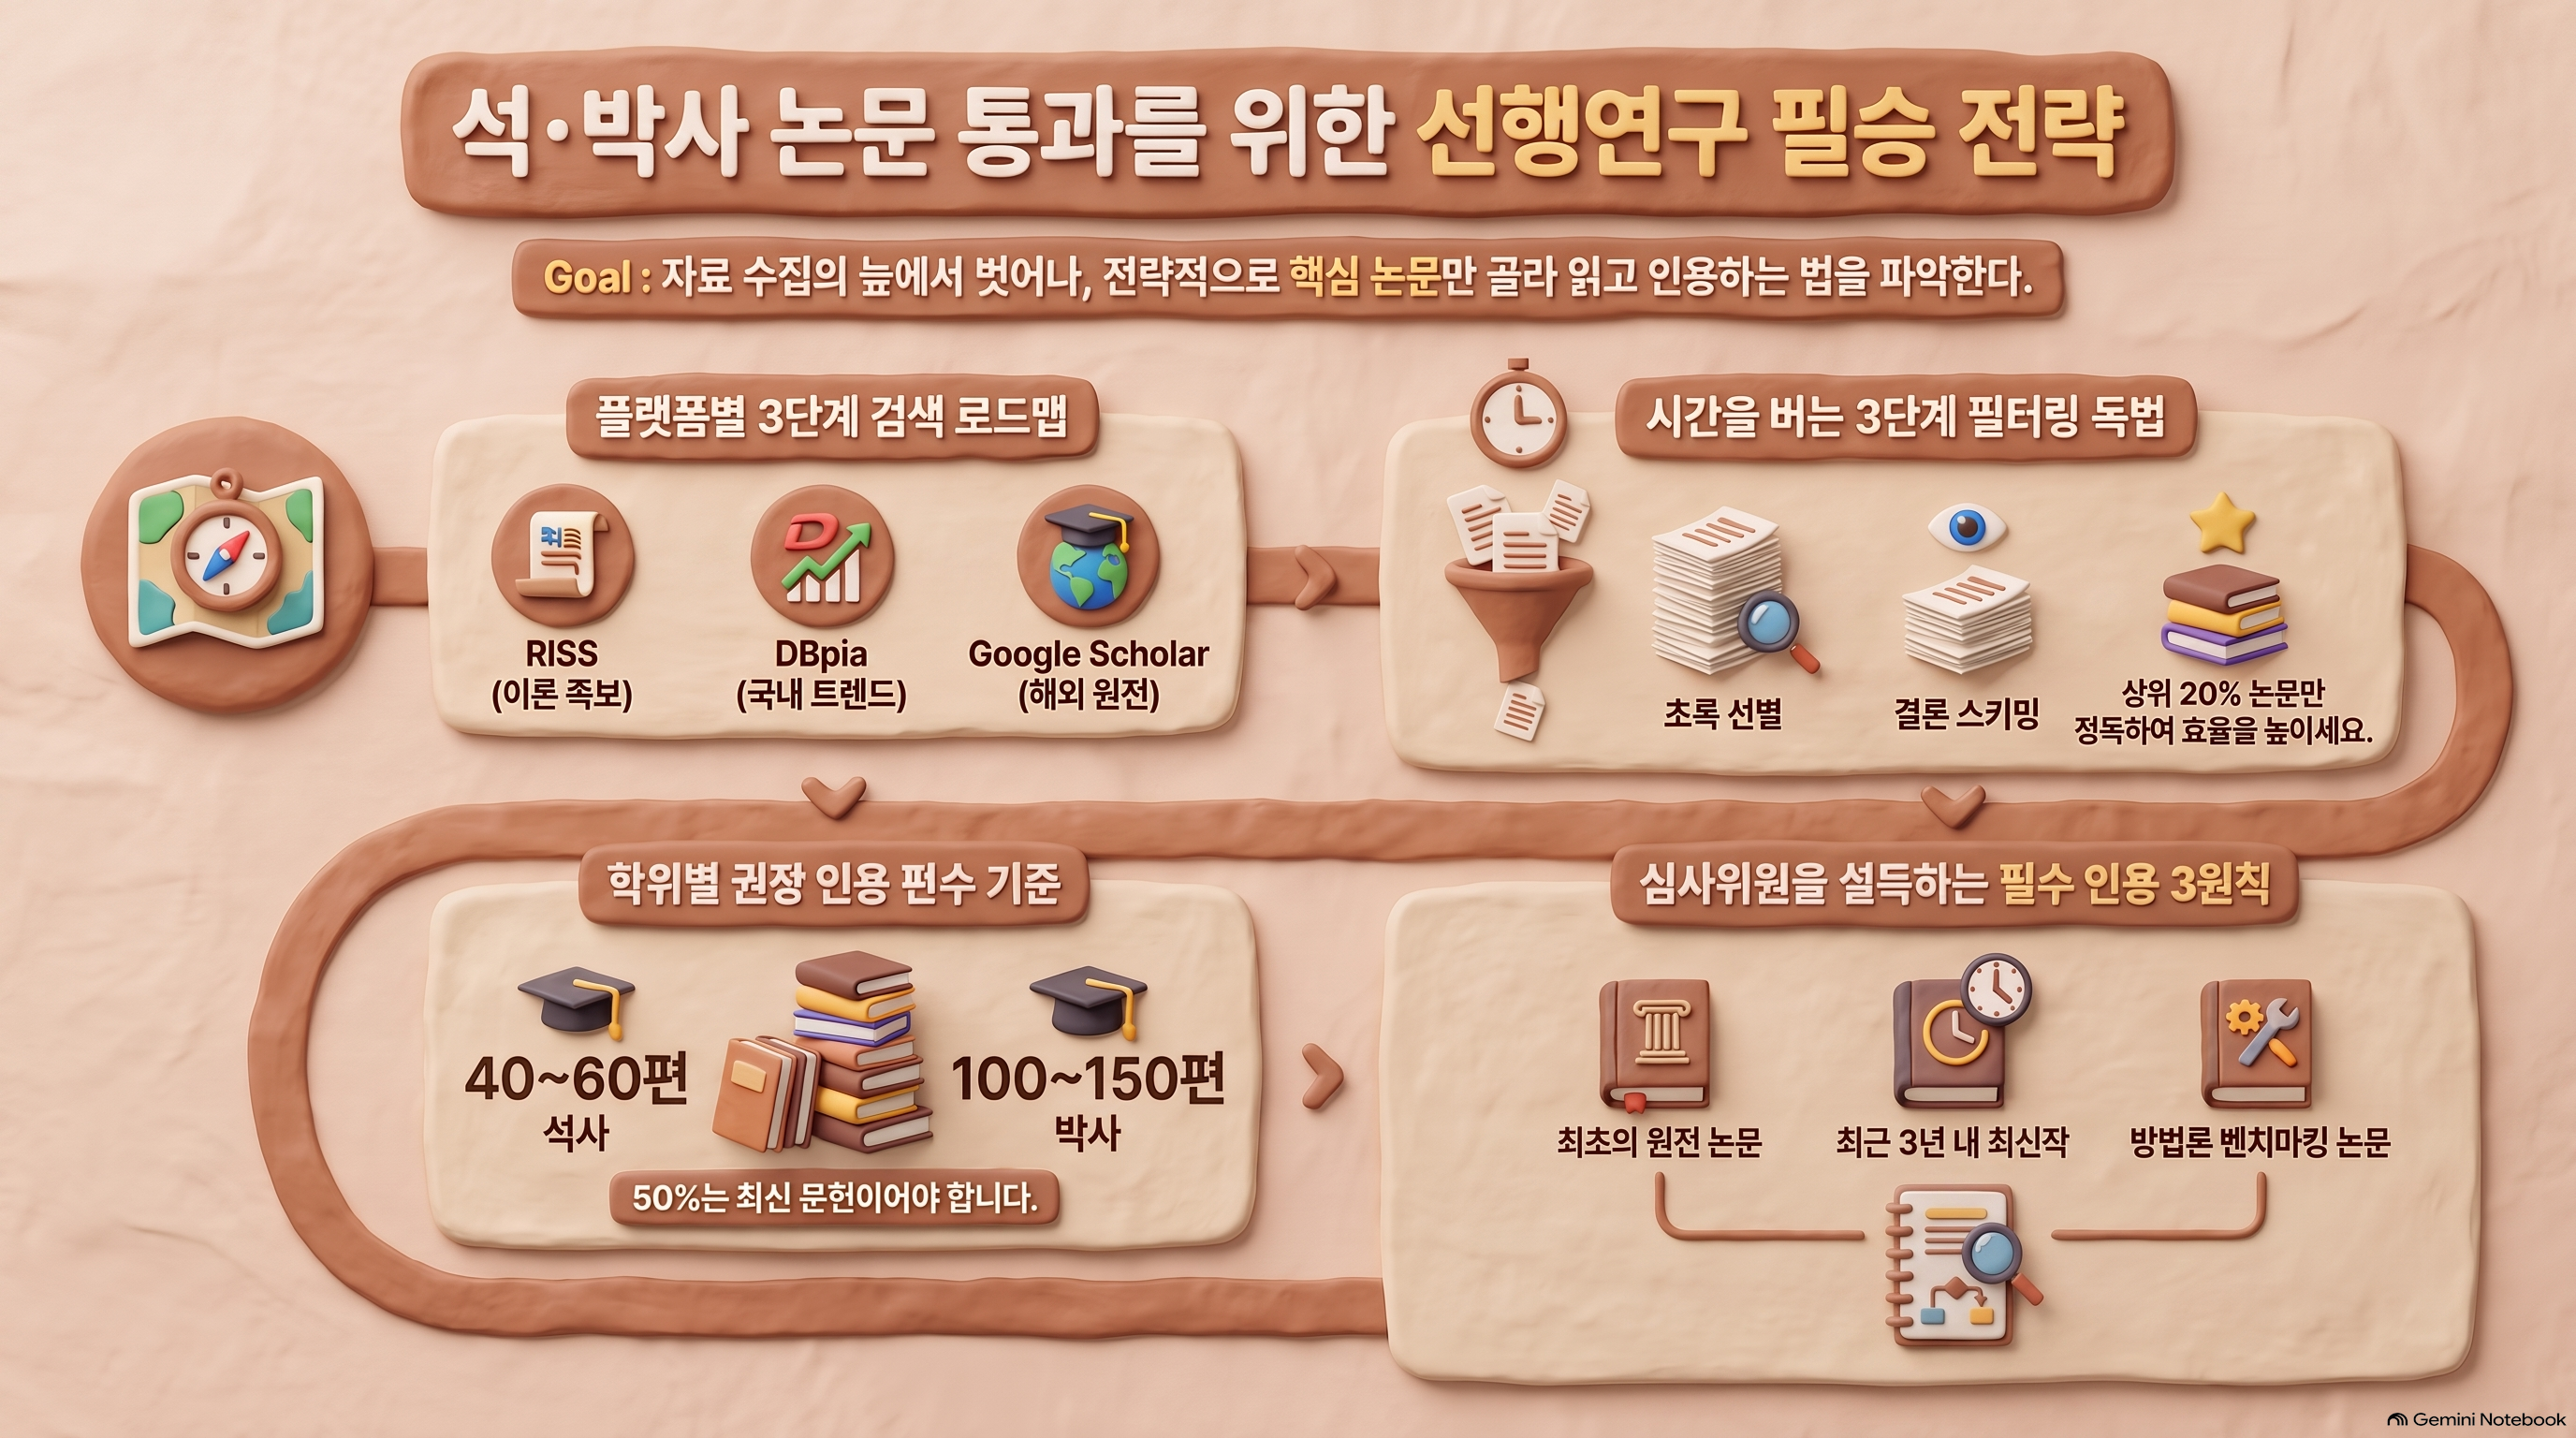
가장 먼저 RISS(학술연구정보서비스, Research Information Sharing Service)에서 최근 3~5년 이내에 통과된 최신 석, 박사 학위논문을 검색하자!


학위논문은 선행연구 챕터(제2장 이론적 배경)가 매우 방대하게 정리되어 있어, 해당 분야의 주요 이론과 핵심 참고문헌 족보를 한눈에 파악하는 '치트키'가 되어준다.


그다음 DBpia(디비피아)와 같은 국내 학술지 플랫폼을 통해 KCI(한국학술지인용색인, Korea Citation Index) 등재지에 실린 검증된 학술 논문을 찾아 개념 정의와 연구 가설의 타당성을 보강해야 한다.


마지막으로 Google Scholar(구글 스칼라)를 활용해 해외 SSCI(Social Sciences Citation Index)급 저널의 원류 논문과 인용 수(Cited by)가 높은 고전 명저를 크로스체크하면 완벽한 기초 틀이 완성된다.


💡 알아두세요!
RISS에서 검색할 때는 '학위논문' 탭을 먼저 확인하고, 목차에서 [제2장 이론적 배경] 및 [참고문헌]을 가장 먼저 확인하자. 선행 연구자가 이미 정리해 둔 참고문헌 리스트를 역추적하는 '스노우볼링(Snowballing)' 기법을 쓰면 검색 시간을 절반 이상 단축할 수 있다.


플랫폼별 특성과 선별 전략 한눈에 보기 📊

각 학술 플랫폼은 데이터베이스 구축 목적과 제공하는 문서의 성격이 확연히 다르다.
내 연구 설계 단계에 최적화된 플랫폼을 짝지어 활용하는 전략이 논문의 완성도를 결정짓는다.

학술 데이터베이스 비교 및 활용 가이드

플랫폼 주요 특징 추천 검색 목적 선별 팁
RISS 국내 석·박사 학위논문 및 대학 도서관 통합 소장 자료 제공 연구 초기 프레임워크 벤치마킹 및 이론적 배경 족보 확보 최근 3년 이내 박사학위 논문 우선 다운로드
DBpia / KISS 국내 주요 등재(후보) 학술지 논문 원문 서비스 특화 연구 가설 검증, 실증 분석 모형 및 최신 국내 연구 트렌드 분석 KCI 우수등재 및 한국연구재단 지원 논문 위주 필터링
Google
Scholar
글로벌 학술 저널, 프리프린트, 인용 색인 네트워크 집약 해외 주요 SSCI/SCI 학술지 논문 탐색 및 척도 원전 확인 '인용 횟수' 클릭 후 후속 연구 계통도 추적
Web of
Science
엄격한 심사를 거친 글로벌 국제 공인 저널 색인 박사학위 논문 및 해외 투고용 연구의 이론적 엄밀성 확보 JCR 저널 랭킹 Q1/Q2 등급 논문 우선 선정
⚠️ 주의하세요!
검색된 모든 논문을 처음부터 끝까지 정독하려 들면 지쳐서 완주할 수 없다.
1단계로 [제목과 초록(Abstract)]을 읽고 버릴 논문을 걸러내고, 2단계로 [연구결과 표와 결론]을 훑은 뒤, 정말 내 연구 모형과 직결되는 상위 10~20% 논문만 정독(Deep Reading)하는 3단계 스키밍 방식을 사수해야 한다.


학위 수준별 권장 인용 편수와 계산 공식 🧮

"그래서 도대체 몇 편을 인용해야 심사위원을 납득시킬 수 있을까?"
연구자들이 가장 궁금해하는 대목이다.
학문 분야마다 편차는 있지만, 국내 대학원 심사 기준에서 통용되는 황금 비율이 존재한다.

📝 선행연구 수집 및 인용 목표 공식

최종 인용 논문 수 = 수집 및 스키밍 논문 수 × 선별율(약 30~40%)

학위 논문 유형별 표준적인 인용 편수 기준은 다음과 같다.

1) 일반 학술지 논문(KCI): 최소 20~30편 인용 (국내외 비율 6:4 권장)

2) 석사학위 논문: 최소 40~60편 인용 (기초 수집 약 120~150편 필요)

3) 박사학위 논문: 최소 100~150편 이상 인용 (국제 저널 50% 이상, 수집 약 300편 필요)

→ 인용 논문의 최소 50% 이상은 반드시 최근 5년 이내 발행된 최신 문헌이어야 한다.

실패 없는 핵심 논문 선별 3원칙 👩‍💼👨‍💻

논문을 많이 인용한다고 무조건 좋은 평가를 받는 것은 결코 아니다.
심사위원들이 선행연구 검토 챕터에서 가장 중요하게 보는 요소는 '연구의 논리적 계보'이다.

첫째, 해당 연구 분야의 시초가 되는 '오리지널 원전 논문'을 반드시 포함하자!
예를 들어 특정 기술수용의향을 본다면 Davis(1989)의 기술수용모델(TAM, Technology Acceptance Model) 원전은 인용수에 관계없이 무조건 들어가야 한다.

둘째, 내 연구 주제와 직결되는 '최근 3년 이내의 최신 논문'을 전체 참고문헌의 40% 이상 배치하여 연구의 시의성을 증명해야 한다.

📌 알아두세요!
셋째, 내 연구 설계와 동일한 연구 방법론(예: 회귀분석, 구조방정식, 델파이 기법 등)을 적용한 '방법론 벤치마킹 논문'을 최소 3편 확보하자. 이는 연구 모형과 가설 설정뿐 아니라 추후 실증 분석 결과 해석 시 결정적인 논거가 된다.


실전 예시: 석사 연구자의 4주 완성 선행연구 로드맵 📚

실제 컨설팅 현장에서 지도했던 직장인 대학원생 김 연구원님의 선행연구 수집 및 선별 성공 사례를 공유해 드린다. 길을 모를 때는 남들의 성공적인 표준 프로세스를 그대로 따라 해보는 것이 가장 확실하다.

연구자의 초기 고민 상황

  • 상황: 석사 3차 학기, 'AI 기반 스마트 물류 플랫폼 수용 의도' 연구 착수
  • 문제점: DBpia 검색 시 관련 논문 800편 노출, 어떤 논문을 읽어야 할지 몰라 2주간 제자리걸음

4주 실전 압축 실행 과정

1) 1주차(RISS 학위논문 공략): 유사 주제 박사학위 논문 5편을 다운로드해 [제2장 이론적 배경] 공통 인용 문헌 30편을 역추적 엑셀 정리

2) 2주차(DBpia & Google Scholar 결합): Davis(1989) TAM 원전 논문 확보 및 최근 3년간 KCI 등재지 논문 40편 스키밍(초록·결론 위주)

3) 3주차(정밀 선별 및 매트릭스 표 작성): 연구 모형과 직접 일치하는 정독 대상 논문 25편 압축, 변수 정의 매트릭스 작성

4) 4주차(본문 인용 작성): 이론적 배경 초안 완성 및 참고문헌 포맷 정리

최종 정량적 산출 결과

- 총 수집 논문: 140편 (스키밍 검토 완료)

- 최종 논문 본문 인용: 52편 (국내 등재지 32편, 해외 SSCI 및 원전 20편 인용으로 예비심사 무수정 통과)

이처럼 전체 풀을 120~150편으로 설정하고,
단계별 필터링을 거쳐 50편 내외로 좁혀나가는 구조적 루틴을 따르면 논문 작성이 막막한 미로가 아니라 단계별 퀘스트처럼 명확해진다.


핵심 내용 요약 📝

선행연구 조사는 단순히 남의 지식을 복사해 붙여넣는 과정이 아니라,
내 연구가 왜 지금 꼭 필요한지를 증명하는 '존재의 근거'를 다지는 일이다.

모든 논문을 처음부터 정독하겠다는 완벽주의를 내려놓자!
RISS의 학위논문으로 큰 그림을 잡고, DBpia와 Google Scholar로 최신 연구와 고전 원전을 채워 넣는다면 여러분의 연구는 심사위원들 앞에서 더없이 단단해질 거다. 

 
💡

선행연구 조사 핵심 로드맵 요약

✨ 탐색 출발점: RISS 박사학위 논문의 이론적 배경과 참고문헌 족보를 먼저 역추적하라!
📊 플랫폼 분업: DBpia(국내 KCI 최신 트렌드) + Google Scholar(고전 원전 및 해외 SSCI) 결합.
🧮 적정 인용 공식:
학술지 20~30편 / 석사 40~60편 / 박사 100~150편 (최근 5년 이내 문헌 50% 유지)
👩‍💻 효율적인 리딩법: 초록 선별 → 결론 스키밍 → 상위 20%만 정독하는 3단계 필터링 사수!

자주 묻는 질문 ❓

Q: 선행연구는 무조건 최근 논문만 인용해야 하나요?
A: 그렇지 않습니다. 이론의 뼈대가 되는 최초 개념 창시자의 '원전 논문'은 발표 시기와 무관하게 반드시 인용해야 합니다. 일반적으로 원전 논문 10~20%, 최근 5년 이내의 실증 논문 50% 이상, 그 외 발전 단계의 논문 30% 비율을 구성하는 것이 가장 이상적입니다.
Q: RISS 학위논문과 학술지 논문 중 어떤 것을 더 많이 인용해야 하나요?
A: 학위논문은 연구의 전체적인 목차와 척도를 참고하는 데 매우 유용하지만, 최종 인용 참고문헌에는 심사를 거쳐 검증된 '학술지 논문(KCI, SSCI 등)'의 비중이 70% 이상을 차지해야 심사위원에게 학술적 엄밀성을 인정받을 수 있습니다.
Q: 수집한 논문들은 어떤 방식으로 정리해 두는 것이 가장 좋나요?
A: 엑셀이나 노션(Notion)을 활용해 '연구 매트릭스 표'를 만드는 것을 추천합니다. 열 항목으로 [저자/연도, 학술지명, 독립변수, 매개/조절변수, 종속변수, 표본 및 분석방법, 주요 결론, 내 연구 적용점]을 표 형식으로 한 줄 요약해 두면 나중에 이론적 배경을 집필할 때 엄청난 시간을 아낄 수 있습니다.
Q: 해외 저널 논문(영어 논문)은 반드시 필수적으로 넣어야 하나요?
A: 석사학위 논문의 경우 분야에 따라 국내 학술지만으로 진행하는 경우도 있지만, 통상 20~30% 이상의 해외 핵심 문헌을 포함해야 연구의 질적 신뢰도가 올라갑니다. 특히 박사학위 논문이나 등재지 투고 논문은 글로벌 이론적 배경을 요구하므로 최소 40~50% 이상 해외 저널 인용이 권장됩니다.
Q: 내 연구와 결론이 정반대로 나온 선행연구도 인용 목록에 넣어야 하나요?
A: 네, 반드시 포함하는 것이 좋습니다. 선행연구 간의 상반된 결론(연구의 공백 또는 갭, Research Gap)이야말로 여러분이 이 연구를 수행해야 하는 가장 강력한 타당성이 됩니다. 반대 의견을 함께 제시하고 "이러한 불일치를 규명하기 위해 본 연구를 진행한다"고 논리를 펼치면 논문의 격이 한 단계 올라갑니다.


생성형 AI 논문 작성 허용 범위: 연구 윤리 위반 안 걸리는 4가지 원칙


"ChatGPT로 논문 써도 괜찮을까요?"
챗GPT 등장 이후 연구 현장의 가장 뜨거운 화두입니다. 단순 문장 윤문부터 아이디어 기획, 데이터 분석 보조까지 연구 윤리를 위반하지 않는 생성형 AI의 안전한 활용 가이드라인과 투고 기준을 명확하게 짚어드립니다.


대학원 연구실이나 학회 세미나에 가보면 요즘 원우님들과 교수님들이 입을 모아 하시는 이야기가 있다.

"대표님, 챗GPT 써서 초록 번역하고 문장 매끄럽게 다듬는 것도 연구 부정인가요?"

솔직히 말해서 밤샘 연구에 지친 연구자들에게 생성형 AI는 거부하기 힘든 마법 같은 도구죠. 😊


하지만 한 끗 차이로 훌륭한 연구 조수가 될 수도 있고,

공들여 쓴 학위 논문이나 투고 논문을 한순간에 '표절 및 대필'이라는 나락으로 떨어뜨릴 수도 있다.

연구 윤리 규정의 핵심 잣대와 글로벌 학술 생태계의 표준 대응법을 차근차근 확인해보자다.


* 이미지 출처 : NotebookLM 내용 요약 생성


1. 연구 윤리의 절대 원칙: AI는 '저자(Author)'가 될 수 없다 🤔

가장 먼저 짚고 넘어가야 할 대전제가 있다.


네이처(Nature), 사이언스(Science), 엘스비어(Elsevier) 등 세계적인 학술 출판사와 주요 대학 연구진실성위원회가 내린 공통 결론은 명확하다.


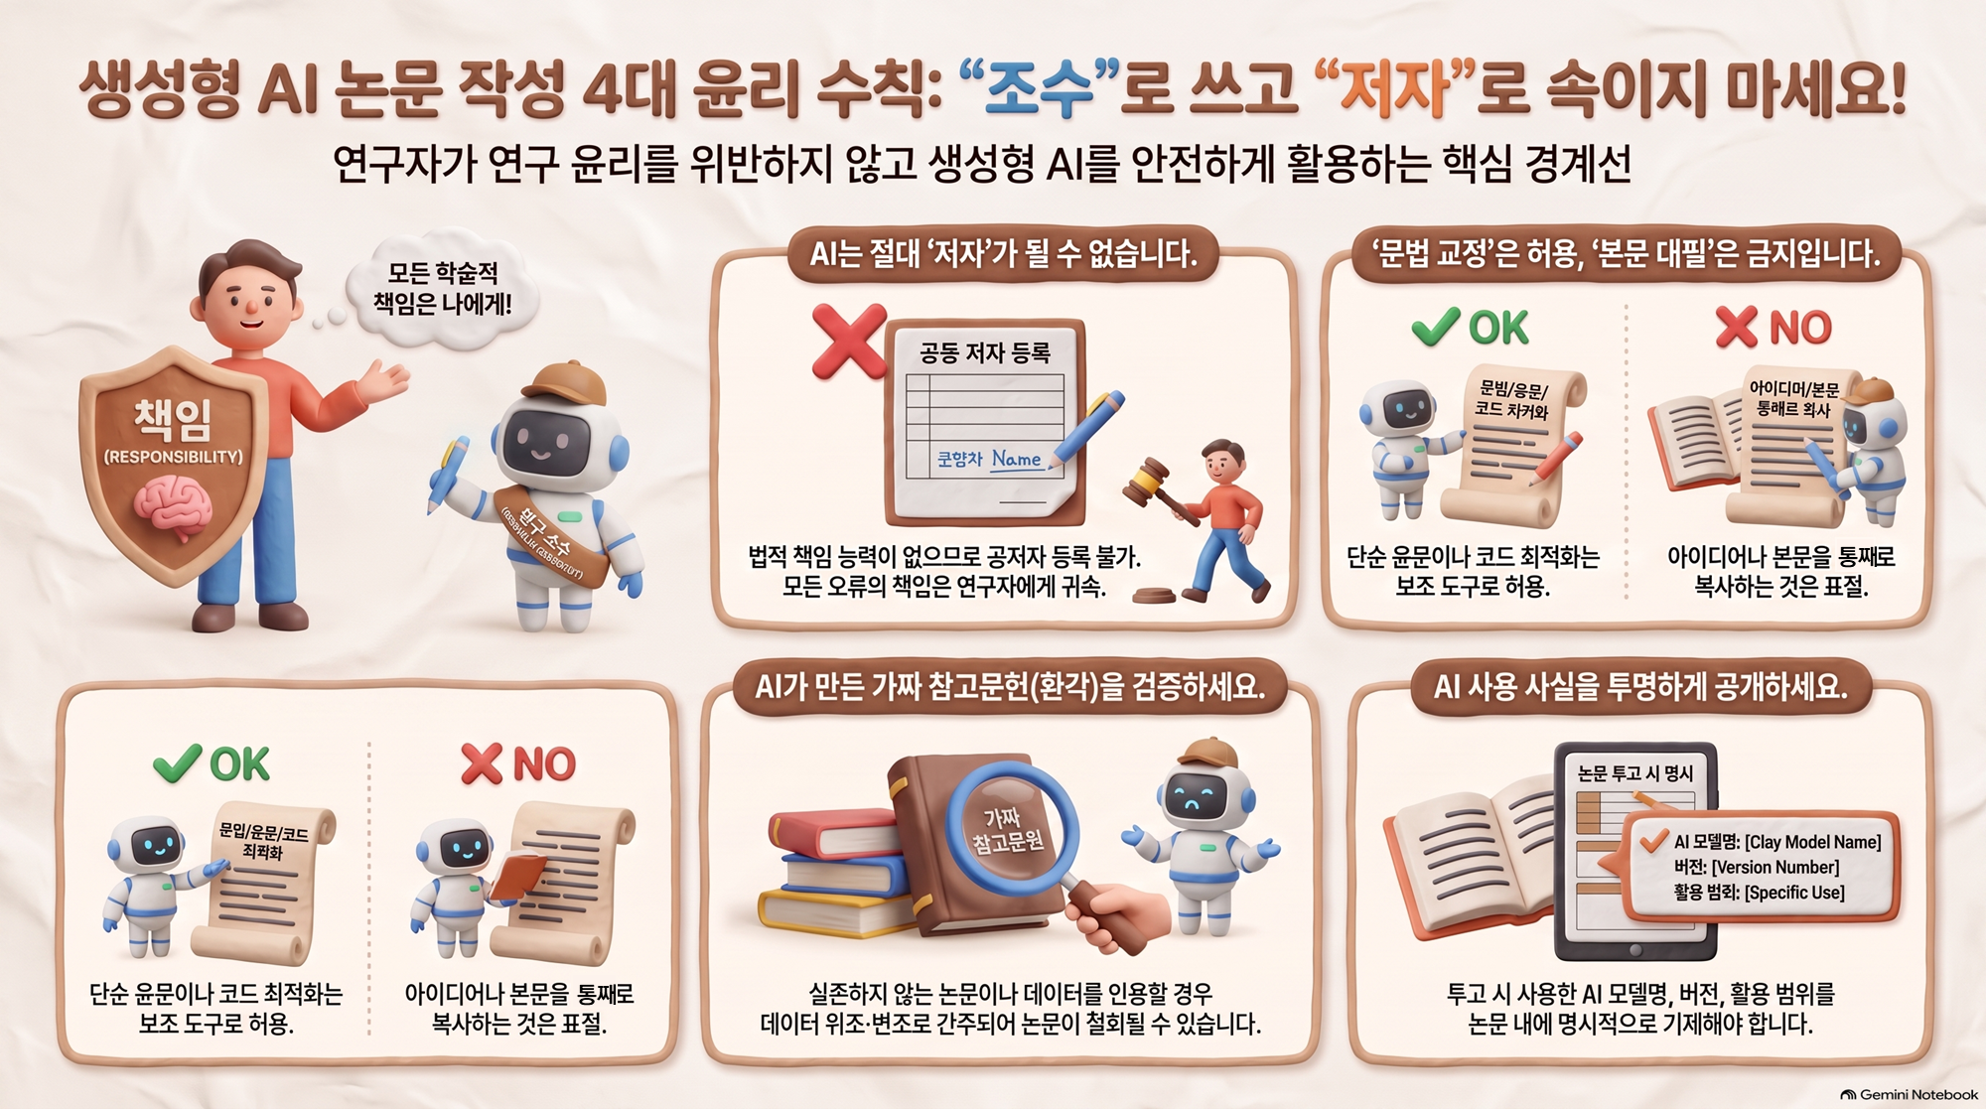
생성형 AI는 절대 공저자로 등재될 수 없다.


논문의 저자가 된다는 것은 단순히 글을 썼다는 것을 넘어,

연구 결과의 진실성과 데이터의 신뢰성, 연구 과정에서 발생하는 모든 학술적, 법적 책임(Accountability)을 온전히 진다는 뜻이다.


인공지능 도구는 법적 인격체가 아니므로 책임을 질 수 없기 때문이다.

💡 핵심 체크 포인트!
AI가 생성한 텍스트에 치명적인 오류나 가짜 인용(환각 현상, Hallucination)이 포함되어 있더라도,
이를 검증하지 않고 투고한 모든 책임은 오롯이 주저자와 교신저자에게 귀속된다.


2. 허용되는 보조 vs 금지되는 대필 영역 비교 📊

그렇다면 구체적으로 연구 과정의 어디까지 쓰고 어디부터 멈춰야 할까요?


연구자의 고유한 지적 노력이 중심에 있는가, 아니면 AI의 텍스트 생성을 무비판적으로 복제했는가가 기준이 된다.


생성형 AI 학술 논문 활용 스펙트럼 비교표

활용 단계 안전한 보조 활용 (권장/허용) 위험/금지 영역 (연구 부정) 투고 시 필수 조치
아이디어 기획 주제 브레인스토밍, 연구 질문 다각화 검토 AI가 도출한 가설을 독창적 가설로 무단 제시 연구자 본인의 논리적 타당성 검증
선행연구 조사 분야별 핵심 키워드 및 주요 학술 DB 검색어 추천 AI가 만든 가짜 참고문헌 인용, 요약문 복사 붙여넣기 원문(DOI) 직접 대조 및 실존 논문 교차 검증
데이터 및 코딩 분석 스크립트(Python, R 등) 문법 오류 수정 원시 데이터 생성(위조/변조), 미검증 가공 데이터 탑재 사용 코드 검증 및 비식별화 처리 준수
원고 집필 및 교정 영문 문법 교정, 문장 다듬기(Paraphrasing) 본문 전체 챕터 대필 생성 및 통째 복사 논문 내 명시적 AI 활용 공개(Disclosure) 기재
⚠️ 환각 현상(Hallucination) 주의보!
ChatGPT는 존재하지 않는 그럴듯한 저자, 저널명, DOI 번호를 놀랍도록 정교하게 지어낸다. 허위 참고문헌을 등재하는 행위는 연구 부정(데이터 위조 및 변조)으로 간주되어 즉시 논문 철회 처분을 받을 수 있다.

3. 투고 논문에 반드시 넣어야 할 명시적 기재법 👩‍💼👨‍💻

국내외 유수 학술지는 이제 "AI를 썼는가?"를 묻지 않고,

"어떻게 공개(Disclosure)했는가?"를 평가한다.


이를 숨겼다가 턴잇인(Turnitin) 등 AI 디텍터에 감지되면 연구 진실성 위반 조사에 회부될 수 있다.

📌 학술지 투고 시 실제 표기 예시 (Methodology 또는 Acknowledgments)
"원고 집필 과정에서 저자(들)는 영문 문법 교정 및 표현 개선을 목적으로 [ChatGPT-4o, OpenAI]를 사용하였다. 도구 사용 후 결과물은 저자에 의해 면밀히 검토 및 수정되었으며, 논문 내용의 최종 전적인 책임은 저자에게 있다."


실전 예시: KCI 등재지 심사 통과 사례 📚

실제 석사 학위 논문을 KCI 우수 등재지에 투고하여 심사를 무사히 통과한 경영학 분야 연구자의 실사례를 살펴보자.

사례 연구자의 AI 작업 방식

  • 본문 작성: 가설 도출, 실증 설문 분석, 고찰 전 과정을 연구자가 직접 우리말로 완독 집필함
  • AI 투입: 영문 초록(Abstract) 번역 및 연구 방법론의 R 스크립트 시각화 코드 최적화에만 국한

조치 및 검증 절차

1) R 스크립트 실행 결과를 로우 데이터와 교차 대조하여 통계값 일치 여부 100% 수작업 확인

2) 투고 시스템 제출 시 '생성형 AI 사용 확인서' 양식에 모델명, 버전, 프롬프트 목적을 명료하게 작성 제출

최종 심사 결과

- 심사위원 평가: "방법론과 분석 코드의 투명성이 높으며, 연구 윤리 규정을 모범적으로 준수함"

- 결과: 무수정 게재 승인(Accept without revision) 판정

핵심은 간단하다.

AI를 '작성자'가 아니라 전문적인 '조수'로 두고, 그 조수에게 맡긴 일의 내역을 학계 동료들에게 숨김없이 오픈하는 것이다.


핵심 내용 요약 📝

생성형 AI는 올바르게 다루면 연구 생산성을 서너 배 이상 끌어올릴 수 있는 훌륭한 날개다.

하지만 날개가 엔진을 대신할 수는 없다.


논문의 영혼이자 핵심인 '독창적 문제의식'과 '데이터에 대한 해석'은 연구자의 고유 영역으로 지켜내셔야 한다. 😊

 
💡

논문 작성 AI 활용 4대 윤리 수칙

저자 자격 배제: AI는 저자가 될 수 없으며, 모든 학술적 책임은 인간 연구자에게 있다.
합법적 보조 허용: 문법 윤문, 코드 디버깅, 개요 구조화는 보조 도구로 전면 허용된다.
금지 영역 엄수:
본문 대필 금지 + 팩트/참고문헌 위조 차단 = 연구 윤리 합격
공개주의 준수: 활용한 도구명, 사용 버전, 활용 챕터를 서문이나 각주에 투명하게 공개한다.


자주 묻는 질문 ❓

Q: 영문 교정 전문 프로그램(Grammarly)이나 챗GPT 윤문도 표기해야 하나요?
A: 단순 철자 교정이나 기초 문법 다듬기는 통상 표기 의무가 면제되는 경우가 많으나, Elsevier 및 다수 저널은 문맥 수정이 대규모로 이루어진 경우 투고 서약서 기재를 명시하도록 강력히 권고합니다.


Q: AI 표절 검사기(Turnitin 등) 점수가 높게 나오면 무조건 탈락인가요?
A: AI 판정 비율은 단지 참고 지표일 뿐입니다. 심사위원회가 실제 원고의 학술적 맥락과 연구자의 기여도를 종합 검토하므로, 투명한 사용 기록과 초고 작성 로그를 보관해 두면 소명이 가능합니다.
Q: 논문 작성 시 AI에게 연구 미공개 데이터를 입력해도 되나요?
A: 절대로 안 됩니다. 무료 버전 챗GPT 등은 입력한 데이터가 모델 학습에 재활용될 수 있어, 특허 출원 전 아이디어나 미공개 임상/실험 데이터가 유출되는 심각한 보안 사고를 야기할 수 있습니다.
Q: 학위 논문 심사 때 교수님이 AI 활용 여부를 물어보시면 어떻게 답변하나요?
A: 사실대로 당당하게 말씀하시되, 연구의 본질적 가설과 데이터 분석 프레임워크는 본인이 직접 기획하고 검증했으며, 언어적 표현 정리에만 보조 도구로 썼음을 구체적인 사례를 들어 설명하시면 됩니다.
Q: 학회마다 가이드라인이 다르면 어디를 따라야 하나요?
A: 무조건 본인이 최종 투고하고자 하는 타깃 저널의 '저자 가이드라인(Author Guidelines)'이 1순위 규정입니다. 규정이 모호할 때는 사전에 편집위원회(Editorial Office)에 이메일로 문의하는 것이 가장 안전합니다.

APA MLA 인용 양식 총정리: 논문 참고문헌 작성법과 EndNote 툴 활용 가이드


논문 쓰다 인용 부호와 쉼표 하나에 울컥한 적 있으신가요? 학
위 논문 심사와 학술지 투고의 첫 번째 문턱인 APA·MLA 인용 양식 완벽 정복법과 엔드노트(EndNote), 노션(Notion)을 활용한 자동화 문헌 관리 비법을 명쾌하게 정리해 드립니다!


대학원 연구실에서 밤샘 작업을 해본 분들이라면 누구나 한 번쯤 겪는 악몽이 있다.

본문 연구 설계와 통계 분석은 완벽하게 끝냈는데, 마지막 제출 직전에 "참고문헌 양식 전부 다시 맞춰오세요"라는 피드백을 받을 때다.


콤마 하나, 마침표 위치, 이탤릭체 적용 여부 때문에 밤을 꼬박 새우다 보면 솔직히 '내가 연구를 하는 건지, 활자 교정을 하는 건지' 회의감이 들기도 한다. 😊


하지만 학계에서 인용 규칙은 단순한 오탈자 검사가 아니라 지적 정직성과 연구 윤리를 증명하는 기본 예절이다.


* 이미지 출처 : NotebookLM 내용 요약 생성


1. 왜 인용 양식이 중요할까? 대표 규격 한눈에 보기 🤔

학술계에는 다양한 학문 분과만큼이나 여러 종류의 스타일 가이드가 존재한다.

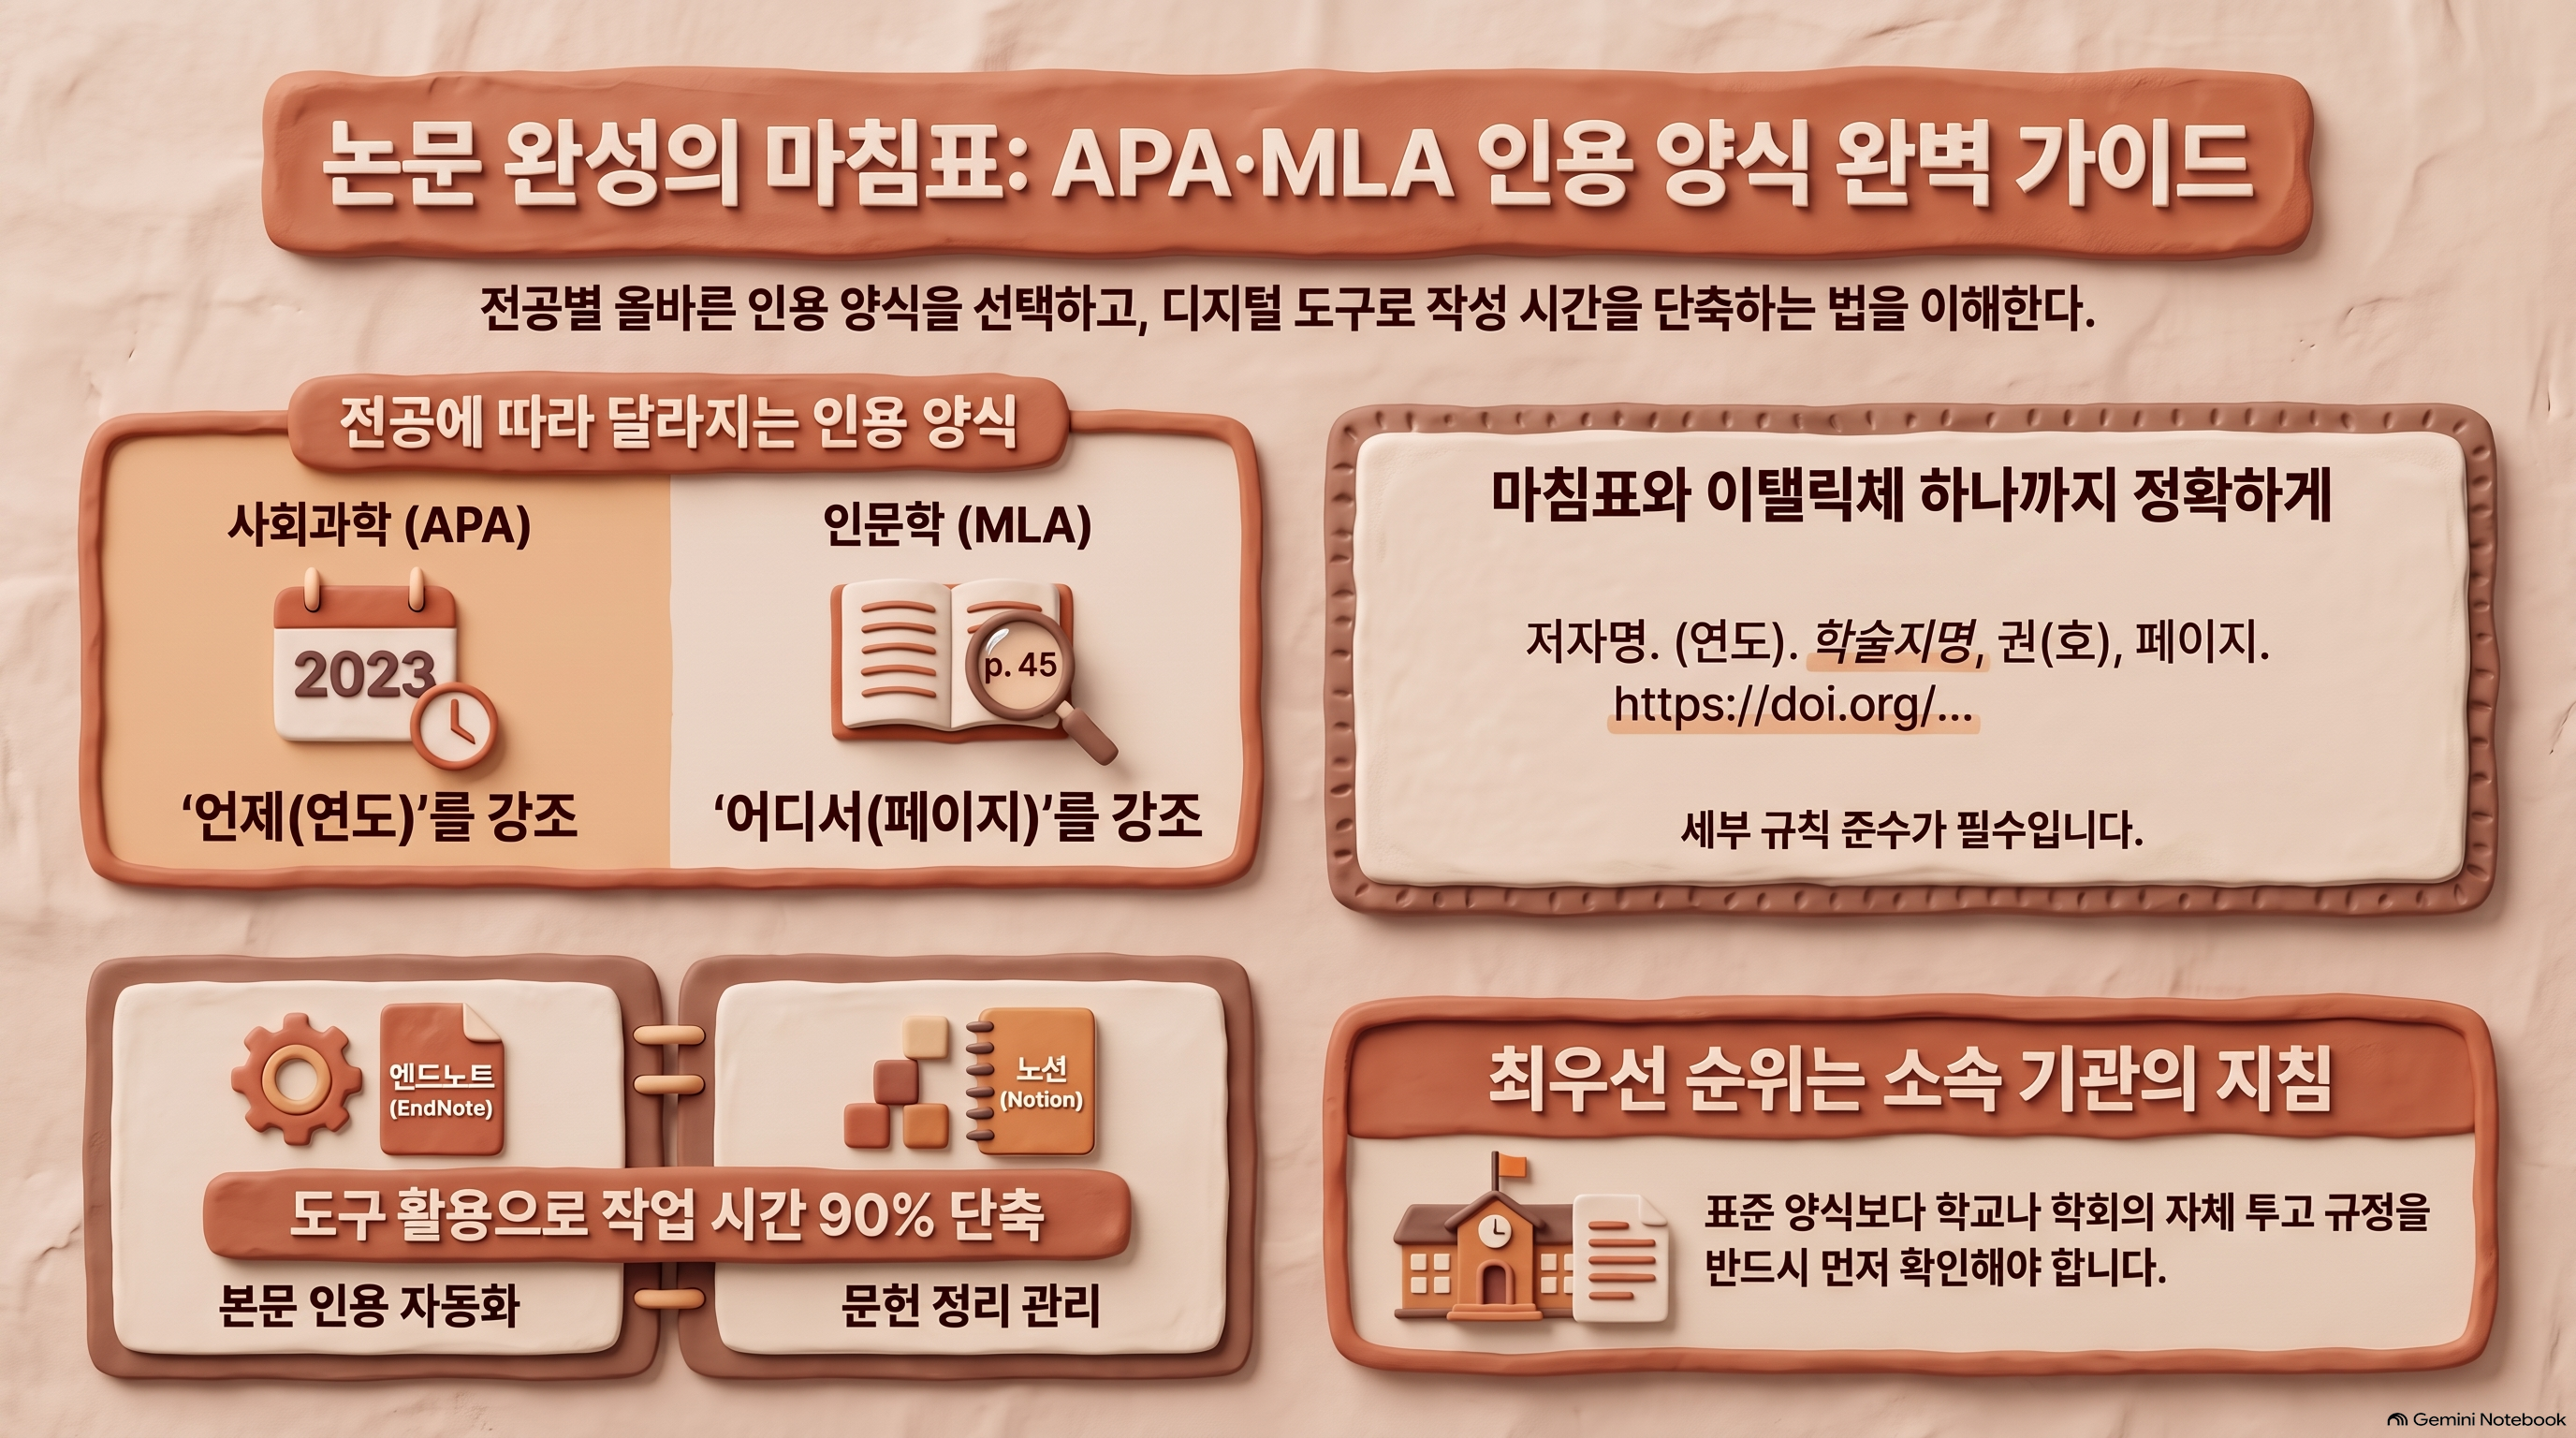
분야마다 연구의 흐름과 출처를 바라보는 관점이 다르기 때문인데요, 크게는 저자-연도 체계를 강조하는 사회과학 분야와 저자-페이지 체계를 중시하는 인문학 분야로 나뉜다.


가장 널리 쓰이는 APA(American Psychological Association, 미국심리학회) 양식은 연구가 '언제' 발표되었는지를 핵심으로 보며, MLA(Modern Language Association, 미국현대언어학회) 양식은 텍스트의 '어느 위치'에서 인용되었는지를 직관적으로 추적할 수 있도록 돕는다.

💡 알아두세요!
소속 대학원이나 투고하려는 학술지의 '투고 규정(Author Guidelines)'을 반드시 먼저 확인해야 한다.
기본적으로 APA를 따른다고 적혀 있어도, 학회별로 국내 문헌 표기(가나다순, 한글 저자명 표기법 등)에 자체 변형 룰을 두는 경우가 굉장히 많다.


2. APA vs MLA 핵심 규칙 비교 분석 📊

대학원생들이 가장 빈번하게 혼동하는 두 대표 규격의 차이점을 명확히 짚어보자.
본문 내 인용(In-text citation)과 논문 말미의 참고문헌 목록(References / Works Cited) 작성 방식에서 확연한 차이가 드러난다.

주요 인용 양식 상세 비교

구분 APA 양식 (7판 기준) MLA 양식 (9판 기준) 주요 적용
본문 인용 (Kim, 2024) 또는 (Kim, 2024, p. 45) (Kim 45) 사회과학 /
인문어문
저자 표기 성, 이름 이니셜 (예: Hong, G. D.) 성, 전체 이름
(예: Hong, Gildong)
경영, 교육,
심리 등
출판 연도 위치 저자명 바로 뒤 괄호 안에 배치 출판사 뒤, 문헌 정보 끝부분에 배치 문학, 어학,
철학 등
제목 대소문자 문장형 대문자 (첫 단어만 대문자) 표제형 대문자
(주요 단어 모두 대문자)
어학계열
필수 준수
⚠️ 주의하세요!
인터넷 기사나 온라인 학술지를 인용할 때 DOI(Digital Object Identifier, 디지털 객체 식별자)가 있다면
반드시 하이퍼링크 형태(https://doi.org/...)로 정확히 기재해야 결격 사유를 피할 수 있다.


3. 인용 표기 공식과 실제 적용 예시 🧮

참고문헌 작성은 수학 공식과 정확히 같다. 규격화된 순서와 구두점(콤마, 마침표, 콜론)을 정확히 지키는 것이 관건이다.

📝 APA 학술지 논문 인용 공식

저자명. (출판연도). 논문제목. 학술지명, 권(호), 시작페이지-끝페이지. https://doi.org/xx.xxx

학술 논문 한 편을 실제로 작성할 때 어떻게 달라지는지 구체적인 예시로 확인해 보자!

실제 표기 비교

1) APA 스타일 적용:
Kim, C. H. (2024). Big data analytics in academic publishing. Journal of Convergence Science, 12(3), 145-160. https://doi.org/10.1234/jcs.2024.01 


2) MLA 스타일 적용:
Kim, Chae-Hyun. "Big Data Analytics in Academic Publishing." Journal of Convergence Science, vol. 12, no. 3, 2024, pp. 145-60.

→ 학술지명과 권(Volume) 번호의 기울임꼴 처리 및 페이지 축약 표기 규칙의 차이를 확인하세요.

4. 연구 효율을 극대화하는 서지 관리 툴: EndNote와 Notion 👩‍💼👨‍💻

참고문헌이 수십 편에서 수백 편에 달하는 학위 논문에서는 수작업 입력이 절대 불가능하다.

중간에 인용 하나가 빠지거나 순서가 바뀌면 본문 번호와 목록이 전부 엉망이 되기 때문이다.
이때 전용 서지 관리 소프트웨어의 도입은 선택이 아니라 필수이다.


대표적인 도구로 엔드노트(EndNote)와 노션(Notion)이 손꼽히는데, 두 도구의 목적과 활용법은 확실하게 구분해서 연계하는 것이 현명하다.

📌 알아두세요! 도구별 역할 분담 전략
1. EndNote: MS Word와 실시간 연동(Cite While You Write, CWYW)을 통한 자동 본문 인용 및 참고문헌 목록 자동 생성 담당.
2. Notion: 연구 주제별 문헌 아카이빙, 주요 연구 결과 요약, 논문 매트릭스 표 정리 등 정성적 연구 노트 담당.


실전 예시: 논문 작성 시간을 절반으로 줄인 K연구원의 사례 📚

실제 석사 학위 논문을 준비하던 한 연구원의 워크플로우 개선 사례를 통해 도구 조합의 효과를 살펴보자!

연구자의 기존 문제 상황

  • 수집 문헌 수: 140여 편의 국내외 저널 논문 및 학술대회 발표 자료
  • 발생 문제: 한글과 워드 문서에 손으로 직접 타이핑하여 인용 누락 및 이탤릭체 오적용 다수 발생

개선 워크플로우 구축

1) RISS 및 Google Scholar에서 문헌 반출 시 .enw 파일로 EndNote 라이브러리에 원클릭 자동 수집

2) Notion 데이터베이스를 생성하여 연구 가설, 독립/종속 변수, 주요 한계점을 칼럼별로 정리 및 태그 분류

3) MS Word 작성 시 EndNote CWYW 플러그인을 활용해 클릭 한 번으로 학회 규격 스타일(APA 7th) 일괄 전환

최종 결과

- 참고문헌 검토 및 교정 소요 시간: 15시간 이상 → 30분 이내로 대폭 단축

- 심사위원 지적 사항: 참고문헌 및 본문 인용 서식 오류 '0건' 달성

이처럼 단순 암기나 수작업에 매달리는 대신,

초기에 시스템을 올바르게 세팅해 두면 연구 본연의 논리 전개에 훨씬 많은 시간과 에너지를 집중할 수 있다.


핵심 내용 요약 📝

논문 작성에서 인용과 참고문헌은 연구의 신뢰성을 지탱하는 가장 견고한 주춧돌이다.

복잡해 보이는 규격도 원리와 관리 도구를 익히면 전혀 두렵지 않다.


오늘 정리해 드린 기준을 바탕으로 현재 작성 중인 논문의 인용 규격을 다시 한번 점검해 보~ 😊

 
💡

인용 및 참고문헌 핵심 요약

✨ 규격 선택 원칙: 사회과학은 APA(저자-연도), 인문학은 MLA(저자-페이지)가 표준입니다.
📊 세부 서식 규칙: 기울임꼴과 콤마, 마침표 위치를 정확히 준수하고 DOI 링크를 필히 기재해야 합니다.
🧮 APA 기본 공식:
저자명. (연도). 논문제목. 학술지명(기울임), 권(기울임)(호), 페이지. DOI
👩‍💻 도구 연계 전략: 본문 자동 인용은 EndNote, 문헌 리뷰 정리는 Notion으로 역할을 명확히 분담합니다.

자주 묻는 질문 ❓

Q: 국문 논문과 영문 논문이 섞여 있을 때 정렬 순서는 어떻게 되나요?
A: 대다수 국내 대학원 및 학회 규정상 국문 문헌(가나다순)을 먼저 배치하고, 그 뒤에 영문 및 기타 외국어 문헌(알파벳순)을 나열하는 것이 원칙입니다. 다만 투고 규정에 따라 전체 통합 알파벳순을 요구하는 경우도 있으니 사전 확인이 필요합니다.
Q: 저자가 3명 이상일 때 본문 인용은 어떻게 표기하나요?
A: APA 7판 기준으로는 첫 인용부터 제1저자 뒤에 바로 '등' 또는 'et al.'을 붙여 표기합니다. (예: Kim et al., 2024 / 홍길동 외, 2024). 참고문헌 목록에는 최대 20명까지 모든 저자의 이름을 기재해야 합니다.
Q: EndNote 유료 라이선스가 없을 때 쓸 수 있는 무료 대체 툴이 있나요?
A: 오픈소스 기반의 조테로(Zotero)나 멘델레이(Mendeley)가 훌륭한 무료 대안입니다. 워드 플러그인 연동 및 웹 브라우저 확장 프로그램을 통한 서지 반출 기능이 매우 강력하여 석박사 연구자들에게 널리 쓰입니다.
Q: 학술 논문이 아닌 웹사이트나 보고서는 어떻게 인용하나요?
A: 작성 기관명(또는 개인 저자), 발표 연도, 문서 제목(기울임꼴), 웹사이트 이름, 그리고 정확한 URL 주소를 기재합니다. 작성일자가 없는 경우 '(n.d.)'(no date)로 표기합니다.
Q: 학회 투고 규정이 APA와 조금 다를 때는 무엇을 우선해야 하나요?
A: 무조건 투고하려는 학회나 소속 대학원의 '자체 투고 규정 및 작성 편람'이 최우선입니다. 표준 APA 가이드와 상충하는 세부 조항이 있다면 학회의 개별 규정을 엄격히 따라야 감점을 피할 수 있습니다.


논문 표절률 10% 맞추는 법: 카피킬러 6어절 원리와 실전 패러프레이징 가이드


카피킬러와 턴잇인 표절률, 몇 %가 안전할까요?
학위 논문 및 학술지 투고 시 통과 가능한 유사도 허용 기준과 표절률을 획기적으로 낮추는 올바른 패러프레이징(문맥 살려 다시 쓰기) 실전 비법을 체계적으로 안내해 드려요!


대학원 학위 논문 심사나 학술지 논문 투고를 앞두고 표절 검사 프로그램을 돌릴 때, 화면에 뜨는 붉은색 유사도 수치를 보며 심장이 덜컥 내려앉았던 경험 다들 한 번쯤 있으실 거다.


성실하게 참고문헌을 인용했다고 생각했는데 생각보다 훨씬 높게 나오는 표절률 때문에 밤새 머리를 싸매는 연구자분들을 연구실이나 컨설팅 현장에서 정말 많이 만나뵙곤 한다. 😊


솔직히 말씀드리면, 표절 검사기의 기본 메커니즘을 제대로 이해하지 못한 채 무작정 단어 몇 개만 유의어로 바꾸는 방식으로는 절대 유사도를 낮출 수 없다.


카피킬러(CopyKiller)나 턴잇인(Turnitin)이 어떤 알고리즘으로 문장을 판별하는지, 그리고 왜 문장 구조를 근본적으로 해체하고 재구성하는 패러프레이징(Paraphrasing)이 필수적인지 제가 겪은 수많은 심사 지도 사례를 바탕으로 명쾌하게 짚어드린다.


* 이미지 출처 : NotebookLM 내용 요약 생성


기관별 표절률 기준과 허용치 가이드 🤔

가장 먼저 마주하는 질문은 바로

"도대체 몇 퍼센트 아래로 맞춰야 심사를 무사히 통과할 수 있는가?"이다.


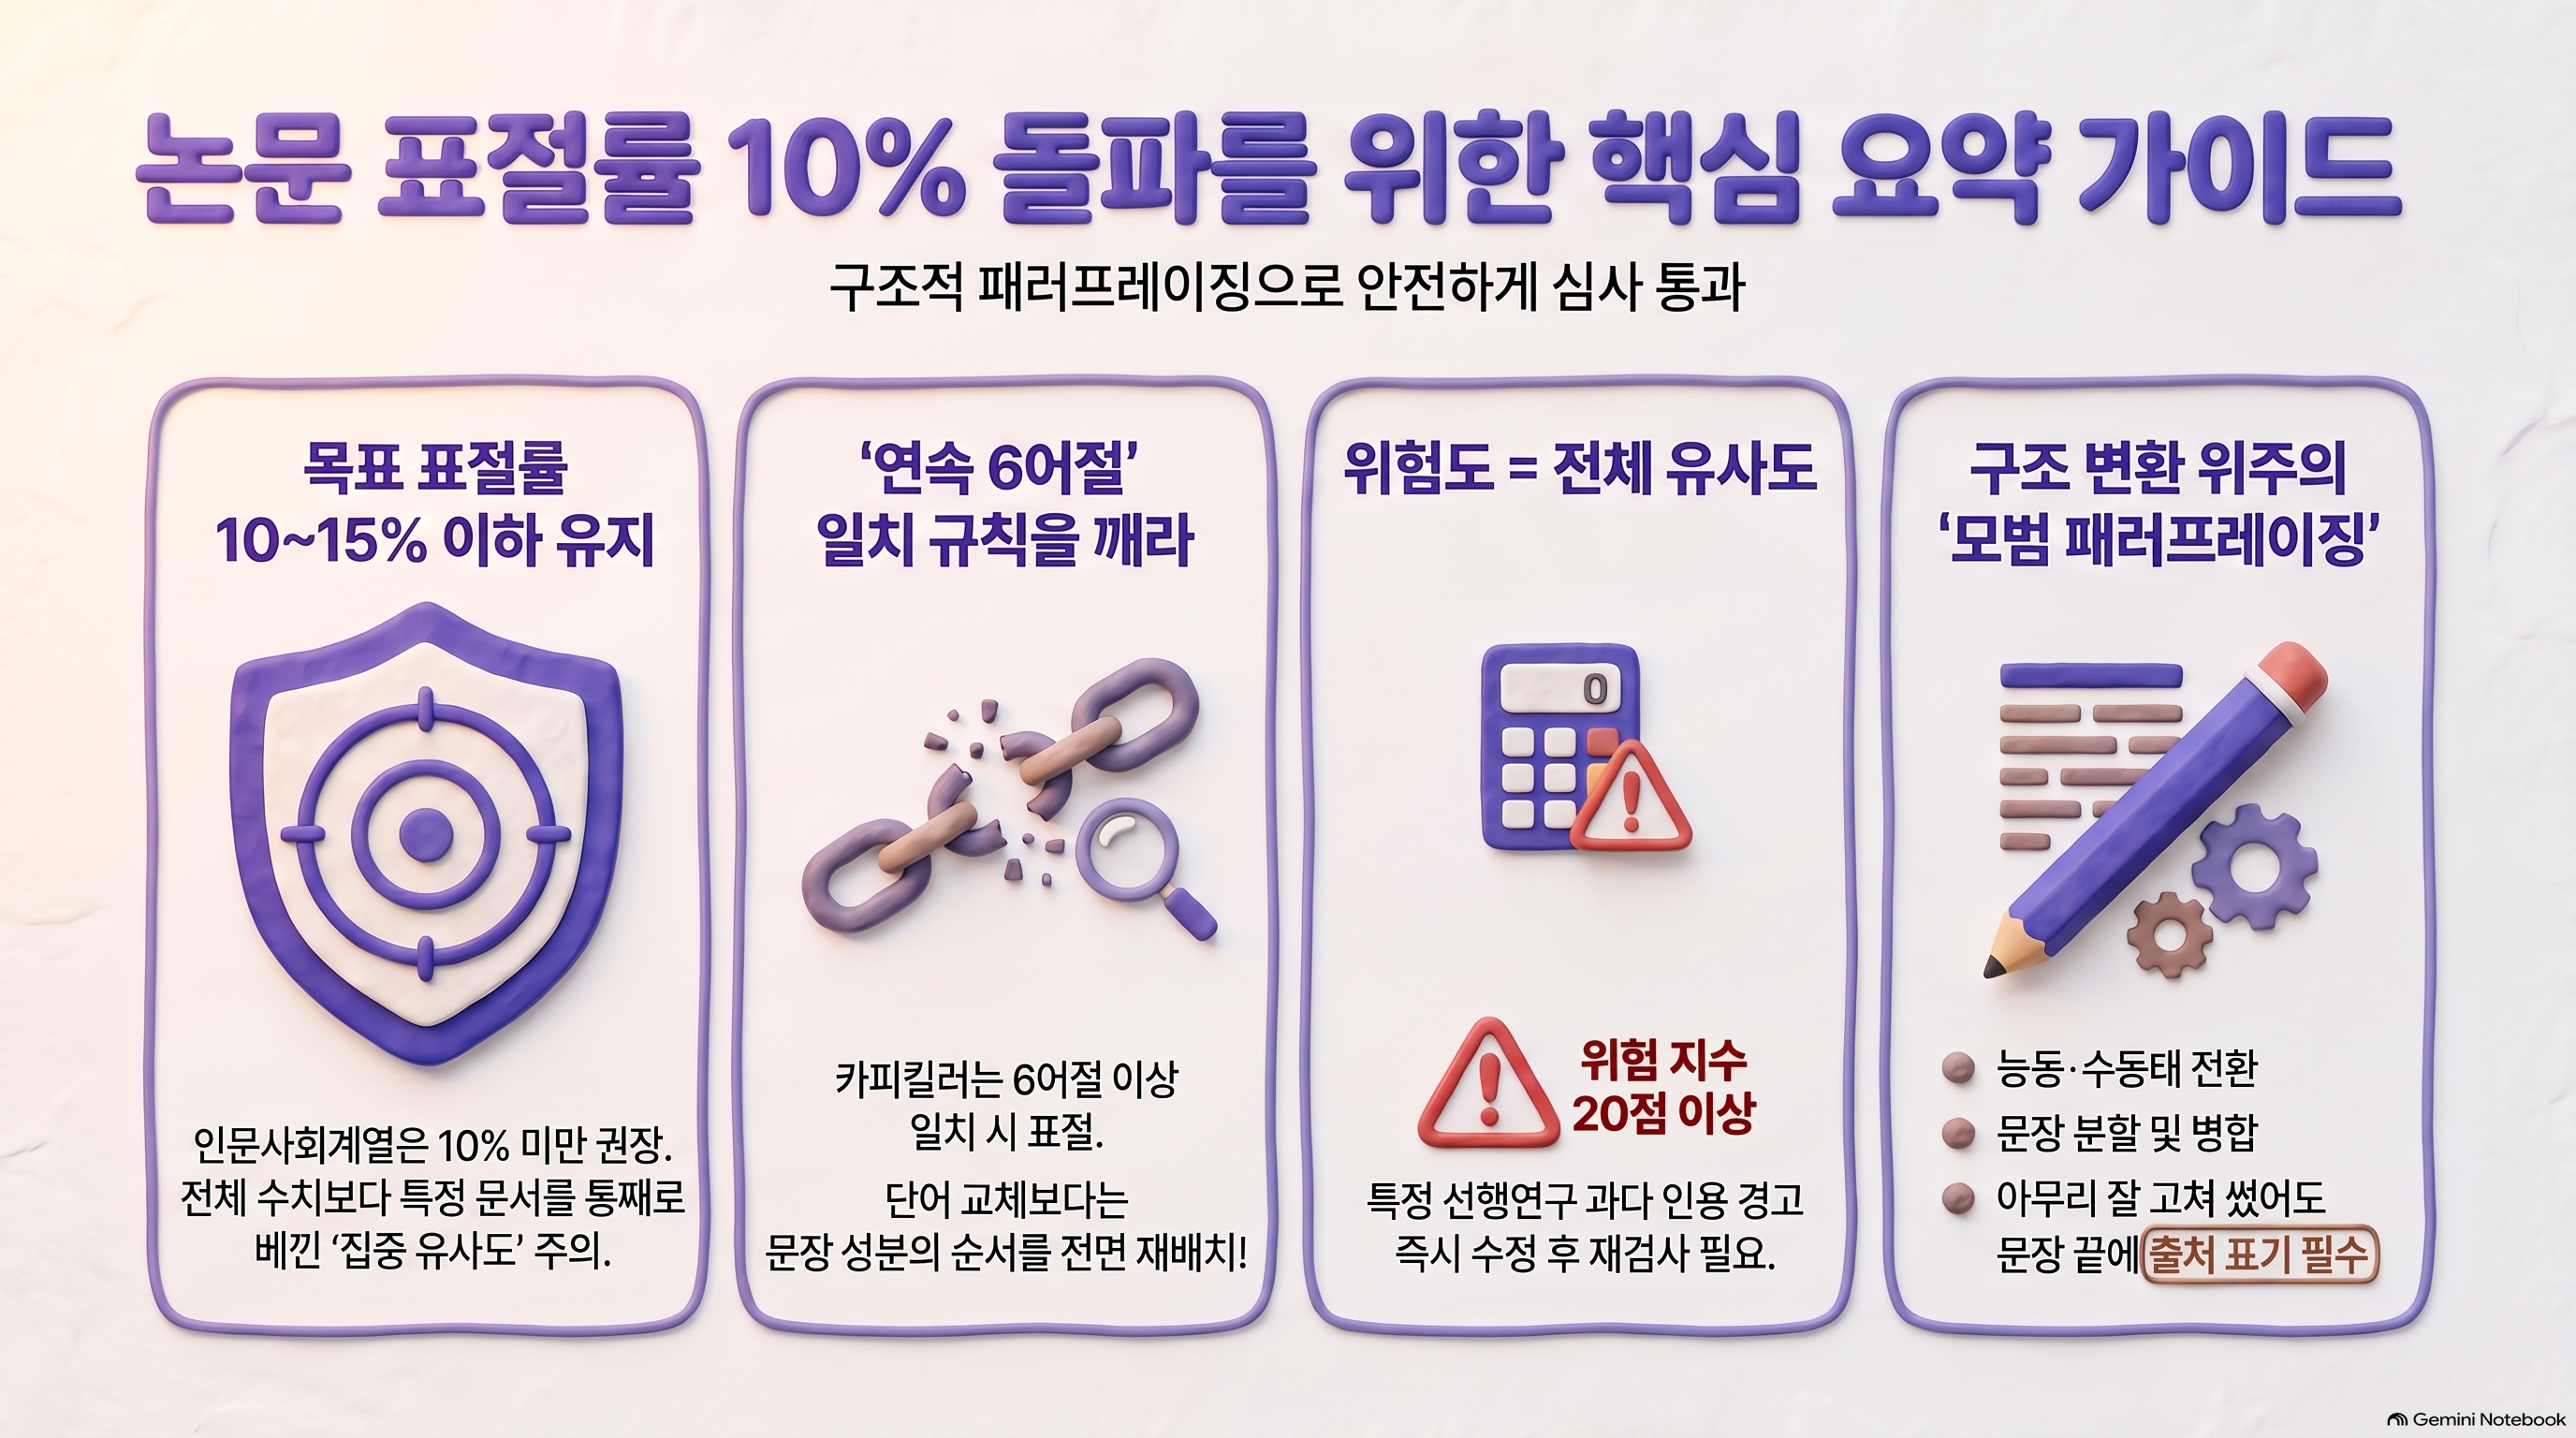
일반적으로 국내 대학원 및 학술단체에서는 10%~15% 내외를 통상적인 허용 기준으로 권고하고 있다.


하지만 이 수치는 전공 분야와 기관의 자체 규정에 따라 미세하게 차이가 있다.


공학이나 자연과학 계열처럼 표준화된 실험 프로토콜이나 수식 인용이 많은 분야는 15~20%까지 참작해 주기도 하지만, 인문사회 및 경영학 계열은 문장 서술의 독창성을 매우 엄격하게 보기 때문에 10% 미만을 강력히 권장하는 대학이 많다.

💡 알아두세요!
수치 자체가 10% 미만이라 하더라도 특정 선행연구의 핵심 주장이나 단락 통째가 그대로 일치하는 '집중 유사도'가 발견되면 수치와 상관없이 연구윤리 위반으로 판정받을 수 있다. 전체 비율뿐 아니라 특정 문서와의 일치율도 반드시 확인해야 한다.


카피킬러 vs 턴잇인 비교 분석 📊

국내 대학에서 주로 활용하는 카피킬러와 해외 저널 및 주요 연구기관에서 표준으로 삼는 턴잇인은 데이터베이스 구축 범위와 일치 판정 알고리즘에서 뚜렷한 차이를 보인다.


카피킬러는 기본적으로 연속된 6어절 일치를 기준으로 표절 여부를 판별하며, 국내 학위논문, 공공기관 보고서, 웹문서 데이터에 매우 특화되어 있다.


반면 턴잇인은 전 세계 학술 데이터베이스와 해외 저널을 포괄하며 단어 단위의 n-gram 매칭과 문장 구조 유사도를 복합적으로 분석한다.

검사 도구별 핵심 특성 및 비교

구분 카피킬러 (CopyKiller) 턴잇인 (Turnitin) 대응 전략
주요 DB 범위 국내 학위·학술논문, 웹문서, 정부간행물 글로벌 학술지, SCI/SSCI급 논문, 웹페이지 제출 대상 학술지
권역에 맞춘 사전 검사
표절 판정 기준 연속 6어절 이상 일치, 1문장 일치 연속 단어 매칭 및 구문 유사도 통합 산출 문장 구조 자체를 전면
변경하는 패러프레이징
권장 표절률 10% 이하 (최대 15% 미만) 15% 이하 (개별 소스 1~2% 미만) 인용부호 및 참고문헌
제외 설정 필수 점검
주요 활용처 국내 대학 석·박사 청구논문, KCI 저널 국제 학술지 투고, 외국계 대학 학위과정 기관 요구 양식 증명서
발급 여부 확인
⚠️ 주의하세요!
검사 시 '출처 표기 제외'나 '참고문헌 제외' 옵션을 켜두지 않으면 서지정보 목록까지 유사도에 포함되어 20~30%까지 수치가 뻥튀기될 수 있다. 대학 제출 요강에 맞는 필터 옵션(인용구 제외, 목차 제외 등)을 반드시 확인하고 설정하자.


표절률 진단 및 위험도 시뮬레이터 🧮

내가 작성한 논문 파일의 검사 수치와 단일 선행연구와의 최대 일치율을 입력하여 종합적인 심사 안전도를 즉시 점검해보실 수 있도록 간단한 계산 도구를 마련했다.

📝 표절률 종합 위험도 판정 기준

위험도 지수 = 전체 유사도(%) + [최대 단일 문서 일치율(%) × 1.5]

예를 들어 전체 유사도가 12%이고, 특정 선행논문 하나와의 일치율이 6%라면 다음과 같이 계산된다.

1) 단일 소스 가중치: 6% × 1.5 = 9점

2) 위험 지수 합산: 12 + 9 = 21점

→ 판정 결과: 위험 지수 20점 이상으로 선행문헌 집중 인용 단락의 전면적인 패러프레이징 수정이 요구됩니다.

표절률을 낮추는 핵심 패러프레이징 기법 👩‍💼👨‍💻

단어 몇 개를 유의어로 치환하는 것은 기계적 검사기뿐 아니라 사람 심사위원에게도 가장 쉽게 적발되는 '조잡한 패러프레이징'이다.


진정한 패러프레이징은 원문의 핵심 논리를 연구자 본인의 인지 체계로 완전히 소화한 뒤, 문장 구조와 관점을 바꾸어 재창조하는 작업이다.

📌 연구자가 반드시 숙지해야 할 패러프레이징 4원칙!
1. 구조 변환: 능동태 문장을 수동태로, 또는 복문을 단문 여러 개로 분할 및 병합한다.
2. 품사 전환: 핵심 동사를 명사화하거나, 부사를 활용하여 서술 방식을 완전히 바꾼다.
3. 종합 요약(Synthesis): 2~3편의 서로 다른 선행연구 주장을 한 문단으로 엮어 비교·대조한다.
4. 정확한 출처 인용: 패러프레이징을 완벽하게 수행했더라도 문장 말미에 저자와 연도를 반드시 명시해야 하자.


핵심 내용 요약 📝

논문 표절 검사는 연구자의 독창성과 학문적 정직성을 증명하는 통과의례이다.

단순히 시스템을 속이기 위한 잔기술이 아니라 연구 내용을 자신의 언어로 깊이 있게 체화하는 과정으로 삼으시길 바란다.


💡

논문 표절률 완벽 대비 핵심 요약

✨ 허용 기준선: 일반 대학원 기준 10%~15% 미만 유지 필수 (인문사회 10% 권장).
📊 도구별 특성: 카피킬러는 연속 6어절, 턴잇인은 다차원 구문 매칭 기반 분석.
🧮 위험도 지수 산출:
종합 위험도 = 전체 유사도 + (단일 소스 최대 일치율 × 1.5)
👩‍💻 패러프레이징 전략: 단순 단어 치환 금지! 문장 구조 해체 후 관점 전환 재작성 필수.

자주 묻는 질문 ❓

Q: 카피킬러 표절률이 10% 이하이면 무조건 심사 통과인가요?
A: 아닙니다. 전체 유사도가 8%라도 특정 선행연구 한 편에서 두세 단락 이상이 그대로 복사·붙여넣기된 '집중 유사도'가 발견되면 심사위원이 표절로 판정할 수 있습니다. 개별 문서 일치율도 2~3% 미만인지 확인해야 합니다.
Q: 패러프레이징을 완벽하게 재작성한 경우에도 출처를 표기해야 하나요?
A: 네, 필수입니다. 자신의 문장으로 완전히 바꾸어 썼더라도 아이디어, 가설, 통계 데이터의 출처는 원저자에게 있으므로 문장 말미에 (저자, 연도) 형태의 인용 표기를 반드시 누락 없이 남겨야 연구윤리 위반을 방지할 수 있습니다.
Q: 본인이 과거에 작성한 논문이나 학위논문을 인용해도 표절률에 잡히나요?
A: 네, 잡힙니다. 이를 '자기표절(Self-plagiarism)' 또는 '중복게재'라고 합니다. 본인의 이전 발표 논문 내용을 가져올 때도 일반 선행연구와 동일하게 출처를 밝히고 정식 인용 규정을 준수해야 합니다.
Q: 생성형 AI(ChatGPT 등)를 활용해 문장을 다듬으면 표절 검사기에 걸리지 않나요?
A: 표절 검사기와 더불어 최근 턴잇인과 카피킬러는 'AI 생성 텍스트 탐지기(AI Detection)'를 함께 가동합니다. AI가 생성한 전형적인 문체는 탐지율에 걸릴 수 있으므로, 연구자 본인의 문맥과 논리에 맞게 수동으로 최종 감수하고 재집필해야 합니다.
Q: 표절률 검사 결과지에 목차와 참고문헌이 빨갛게 잡혀 수치가 높은데 어떡하나요?
A: 검사 설정 필터에서 '참고문헌 제외' 및 '목차/표지 제외' 옵션을 체크하고 재검사를 진행해야 합니다. 대부분의 대학 및 연구재단에서는 본문 서술 내용만을 표절 검사 영역으로 인정합니다.

학위논문 목차 잡는 법: 장별 필수 수록 내용과 10-25-20-30-15 황금 비율


논문 쓰기 전 필수 점검!
서론부터 결론까지 완벽한 5단 구조와 분량 가이드
백지 상태의 워드 화면을 띄워두고 첫 문장조차 떼지 못해 막막하셨나요? 논문의 뼈대가 되는 5단 구조(서론-이론적 배경-연구방법-결과-결론)의 핵심 작성 원칙과 실패 없는 장별 분량 배분 노하우를 명쾌하게 풀어드립니다!


대학원 진학 후 학위논문이나 등재지 학술지 투고를 준비하다 보면 가장 먼저 마주하는 난관이 바로 '목차 잡기'와 '구조 설계'다.

"대체 1장 서론에는 어디까지 써야 하지?"
"이론적 배경과 서론의 선행연구 정리는 무엇이 다를까?"

하는 고민, 연구자라면 누구나 한 번쯤 밤을 지새우며 겪어보셨을 거다.
저 역시 초보 연구자 시절 분량 배분을 잘못해서 심사위원들께 수없이 지적받고 전체 구성을 완전히 뜯어고친 뼈아픈 경험이 있다. 😊


* 이미지 출처 : NotebookLM 내용 요약 생성


1. 논문 5단 구조의 본질: 하나의 스토리라인 만들기 🤔

학술 연구는 단순한 지식의 나열이 아니라,
하나의 논리적인 주장을 증명해 나가는 정교한 스토리텔링이다.

학계에서 표준으로 통용되는 서론-이론적 배경-연구방법-결과-결론의 5단 구성은 연구의 타당성을 입증하기 위한 가장 직관적이고 견고한 프레임워크다.

각 챕터는 독립적으로 분리된 글이 아니라,
앞 장의 물음과 근거가 뒷 장의 연구 설계와 분석 결과로 긴밀하게 이어져야 한다.


서론에서 던진 질문이 결론에서 회수되지 않거나,
이론적 배경에서 다룬 개념이 연구모형에 등장하지 않는다면 그 논문은 심사 문턱을 넘기 어렵다.

💡 알아두세요!
자연과학이나 공학 계열의 IMRAD(Introduction, Methods, Results, and Discussion) 구조와 사회과학·인문학의 5단 구조는 본질적으로 동일하다. 문헌 검토를 별도 장으로 분리하느냐 서론에 통합하느냐의 형식 차이일 뿐, 논리 전개 공식은 동일하다.


2. 각 장(Chapter)별 핵심 내용과 황금 분량 비율 📊

많은 분들이 첫 장부터 욕심을 내어 자료를 채워 넣다가 뒤로 갈수록 힘이 빠져 분석과 논의를 흐지부지 끝내곤 한다. 논문의 완성도를 결정짓는 가장 핵심적인 기준은 바로 균형 잡힌 페이지 배분이에요.


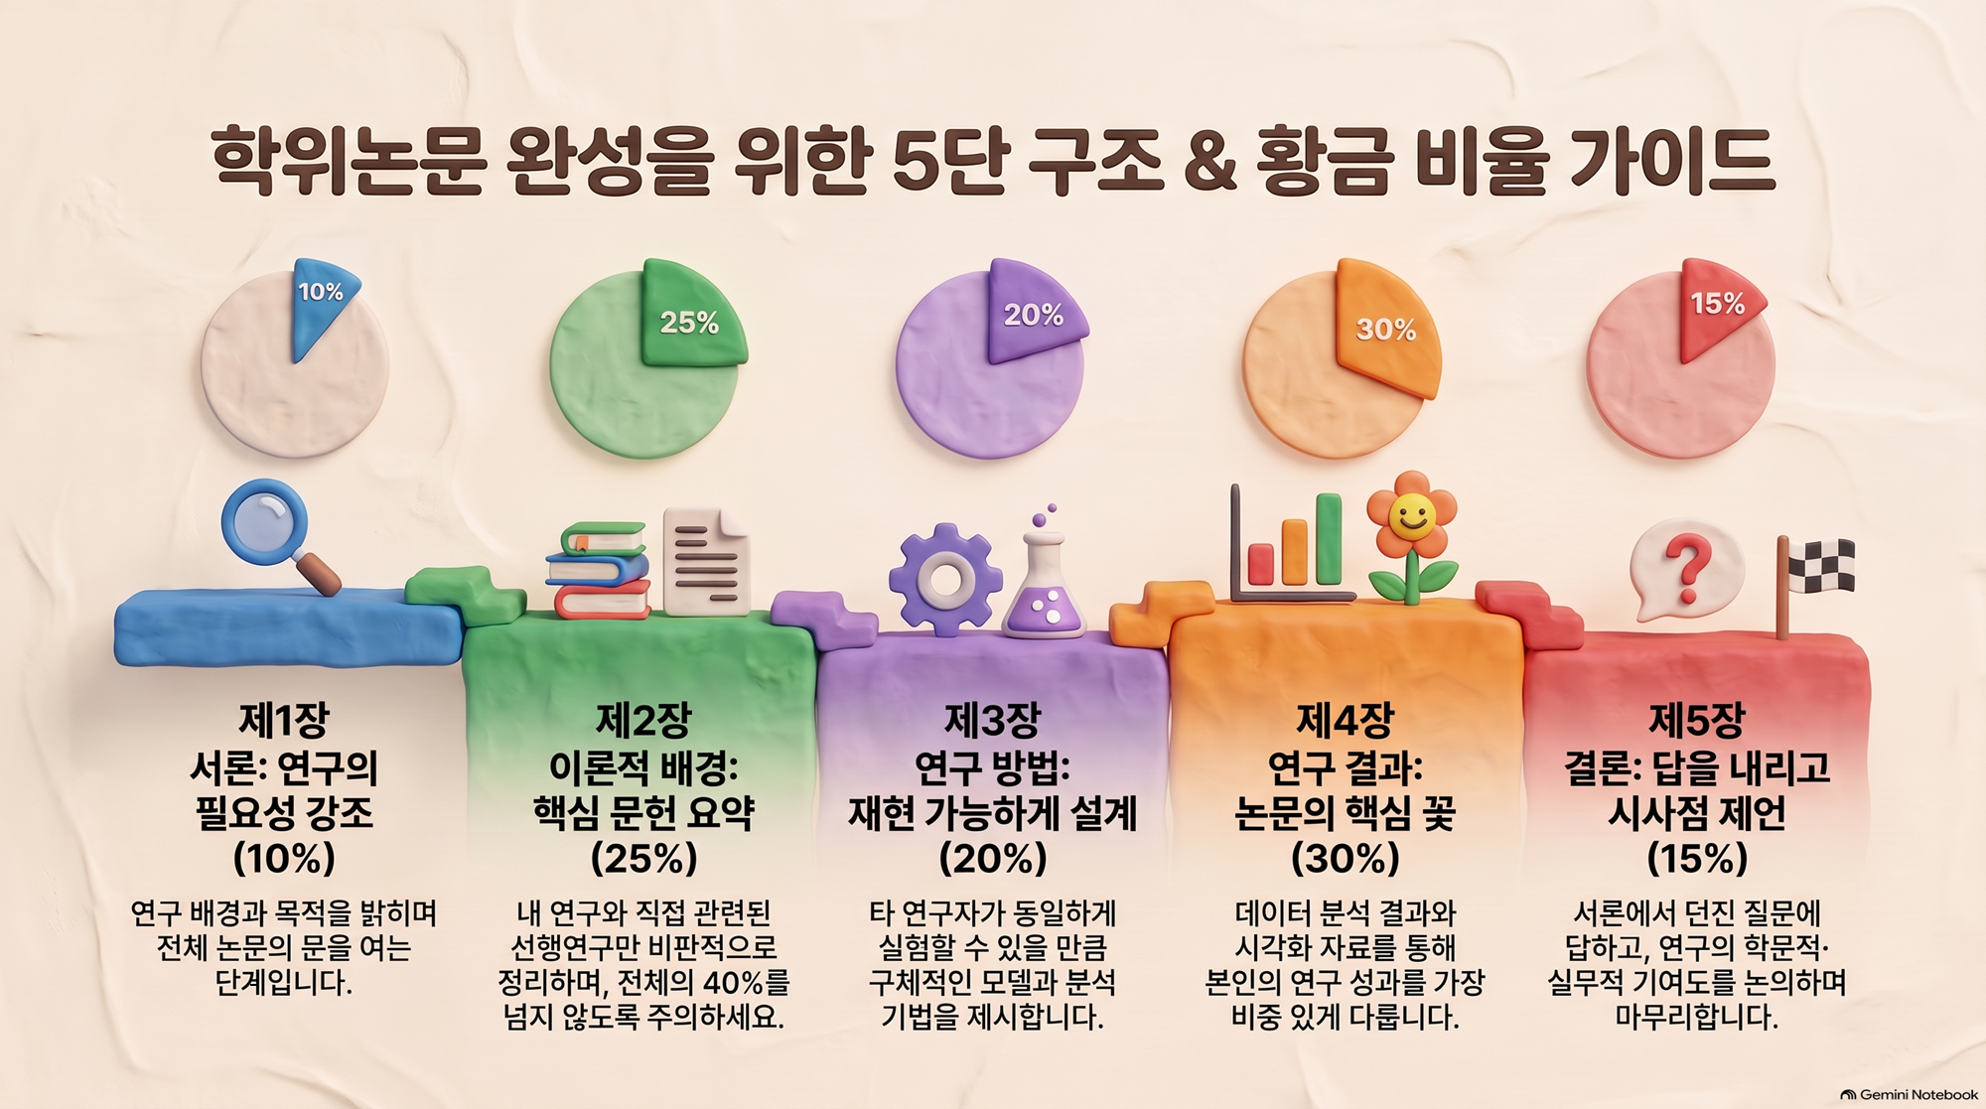
일반적으로 통용되는 석·박사 학위논문 및 학술논문의 황금 비율은 10% - 25% - 20% - 30% - 15% 규칙이다.
본 연구자의 순수 분석과 논의가 담기는 4장(결과)과 5장(결론)의 비중이 전체의 절반 가까이를 차지해야 좋은 논문으로 평가받는다.

장별 역할 명세 및 표준 분량 기준표

챕터 구분 핵심 수록 내용

권장

분량 비율

80페이지

학위논문 기준

제1장 서론 (Introduction) 연구 배경, 문제 제기, 연구 목적 및 필요성, 연구 질문 및 논문 구성 약 10% 8 ~ 10쪽
제2장 이론적 배경 (Literature Review) 주요 변수 개념 정의, 선행연구 동향 비판적 검토, 이론적 연구가교 도출 약 25% 18 ~ 22쪽
제3장 연구 방법 (Methodology) 연구모형, 가설 설정, 조작적 정의, 표본 설계, 자료수집 및 통계분석 기법 약 20% 14 ~ 16쪽
제4장 연구 결과 (Results) 인구통계학적 특성, 신뢰도·타당도 검증, 가설 검증 결과, 표 및 도표 시각화 약 30% 22 ~ 26쪽
제5장 결론 및 제언 (Conclusion) 연구 결과 종합 요약, 학문적·실무적 시사점 논의, 연구의 한계점 및 향후 과제 약 15% 10 ~ 12쪽
⚠️ 주의하세요!
2장 이론적 배경이 지나치게 길어 전체 분량의 40%를 넘어가면 '교과서 베끼기식 논문'이라는 혹평을 받기 쉽다. 남의 연구를 단순히 요약하는 분량은 과감히 쳐내고, 내 데이터와 내 분석 결과(4장) 및 그에 따른 차별적 시사점(5장)에 페이지를 집중 배분하자!


3. 목표 분량 역산 공식과 맞춤형 페이지 계산기 🧮

논문 작성의 피로도를 낮추는 가장 확실한 기술은 무작정 글을 쓰는 것이 아니라,
목표 페이지 수를 먼저 픽스해 두고 각 소목차별로 할당된 쪽수를 채워나가는 '모듈형 글쓰기'이다.

📝 장별 목표 분량 산출 공식

장별 목표 쪽수 = 전체 목표 페이지 수 × 표준 가중치 비율

예를 들어 20쪽 내외의 KCI(Korea Citation Index, 한국학술지인용색인) 등재 학술지를 투고하고자 할 때의 단계별 배분 예시를 살펴보자!

계산 예시 (20쪽 기준 학술논문)

1) 제1장 서론: 20쪽 × 0.10 = 2쪽 내외

2) 제2장 이론적 배경: 20쪽 × 0.25 = 5쪽 내외

3) 제3장 연구방법: 20쪽 × 0.20 = 4쪽 내외

4) 제4장 연구결과: 20쪽 × 0.30 = 6쪽 내외

5) 제5장 결론 및 논의: 20쪽 × 0.15 = 3쪽 내외

→ 총 20쪽으로 논리적인 완결성을 갖춘 포맷이 완성됩니다.

4. 챕터별 논리 연결성을 높이는 실전 집필 팁 👩‍💼👨‍💻

각 장을 작성할 때 반드시 기억해야 할 비결은 '질문과 답의 일치'이다.
서론에서 제기한 질문(연구 문제)은 반드시 결론에서 명확한 문장으로 답을 내려주어야 논리적 봉합이 완성된다.

📌 알아두세요!
글쓰기 순서는 목차 순서(1장부터 5장까지)대로 쓰는 것보다, '3장(연구방법) 및 4장(결과) 초안' → '2장(이론적 배경)' → '1장(서론)' → '5장(결론)' 순으로 쓰는 것이 훨씬 빠르고 수월하다. 분석 결과가 나와야 서론에서 어떤 맥락으로 문제를 좁혀 들어갈지 명확해지기 때문이다.


실전 예시: 분량 배분 실패를 극복한 석사 연구 사례 📚

실제 컨설팅 현장에서 많은 연구자들이 겪는 전형적인 실수와 이를 교정한 과정을 함께 살펴볼까요?

사례 주인공의 상황

  • 상황: 경영학 석사과정 K선생님, 목표 총 분량 80쪽 중 초고 75쪽 작성
  • 문제점: 2장 이론적 배경에만 40쪽(53%)을 소모하고, 가장 중요한 4장 결과와 5장 결론이 각각 12쪽, 5쪽에 불과하여 심사위원회의 재작성 권고를 받음

구조 개선 및 재배분 과정

1) 이론적 배경 압축: 연구모형 및 가설과 직접적 연관이 없는 원론적 개념 서술을 40쪽에서 20쪽으로 50% 과감히 축약

2) 결과 및 시사점 보강: 확보한 분량 여유를 바탕으로 조절효과 심층 분석 표 추가(4장 24쪽으로 확대) 및 실무 전략 제언 5개 항목 신설(5장 12쪽으로 확대)

최종 결과

- 재배분 구성: 1장 8쪽 / 2장 20쪽 / 3장 15쪽 / 4장 25쪽 / 5장 12쪽 (총 80쪽 완벽 수렴)

- 심사 피드백: "연구자의 독자적인 분석과 실무적 통찰이 매우 돋보인다"는 호평과 함께 최종 논문 본심사를 한 번에 통과

이처럼 분량 배분은 단순한 '페이지 채우기'가 아니라,
내 연구의 오리지널리티(Originality, 독창성)를 증명하는 비중 전략이라는 점을 꼭 명심하시기 바란다.


마무리: 핵심 내용 요약 📝

논문 작성을 결코 거대한 벽으로 느끼실 필요가 없다.
전체 80쪽, 100쪽이라는 숫자에 압도당하지 말고, 5개의 구조로 분할하여 하루에 2~3쪽씩 블록을 쌓듯 접근해 보자!

오늘 안내해 드린 황금 배분 공식과 작성 팁을 여러분의 연구 계획서에 즉시 적용해 보시길 권한다.

 
💡

논문 구조 및 분량 가이드 요약 카드

✨ 5단 논리 구조: 서론 ➔ 이론적 배경 ➔ 연구방법 ➔ 연구결과 ➔ 결론으로 이어지는 유기적 완결성
📊 황금 분량 비율: 10% - 25% - 20% - 30% - 15%의 균형 잡힌 배분
🧮 챕터별 목표 산출 공식:
장별 목표 쪽수 = 전체 목표 페이지 × 가중치 비율
👩‍💻 핵심 작성 전략: 2장 문헌검토 과열 방지 & 4·5장 본인 분석·제언에 전체의 45% 집중!

자주 묻는 질문 ❓

Q: 이론적 배경(2장)을 작성할 때 가장 주의해야 할 실수는 무엇인가요?
A: 남의 논문과 전공 서적의 개념을 단순 나열하거나 교과서처럼 복사해 붙여넣는 것입니다. 2장의 목적은 내 연구의 모형과 가설을 지지해 줄 이론적 논거와 연구의 틈(Gap)을 찾는 것이므로, 자신의 연구 변수와 직접 연결되는 문헌만 비판적으로 정리해야 합니다.
Q: 학술지 논문 투고 시 분량 제한이 엄격한데 어떻게 조절해야 하나요?
A: 학술지 논문은 보통 20쪽 내외로 제한됩니다. 이때는 2장 이론적 배경을 4~5쪽 이내로 대폭 압축하고, 서론의 선행연구 검토와 통합하는 것도 좋은 전략입니다. 대신 4장 분석 결과와 5장 논의의 시사점 비중을 유지해야 감점을 피할 수 있습니다.
Q: 1장 서론과 5장 결론의 내용은 서로 어떻게 달라야 하나요?
A: 서론은 '왜 이 연구가 지금 필요한가'라는 문제 제기와 연구 목적을 제시하는 단계이고, 결론은 '그 문제에 대해 실제로 무엇을 밝혀냈으며 현실에 어떻게 기여하는가'를 해석하는 단계입니다. 질문을 던지는 쪽이 서론이라면, 답을 정리하고 발전 방향을 제언하는 쪽이 결론입니다.
Q: 연구방법(3장)에는 구체적으로 어디까지 기술해야 하나요?
A: 제3의 연구자가 내 논문의 3장만 보고도 동일한 조건에서 연구를 재현(Replication)할 수 있을 만큼 구체적이어야 합니다. 표본 추출 방식, 설문지 척도 문항, 결측치 처리 기준, 사용할 통계 소프트웨어 및 분석 모델 등을 명확히 기재해야 합니다.
Q: 가설이 기각되었을 때도 4장과 5장에 그대로 써야 하나요?
A: 네, 기각된 결과 역시 훌륭한 학문적 성과입니다. 데이터를 조작하지 말고 있는 그대로 4장에 제시한 뒤, 5장 논의 부분에서 선행연구와 왜 다른 결과가 나왔는지 표본의 특성, 시대적 변화, 환경적 요인 등을 토대로 깊이 있게 분석해 주면 오히려 더 높은 평가를 받을 수 있습니다.


설문조사 표본 수(N수)는 최소 몇 명?


"설문조사 표본 수, 대체 몇 명을 모아야 통계적으로 인정받을까요?"
학위 논문이나 연구 보고서를 준비할 때 가장 답답한 표본 수(N수) 결정 기준을 명쾌하게 정리해 드립니다. G*Power(지파워) 설정값부터 모집단 산출 공식까지 한 번에 확인하고 연구의 신뢰도를 확실하게 확보해 보세요!


연구자분들과 논문 컨설팅을 진행하다 보면 열에 아홉은

"대표님, 제 설문지는 최소 몇 명한테 돌려야 통과되나요?"

라는 질문을 먼저 한다.


사실 100명이면 충분하다는 선배 말만 믿고 설문지를 돌렸다가,

막상 심사장에 들어가서 통계적 검정력(Statistical Power) 부족으로 데이터 전체를 다시 수집해야 하는 안타까운 상황도 적지 않게 봤다. 😅


표본 크기를 결정하는 일은 단순히 발품을 얼마나 파느냐의 문제가 아니다.

내가 검증하려는 가설의 통계 기법, 효과 크기, 그리고 모집단의 성격에 맞춰 과학적 근거를 제시해야 심사위원들을 완벽하게 설득할 수 있다. 


* 이미지 출처 : NotebookLM 내요 요약 생성


통계 분석 기법별 최소 표본 수 기준 🤔

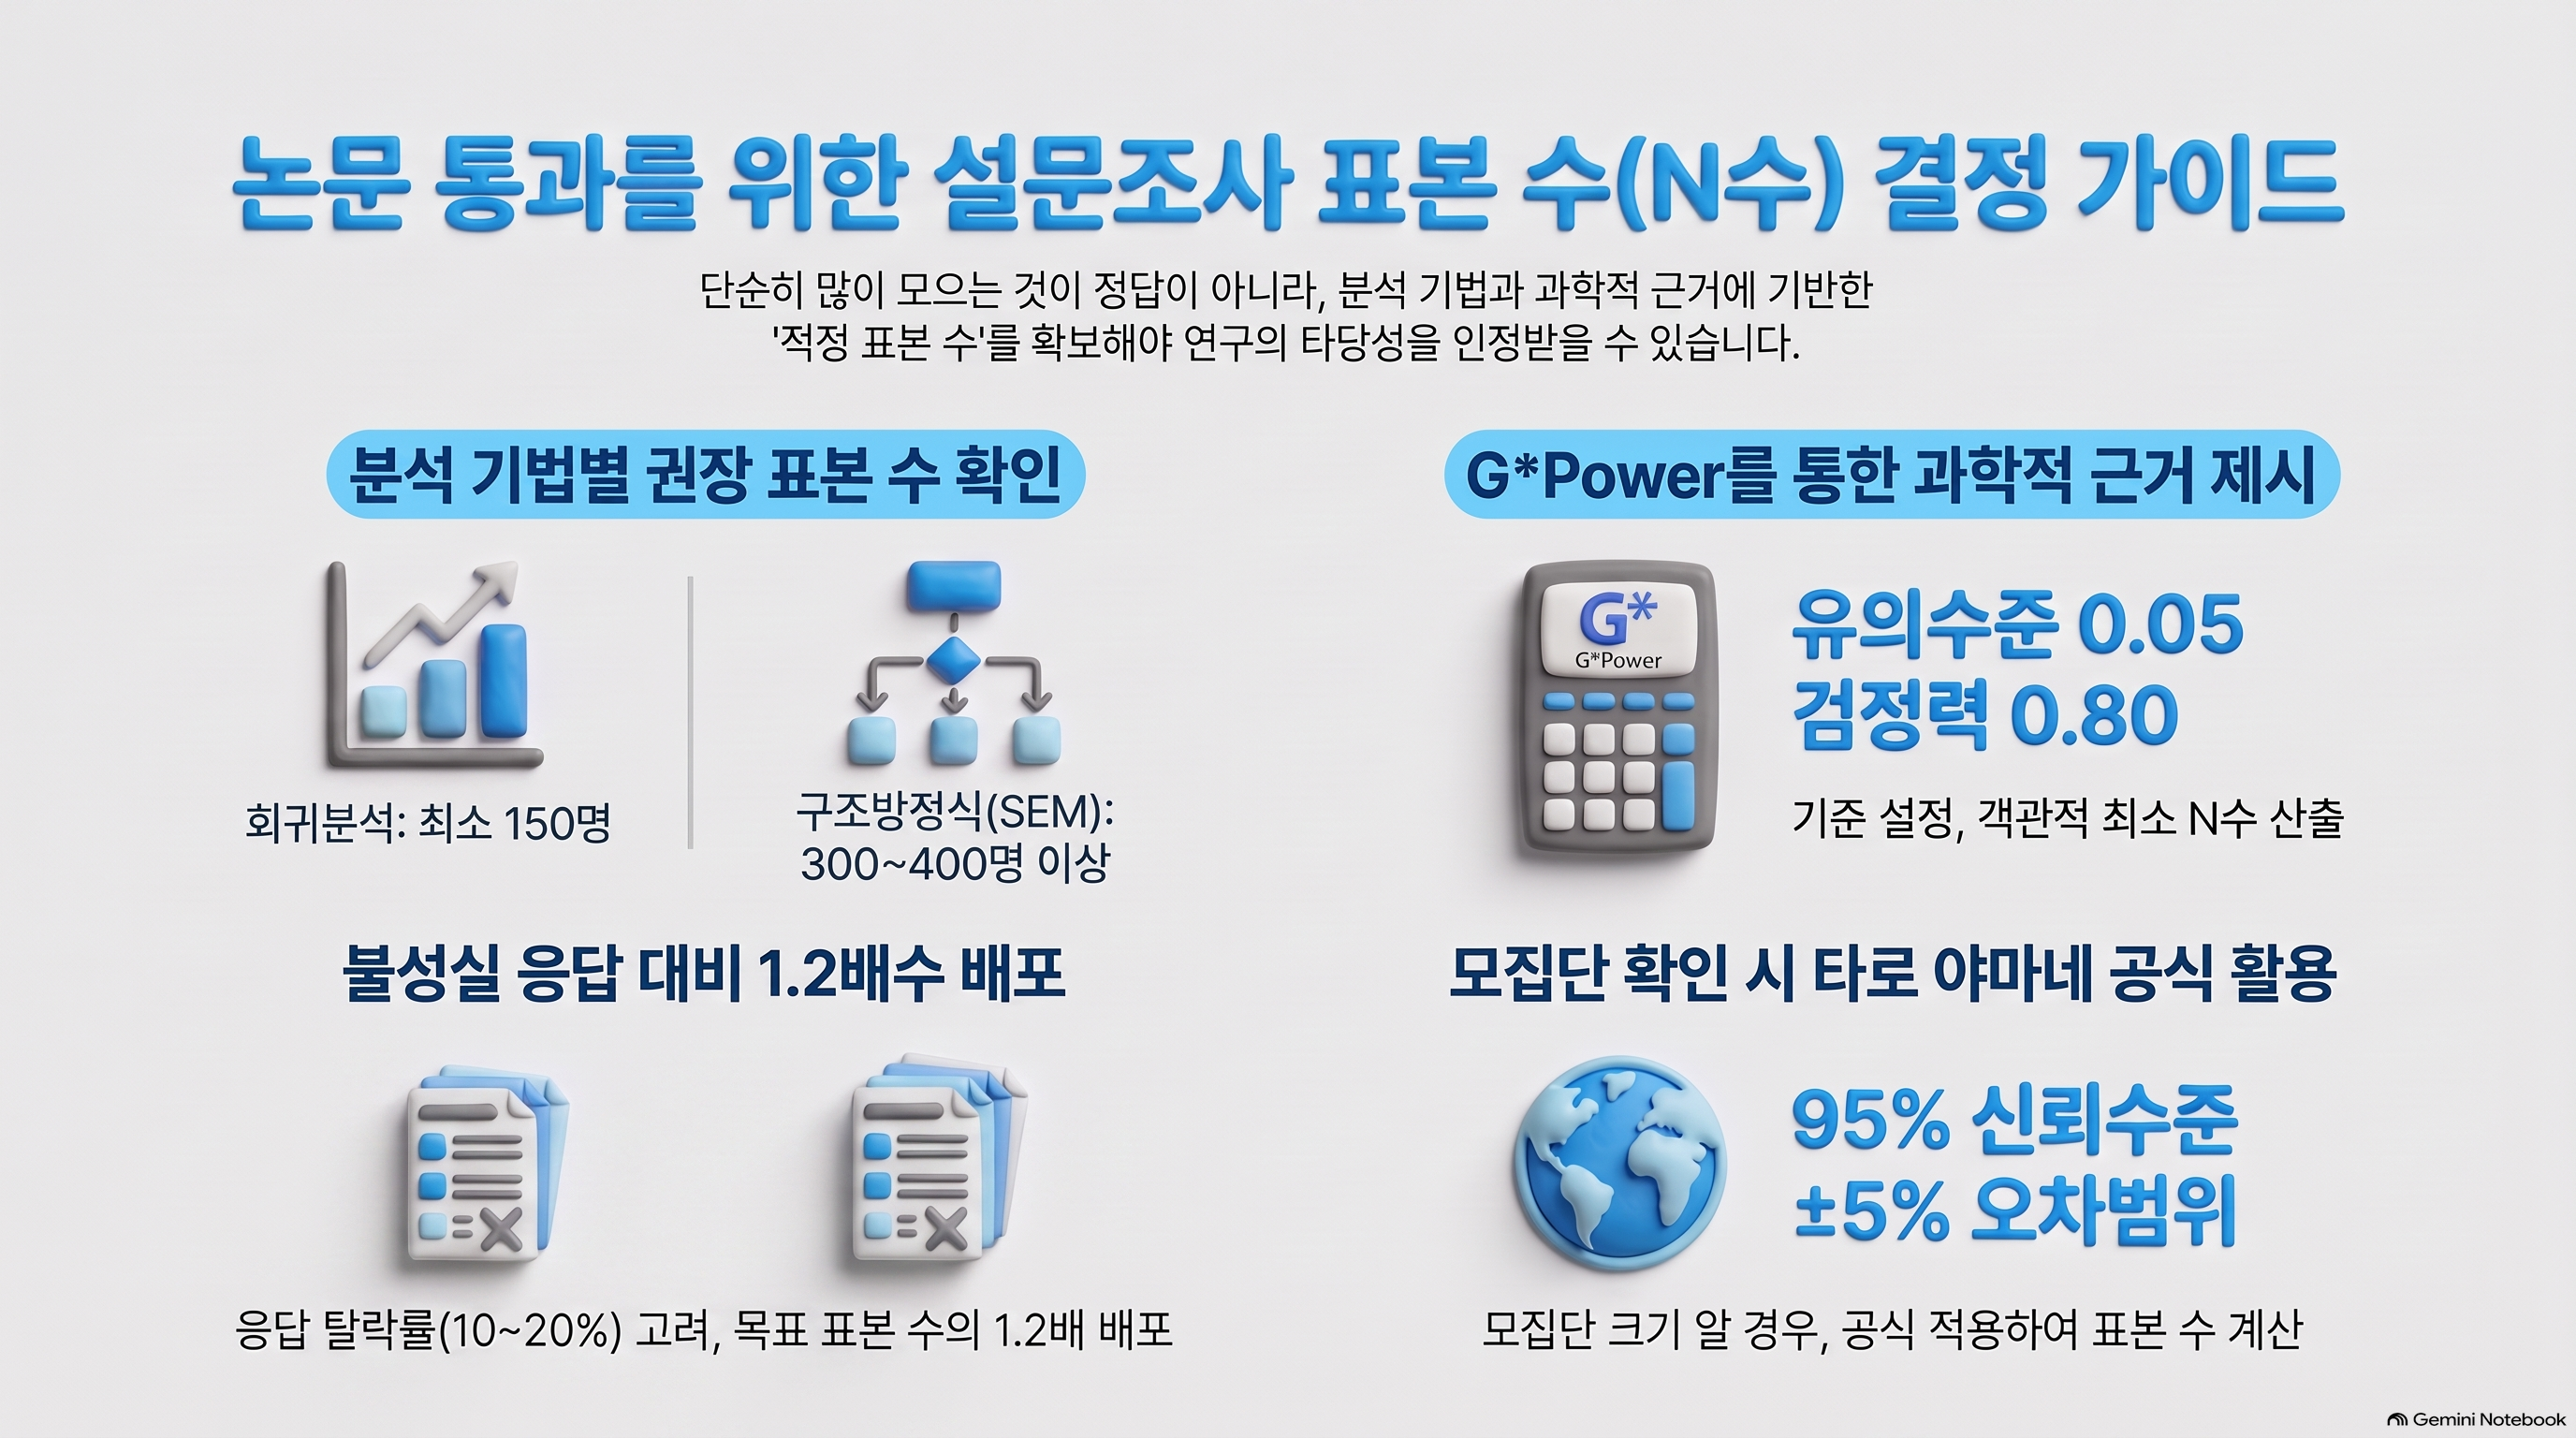
흔히 현장에서 회귀분석은 150명, 구조방정식모델(SEM, Structural Equation Modeling)은 300명 이상이어야 한다는 이야기를 들어보셨을 거다.

이러한 관례적인 기준은 통계적 추정 알고리즘이 안정적으로 수렴하기 위한 최소한의 경험 법칙(Rule of Thumb)에서 출발했다.


예를 들어 다중회귀분석(Multiple Regression Analysis)에서는 독립변수 1개당 최소 10~15개의 관측치가 필요하며, 탐색적 요인분석(EFA, Exploratory Factor Analysis)에서는 문항 수의 5~10배에 달하는 응답자가 확보되어야 요인 구조가 왜곡되지 않는다.

분석 모델의 변수 수가 많아질수록 요구되는 표본 크기는 비례해서 증가한다는 점을 꼭 기억해야 한다.

💡 알아두세요!
구조방정식(SEM) 분석 시 최대우도법(ML, Maximum Likelihood)을 사용할 경우 표본이 200명 미만이면 모델 적합도 지수가 지나치게 민감해지거나 공분산 행렬 오류가 발생하기 쉽다. 안정적인 경로계수 도출을 위해서는 최소 200~300명 이상을 목표로 잡는 것이 안전하다.


주요 분석 기법별 권장 표본 수 비교 📊

설문조사 설계를 시작할 때 내가 사용할 최종 통계 기법이 무엇인지 먼저 확정해야 한다.
분석 기법의 복잡도와 모수 추정 방식에 따라 필요한 데이터의 볼륨이 크게 달라지기 때문이다.

아래 표는 국내외 학술지 및 학위논문 심사에서 보편적으로 인정받는 분석 기법별 권장 표본 크기를 정리한 표이다.

주요 연구 분석 모형별 권장 표본 가이드

분석 기법 경험적 최소 기준 권장 표본 크기 주요 고려 요소
독립표본 t-검정 집단당 30명 (총 60명) 집단당 64명 이상 중간 효과크기(d=0.5), 정규성 충족
일원분산분석 (ANOVA) 집단당 20명 총 150~200명 내외 3개 이상 집단 간 분산 동질성
다중회귀분석 독립변수 수 × 10명 150명 ~ 200명 다중공선성 및 수정된 결정계수 안정성
구조방정식 (SEM) 최소 200명 300명 ~ 400명 이상 잠재변수 측정 문항 수, 적합도 지수
⚠️ 주의하세요!
설문 응답을 수집했다고 해서 전원 유효 표본이 되는 것은 아니다!
불성실 응답(중복 체크, 한 줄 밀려 쓰기, 결측치 다수 등)으로 약 10~20%가 탈락하므로, 계획 단계에서 목표 N수의 1.2배를 목표치로 설정해야 데이터 수집 실패를 방지할 수 있다.


G*Power를 활용한 사전 표본 수 산출법 🧮

학위논문이나 KCI 등재 학술지에 표본 산출 근거를 서술할 때 가장 신뢰받는 도구가 바로 독일 하인리히 하이네 대학교에서 개발한 G*Power(지파워) 프로그램이다.
통계적 검정력 분석(Power Analysis)을 통해 제1종 오류(α)와 제2종 오류(β)를 통제하는 과학적인 표본 크기를 계산해 준다.

📝 G*Power 다중회귀분석 기본 입력 표준 파라미터

검정력(Power) = 1 - β (표준 0.80 또는 엄격한 기준 0.95 적용)

가장 널리 활용되는 다중회귀분석(F tests -> Linear multiple regression: Fixed model, R² deviation from zero)의 설정 절차는 다음과 같다.

1) Test family: F tests 선택

2) Statistical test: Linear multiple regression: Fixed model, R² deviation from zero 선택

3) Type of power analysis: A priori: Compute required sample size 지정

4) 파라미터 입력: 효과크기(Effect size f²) = 0.15 (중간 크기), 유의수준(α err prob) = 0.05, 검정력(Power: 1-β err prob) = 0.80, 독립변수 수(Number of predictors) = 5개

→ Calculate 버튼 클릭: 최소 표본 수 N = 92명 도출 (탈락률 15% 감안 시 약 110부 배포 필요)

모집단 크기를 아는 경우: 타로 야마네 공식 👩‍💼👨‍💻

전체 고객이나 특정 조직의 임직원처럼 모집단 크기(N)가 유한하게 정해져 있는 경우에는 신뢰수준(Confidence Level)과 표본오차(Margin of Error)를 적용하는 '타로 야마네(Taro Yamane)' 공식이나 코크란(Cochran) 공식을 적용할 수 있다.


경영학 및 사회과학 연구에서 가장 널리 쓰이는 기준은 95% 신뢰수준에 허용오차 ±5%(0.05) 조건이다. 모집단 수가 수만 명에 달하더라도 허용오차 5% 기준을 충족하는 표본 수는 대략 380~400명 선에서 수렴하게 된다.

📌 알아두세요!
타로 야마네 산출 공식: n = N / (1 + N * e²) (여기서 n은 표본 수, N은 모집단 크기, e는 허용오차).
예를 들어 특정 기업 직원 1,000명을 대상으로 5% 오차범위를 적용하면 1000 / (1 + 1000 * 0.0025) = 약 286명의 응답이 요구된다.


실전 예시: 석사학위 논문 표본 설계 사례 📚

실제 연구 현장에서 연구자들이 심사보고서에 표본 산출 근거를 어떻게 명시하는지 실제 사례 구조를 통해 살펴보자.

김 연구원의 연구 조건

  • 연구 주제: 생성형 AI 도구 활용이 직무 몰입에 미치는 영향 분석
  • 통계 모형: 독립변수 3개, 매개변수 1개, 조절변수 1개를 포함한 다중회귀 및 조절효과 분석
  • 분석 소프트웨어: SPSS 및 PROCESS Macro 활용 예정

G*Power 산출 및 배포 계획

1) G*Power 3.1.9.7 적용: 유의수준 α=0.05, 검정력 1-β=0.85, 중간 효과크기 f²=0.15, 총 예측변수 5개 설정

2) 최소 필요 유효 표본 산출 결과: 102명 요구 확인

3) 온라인 설문 특성상 불성실 응답률(20%) 반영: 102 ÷ 0.8 = 총 128부 배포 결정

최종 수집 결과

- 총 수집 부수: 140부 수집 완료

- 유효 데이터: 불성실 응답 15부 제외 후 최종 125부 확보로 통계적 검정력 완벽 충족!

이렇게 연구계획서와 본문 조사설계 장에 G*Power 수치와 배포율 산출 근거를 텍스트와 캡처 화면으로 남겨두면, 심사위원의 표본 대표성 관련 지적을 원천 차단할 수 있다.


마무리: 핵심 내용 요약 📝

설문조사 표본 크기 결정은 단순한 감(Feeling)이 아니라 연구 타당도를 결정짓는 시작점이다.

목표로 하는 분석 모형에 맞추어 G*Power 프로그램을 통해 객관적 검정력을 먼저 계산하고, 회수 탈락률을 감안하여 배포 계획을 세우자! 😊

 
💡

표본 수(N수) 결정 핵심 요약

✨ 분석 기법 매칭: 회귀분석은 최소 150명, 구조방정식(SEM)은 300명 내외 권장
📊 G*Power 검증: 효과크기 0.15, 유의수준 0.05, 검정력 0.80 기준으로 사전 N수 산출 필수
🧮 유한모집단 표본공식:
n = N / (1 + N × e²) (오차범위 ±5%, 신뢰수준 95% 기준)
👩‍💻 배포 부수 여유분: 불성실 응답률 고려하여 목표 표본의 1.2배 이상 배포

자주 묻는 질문 ❓

Q: 표본 수가 무조건 크면 클수록 좋은 것 아닌가요?
A: 표본 수가 과도하게 커지면(예: 수천 명 이상) 극히 미세한 차이조차 유의한 결과(p < 0.05)로 나타나는 제1종 오류가 발생할 수 있습니다. 연구 모형에 적합한 적정 크기를 맞추는 것이 핵심입니다.
Q: 표본 수가 30명 미만이면 통계 분석을 아예 못 하나요?
A: 중심극한정리에 의해 모수 통계를 적용하기 어렵습니다. 만약 표본이 30명 미만이라면 정규성 검정을 거쳐 비모수 통계(Mann-Whitney U 검정, Wilcoxon 검정 등)를 적용해야 합니다.
Q: G*Power 효과크기(Effect size) 값은 무엇을 기준으로 정하나요?
A: 선행 연구의 R² 값이나 상관계수에서 추출하는 것이 정석입니다. 선행 데이터가 부족한 경우 코헨(Cohen)이 제안한 기본 표준값(작음 0.02, 중간 0.15, 큼 0.35) 중 중간 크기인 0.15를 표준으로 사용합니다.
Q: 온라인 서베이 폼(구글폼, 네이버폼) 응답률은 어느 정도 예상해야 하나요?
A: 지인 네트워크나 특정 커뮤니티 타깃 기준 30~50% 수준이며, 불성실 응답으로 인한 탈락률은 약 15~20%입니다. 따라서 목표 유효 N수가 200명이라면 최소 250건 이상의 응답을 수집해야 합니다.


Q: 모집단 전체가 150명밖에 안 되는 소규모 조직은 어떻게 하나요?
A: 표본추출 대신 전수조사를 기본 목표로 설정해야 합니다. 회수된 인원이 100명 미만일 경우 표본오차가 커지므로 연구의 한계점(Limitations) 섹션에 대표성의 제한점을 논리적으로 기술해야 합니다.

논문에 딱 맞는 통계는? 양적 연구 vs 질적 연구 방법론 선택 방법


내 논문과 보고서, 어떤 분석 기법을 써야 할까?
양적 연구와 질적 연구의 근본적인 차이부터 t-test, ANOVA, 회귀분석, 구조방정식, 그리고 심층 인터뷰까지 내 연구 문제와 데이터 형태에 딱 맞춘 연구방법론 선택 가이드를 명쾌하게 정리해 드립니다!


연구를 처음 설계하거나 학위논문, 프로젝트 보고서를 준비할 때 가장 먼저 맞닥뜨리는 거대한 벽이 바로 '방법론의 선택'이다.


"설문지를 돌려야 할까, 아니면 전문가 인터뷰를 해야 할까?"

"회귀분석을 돌려야 하나, 구조방정식을 써야 하나?"


밤새 고민하다가 결국 머릿속이 새하얗게 번아웃된 적 많으셨죠? 😊


저 역시 대학원과 현업 연구원들을 코칭하면서 수백 번 넘게 목격한 실수 중 하나가 바로 '남들이 많이 쓰니까 무작정 통계 툴부터 켜는 것'이었다.


하지만 분석 방법론은 결코 유행이나 멋으로 고르는 도구가 아니다.


여러분이 풀고자 하는 궁극적인 연구 질문(Research Question)과 여러분의 손에 쥐어진 데이터의 속성이 그 방향을 온전히 결정하는 법이다.


* 이미지 출처 : NotebookLM 내용 요약


1. 첫 번째 갈림길: 양적 연구 vs 질적 연구 🤔

연구 방법론을 결정할 때 가장 먼저 내려야 하는 결단은 숫자로 증명할 것인가(양적),

아니면 맥락과 언어로 탐색할 것인가(질적)를 가르는 일이다.


두 방법론은 우열의 관계가 아니라 탐구하는 목적 자체가 완전히 다른 영역이다.


양적 연구(Quantitative Research)는 주로

"A가 B에 미치는 영향이 유의미한가?"

"집단 간에 차이가 존재하는가?"

처럼 이미 존재하는 기존 이론을 바탕으로 가설을 검증하고 일반화하는 데 초점을 둔다.


반면 질적 연구(Qualitative Research)는

"이 현상은 왜 일어났을까?"

"당사자들은 어떤 경험과 의미를 형성하고 있는가?"

처럼 알려지지 않은 새로운 현상의 본질을 깊이 있게 파고들 때 탁월한 힘을 발휘한다.


💡 알아두세요!
선행 연구가 풍부하여 측정 도구(설문지 문항)가 이미 탄탄히 개발되어 있다면 양적 연구가 적합하다. 반대로 탐색할 연구가 거의 없거나, 특정 소수 집단의 내밀한 심리적 맥락을 파악해야 한다면 심층 인터뷰나 현장 관찰을 통한 질적 연구를 택하는 것이 연구의 타당도를 높이는 지름길이다.


2. 데이터 특성별 핵심 분석 기법 한눈에 비교 📊

방법론의 윤곽을 잡았다면, 이제 변수의 척도(명목, 서열, 등간, 비율)와 분석 목적에 맞추어 구체적인 분석 기법을 짝지어야 한다. 독립변수와 종속변수가 범주형인지 연속형인지 파악하는 것이 분석 선택의 90%를 결정짓는다.


주요 연구방법론 분류 및 데이터 요구조건 비교

분석 기법 주요 분석 목적 독립 / 종속 변수 형태 최소 권장 표본 수
독립표본 t-test 2개 집단 간 평균 차이 비교 범주형(2집단) / 연속형 집단당 30명 이상
일원배치 분산분석
(ANOVA)
3개 이상 집단 간 평균 차이 비교 범주형(3집단 이상) /
연속형
집단당 30명 이상
다중회귀분석
(Multiple Regression)
독립변수들의 종속변수 인과/
영향력 검증
연속형(더미변수 가능) /
연속형
독립변수 수의
15~20배 이상
구조방정식 모델(SEM) 잠재변수 간 복합 경로 및
매개·조절 동시 검증
다항목 리커트 척도 /
연속 잠재변수
최소 200~300명 이상
질적 연구
(인터뷰/근거이론)
경험의 의미 구조화 및 이론 도출 텍스트, 구술 녹취록,
관찰 일지
포화 상태 도달 시점 (10~25명)
⚠️ 주의하세요!
표본 수가 100명 미만인데 무리하게 복잡한 구조방정식(SEM) 모델을 구축하면 공분산 행렬 계산 오류가 발생하거나 연구의 적합도 지수가 기준치에 턱없이 미달하게 된다. 표본 크기가 제한적이라면 다중회귀분석이나 매개효과 검증을 위한 PROCESS 매크로로 접근하는 것이 훨씬 안전하다.


3. 표본 수와 분석 기법 판별 시뮬레이션 🧮

설문조사를 진행할 때 가장 많이 받는 질문이 "최소 몇 명에게 설문지를 받아야 논문 통계가 돌아가나요?"라는 점이다. 그린(Green, 1991)의 다중회귀 분석 표본 공식이나 구조방정식 기준을 숙지해 두면 표본 결측치를 고려한 완벽한 연구 설계가 가능해진다.

📝 다중회귀분석 최소 표본 수 산출 공식

전체 모형 적합도 검정 최소 표본(N) = 50 + (8 × 독립변수의 개수 k)

예를 들어 연구 모델에 포함된 독립변수가 총 5개인 경우의 최소 표본 수는 다음과 같이 계산된다.

1) 첫 번째 단계: 8 × 5(독립변수 수) = 40

2) 두 번째 단계: 기본 필요치 50 + 40 = 90

→ 회귀분석을 신뢰성 있게 돌리기 위한 순수 유효 표본은 최소 90명 이상이어야 하며, 불성실 응답률(20%)을 감안하면 최소 115부 이상을 수집해야 합니다.

4. 양적 연구와 질적 연구의 하이브리드: 혼합 연구방법 👩‍💼👨‍💻

최근 등재 학술지와 우수 석·박사 학위 논문에서는 통계의 객관성과 인터뷰의 깊이를 결합한 혼합 연구방법(Mixed Methods)이 큰 각광을 받고 있다.

수치만으로는 설명하기 힘든 이면의 원인을 밝혀낼 수 있기 때문이다.


대표적으로 두 가지 설계가 널리 쓰인다.

첫 번째는 '순차적 탐색 설계(Exploratory Sequential Design)'로, 질적 인터뷰를 먼저 진행해 새로운 요인을 발굴한 뒤 설문지를 제작해 대규모 양적 통계로 검증하는 방식이다.


두 번째는 '순차적 설명 설계(Explanatory Sequential Design)'로, 통계 분석 결과를 먼저 도출한 뒤 기이한 이상치나 통계로 설명되지 않는 부분을 후속 심층 인터뷰로 보완하는 방식이다.


📌 알아두세요!
혼합 연구를 설계할 때는 단순히 두 기법을 나열하는 데 그쳐서는 안 된다. "양적 데이터의 한계를 질적 데이터가 구체적으로 어떻게 메워주었는가"에 대한 통합적 고찰(Integration)이 반드시 논의 섹션에 서술되어야 심사위원들의 만장일치 통과를 이끌어낼 수 있다.


실전 예시: 김 연구원의 스마트워크 논문 방법론 탈바꿈 사례 📚

실제 연구 현장에서 잘못된 방법론으로 헤매다가 데이터 속성에 맞추어 설계를 수정한 현실적인 사례를 한번 살펴볼까요?

사례 연구자의 기존 상황

  • 연구 주제: IT 스타트업의 유연근무제가 조직 몰입 및 직무 성과에 미치는 영향
  • 수집 데이터: 스타트업 재직자 대상 유효 설문지 85부 (표본 크기 한계)
  • 당초 계획: 복잡한 7개 잠재요인 간 다중 매개 구조방정식 모델(SEM) 시도

발생한 문제와 문제 진단

1) 표본 85부로 AMOS 구조방정식을 실행하자 카이제곱(CMIN/DF) 값이 왜곡되고 CFI 0.81, RMSEA 0.12로 기준치 탈락 발생

2) 수집된 표본 크기는 회귀분석 공식 $N \ge 50 + 8 \times 3 = 74$를 충족하므로 회귀 기반 경로분석으로의 전환이 최적이라 판단

최종 전환 및 연구 결과

- 변경된 전략: SPSS PROCESS 매크로(Model 4)를 통한 매개효과 붓스트래핑(Bootstrapping) 검증으로 모형 간소화

- 보완책 추가: 통계에서 유의하지 않게 나온 하위 가설 1건을 규명하기 위해 인사 담당자 5명 대상 심층 인터뷰를 병행하여 논문의 학술적 질적 가치 대폭 향상 및 심사 완벽 통과

이처럼 내 손에 들어온 데이터의 크기와 형태를 냉정하게 인정하고,
그 한계를 극복할 수 있는 현실적인 통계 기법과 질적 인터뷰를 조합하면 위기 상황에서도 훨씬 매력적인 연구 성과물을 빚어낼 수 있다.


핵심 내용 요약 📝

연구방법론 선택은 단순히 기술적인 선택을 넘어 연구의 학술적 생명력을 결정짓는 뼈대와 같다.

설문지 배포 전이나 데이터 정제 단계에서 오늘 정리해 드린 기준을 차근차근 점검해 보자. 😊

 
💡

연구방법론 매칭 4대 핵심 요약

✨ 질문 중심 선택: 가설 검증과 일반화는 양적 연구, 심층적 동기와 새로운 개념 탐색은 질적 연구가 적합하다.
📊 변수 척도 점검: 독립·종속 변수가 범주형(집단)인지 연속형(점수)인지에 따라 t-test, ANOVA, 회귀분석이 분기된다.
🧮 표본 크기 고려:
회귀분석 최소 표본 N ≥ 50 + 8k | 구조방정식 N ≥ 200 이상 필수
👩‍💻 혼합 연구의 힘: 설문 통계의 한계를 인터뷰로 극복하는 혼합 연구방법으로 논문의 질을 극대화할 수 있다.

자주 묻는 질문 ❓

Q: 설문지 리커트 5점 척도는 서열척도인데 회귀분석이나 t-test에 써도 되나요?
A: 엄밀한 통계학적 분류상 서열척도이지만, 사회과학 및 경영학 연구 관례상 문항 간 등간성이 충족된다고 가정하고 다항목 합산 점수 혹은 평균치를 산출하여 연속형(등간·비율) 척도로 변환하여 t-test, ANOVA, 회귀분석에 널리 활용합니다. 단, 단일 문항일 때는 비모수 통계를 검토하는 것이 안전합니다.
Q: 회귀분석과 구조방정식(SEM) 중 어떤 것을 선택해야 하나요?
A: 분석 모형에 매개변수가 여러 개 얽혀 있거나 측정오차를 통제한 잠재변수 간 인과관계를 단 한 번의 분석으로 검증하고자 하며 표본이 200명 이상이라면 구조방정식을 선택합니다. 반면, 표본 수가 100명 안팎이거나 가설 구조가 직관적인 독립-종속 관계라면 회귀분석이 더 적합합니다.
Q: 질적 연구에서 심층 인터뷰 대상자는 몇 명이나 인터뷰해야 하나요?
A: 정해진 절대 숫자는 없으나, 새로운 인터뷰 대상자에게서 새로운 범주나 개념이 더 이상 도출되지 않는 '이론적 포화(Theoretical Saturation)' 상태에 도달할 때까지 진행합니다. 일반적인 학위 논문에서는 현상학적 연구는 5~10명, 근거이론은 15~25명 내외를 기준으로 삼습니다.
Q: t-test와 일원배치 분산분석(ANOVA)의 명확한 차이는 무엇인가요?
A: 집단의 수 차이입니다. 비교하고자 하는 독립변수의 집단이 성별(남/여)이나 실험군/대조군처럼 딱 2개일 때는 t-test를 사용하고, 연령대(20대/30대/40대 이상)나 직급(사원/대리/과장 이상)처럼 3개 이상의 집단 간 평균을 비교할 때는 ANOVA를 사용합니다.
Q: 데이터 정규성 검정에서 p값이 0.05 미만으로 나와 정규성을 만족하지 못하면 어떻게 하나요?
A: 모수 통계 대신 비모수 통계 기법을 적용해야 합니다. 독립표본 t-test 대신 맨-휘트니 U 검정(Mann-Whitney U test)을, ANOVA 대신 크루스칼-월리스 검정(Kruskal-Wallis test)을 수행하면 데이터 왜곡 없이 유의한 검정 결과를 얻을 수 있습니다.

지도교수 피드백 메일 작성법과 논문 심사(디펜스) 완벽 통과 전략


지도교수 피드백 요청 메일과 논문 심사(디펜스), 어떻게 준비해야 할까요?
회신율을 극대화하는 커뮤니케이션 템플릿부터 프로포절 통과 전략, 심사위원의 날카로운 질문 방어법까지 대학원생을 위한 실전 로드맵을 모두 정리해 드립니다.


대학원 과정에서 가장 숨이 턱 끝까지 차오르는 순간을 꼽으라면 단연 지도교수님께 초고를 보내는 순간과 최종 디펜스장 문을 열고 들어가는 순간일 거다.


저 역시 수많은 연구자분들과 논문 지도를 함께 고민하며 밤을 지새워보았기에 그 막막한 심정을 누구보다 잘 알고 있다.


빈 메일 화면 앞에서 커서만 깜빡이며 한참을 망설였던 기억, 누구나 한 번쯤 있으시죠? 😊


교수님과의 관계는 단순한 사제지간을 넘어 연구 프로젝트의 최고 의사결정권자와 실무자의 파트너십에 가깝다.

그렇기 때문에 커뮤니케이션에도 명확한 공식과 비즈니스적 접근이 필요하다. 


* 이미지 출처 : NotebookLM 내용 요약 생성


교수님을 움직이는 피드백 요청 메일의 정석 ✉️

교수님의 메일함은 매일 수십, 수백 통의 행정 및 연구 메일로 넘쳐난다.

단순히 "논문 초고 송부드립니다. 검토 부탁드립니다"라는 식의 막연한 메일은 확인 우선순위에서 밀려나기 십상이다.


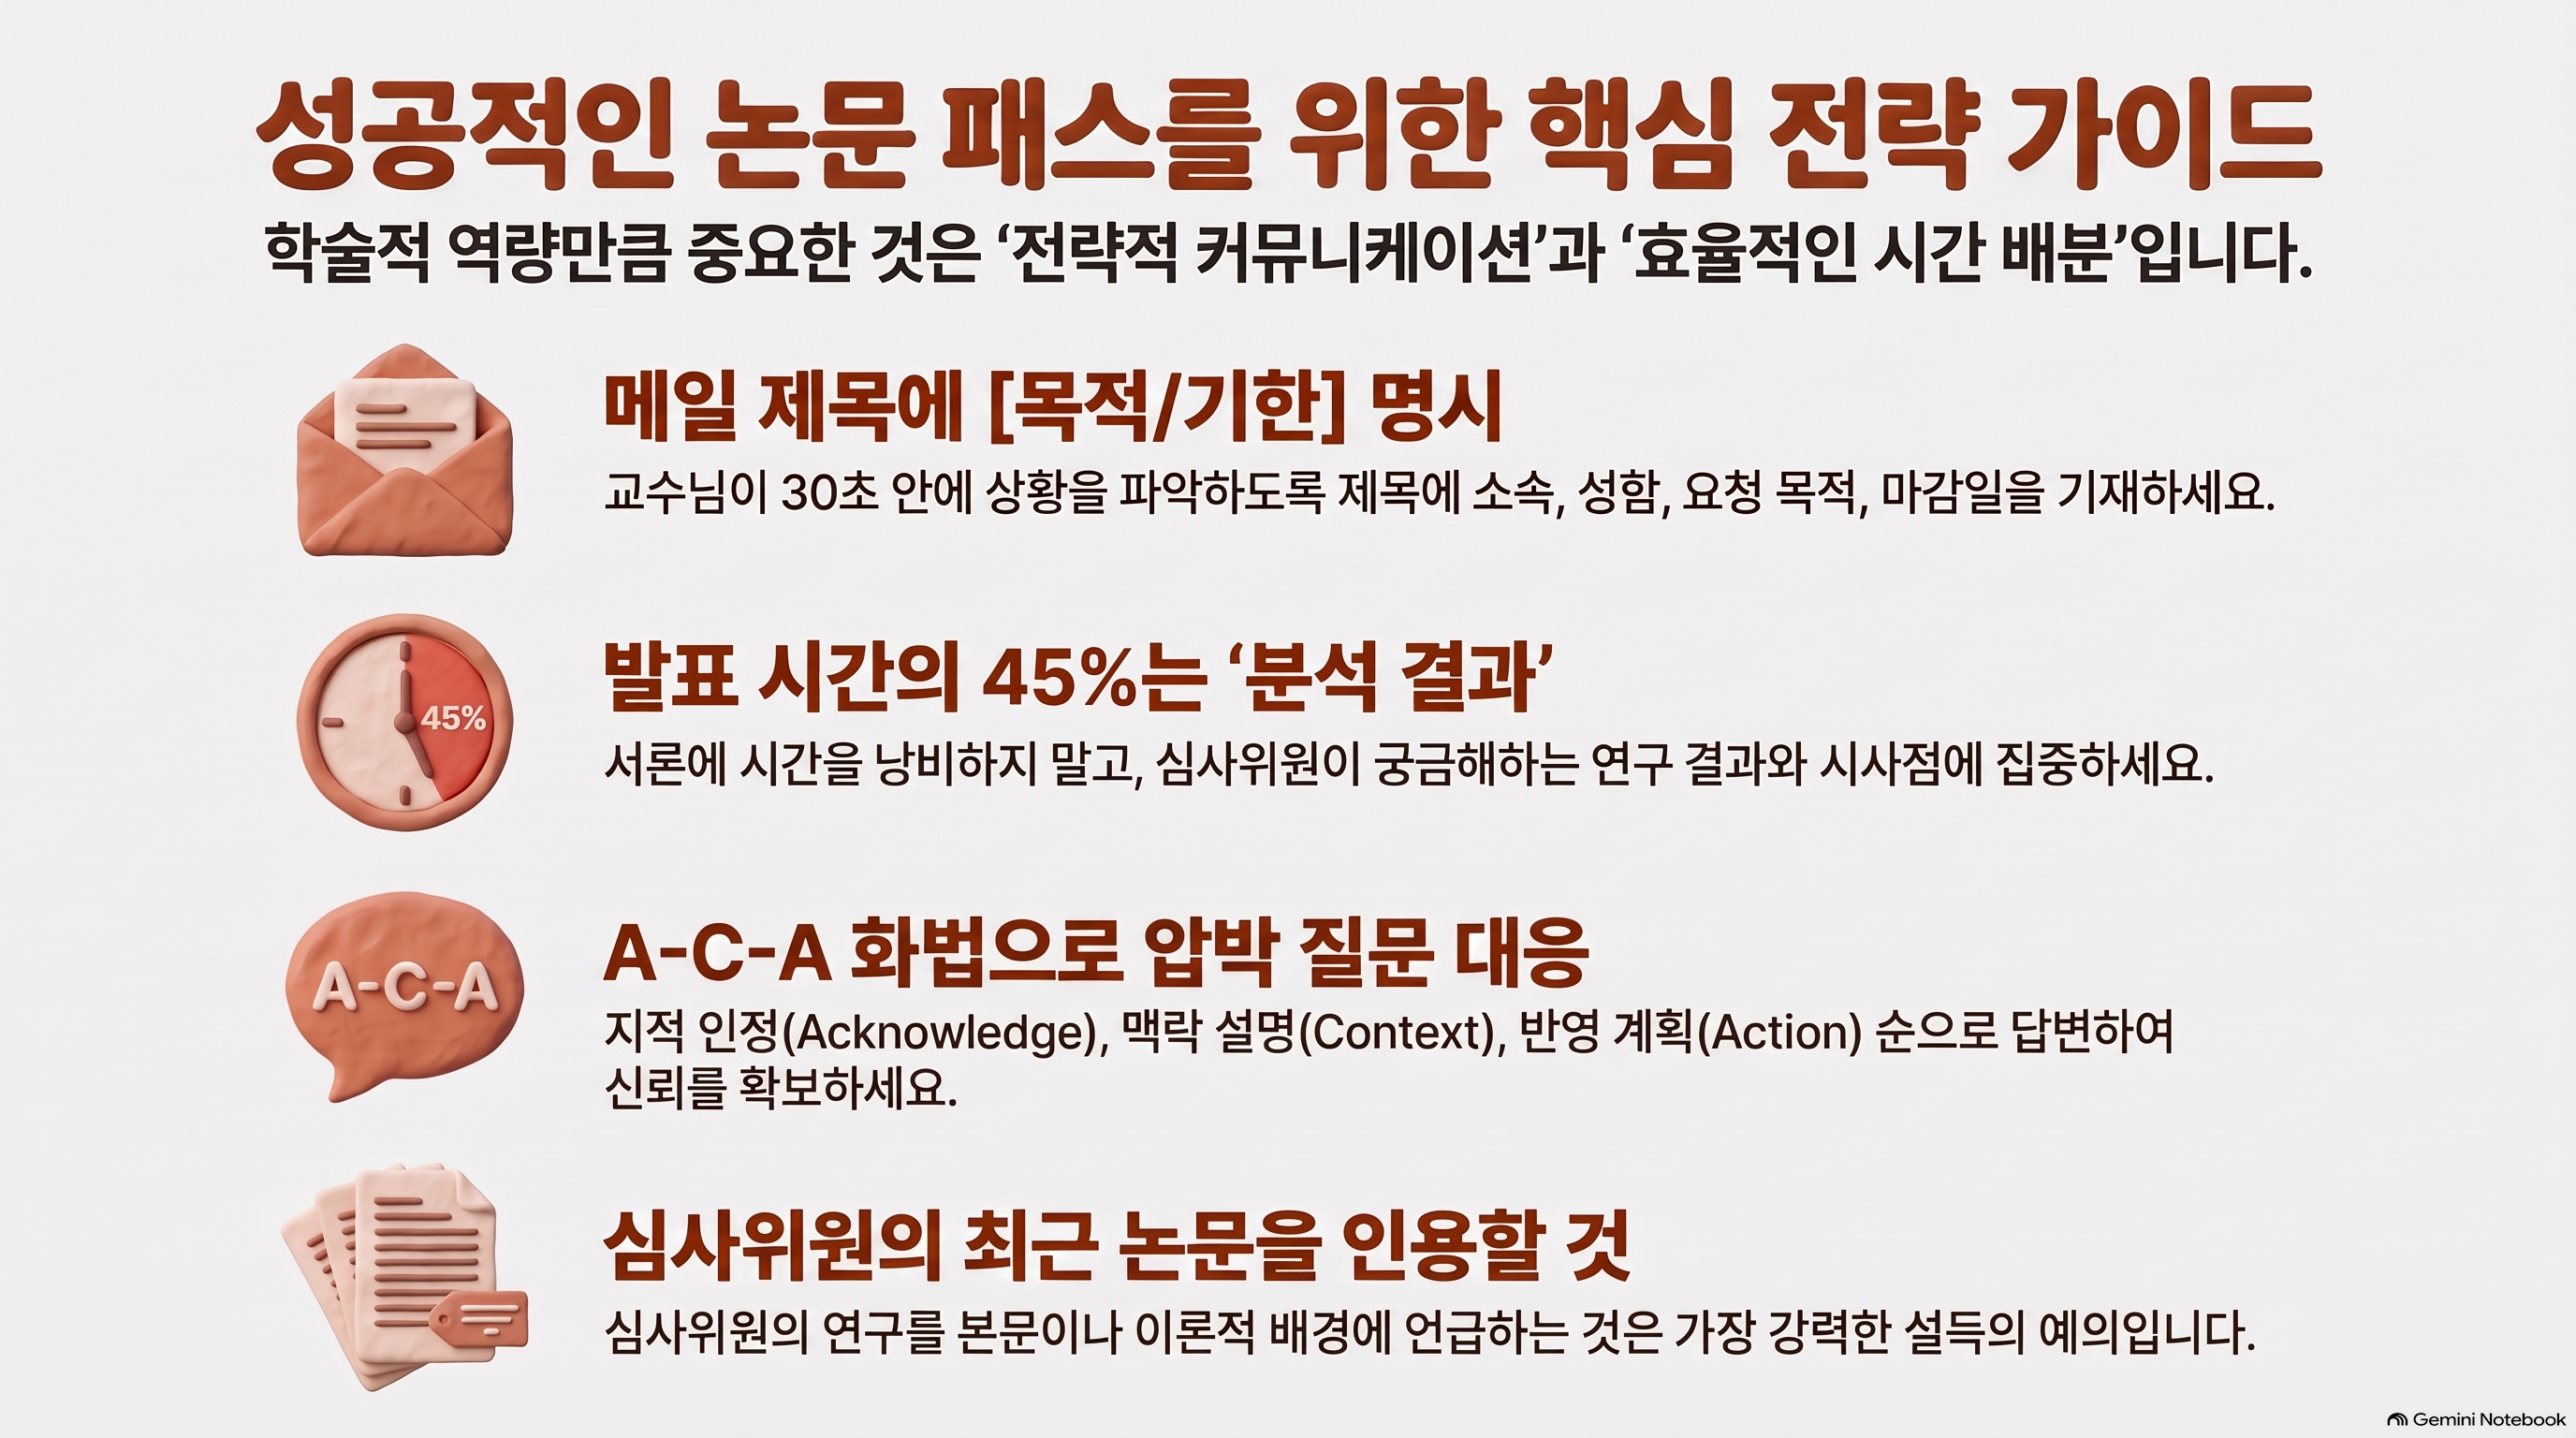
바쁜 교수님이 열어보자마자 30초 안에 상황을 파악하고 답변 방향을 결정할 수 있도록 구조화해야 한다.

핵심은 명확한 마감 기한 제시, 수정 사항의 구체적 명시, 양자택일형 질문이다. 검토할 분량이 어디인지, 이전 피드백을 어떻게 반영했는지 첫 화면에서 일목요연하게 전달하는 것이 핵심이다.

💡 알아두세요!
메일 제목에는 소속과 성함뿐만 아니라 [요청 목적 / 기한]을 대괄호 머리말로 기재하세요. 예컨대 [학위논문 피드백 요청] 석사과정 홍길동_3장 연구방법론 검토 요청 (10/15까지)와 같이 작성하면 열람 우선순위가 크게 올라갑니다.

📝 실전 메일 템플릿: 초고 검토 요청

제목: [석사/박사 학위논문 초고 검토 요청] 연구실 홍길동 (10월 20일 限)

본문:

존경하는 OOO 지도교수님 안녕하십니까, 연구실 석사과정 홍길동입니다.

환절기에 건강 유의하고 계신지 인사드립니다. 지난 미팅에서 조언해주신 선행연구 한계점 보완 사항을 반영하여 논문 2장 및 3장 수정본을 첨부와 같이 완성하였습니다.


[주요 수정 및 피드백 요청 요약]

  • 1. 선행연구 비교군 최신화 (p.15~18): 2024~2026년 최신 문헌 7편 추가
  • 2. 변수 조작적 정의 명확화 (p.24): 독립변수 측정 지표 보완
  • 3. 교수님 자문 필요 사항: 가설 2의 분석 모델 채택 여부 (옵션 A vs 옵션 B 중 타당성 검토)


학사 일정상 예비심사 서류 제출이 10월 25일까지입니다. 번거로우시겠지만 10월 20일(화)까지 피드백을 주실 수 있다면 일정에 맞춰 성실히 반영하겠습니다.

늘 아낌없는 가르침에 감사드립니다.
홍길동 올림


심사 단계별 평가 기준과 통과 전략 비교 📊

논문 심사는 크게 프로포절(연구계획서 심사), 중간 예비심사, 최종 본심사(디펜스)의 세 단계로 전개된다.

각 단계마다 심사위원들이 눈여겨보는 평가 축이 완전히 다르기 때문에 이를 미리 이해하고 대응 전략을 짜야 한다.


프로포절에서는 실현 가능성과 연구 질문의 타당성을 보며,

최종 본심사에서는 데이터 해석의 논리성과 학술적 기여도를 집중 검증한다.


심사 단계별 평가 중점 및 준비 포인트

심사 단계 핵심 평가 기준 주요 감점 요인 실전 합격 전략
프로포절
(연구계획)
연구의 필요성, 표본/데이터 수집 가능성, 연구 질문의 독창성 방대한 연구 범위, 방법론 구체성 결여 연구 범위를 타이트하게 좁히고 파일럿 테스트 결과 제시
예비 심사 데이터 신뢰성, 통계 분석의 적합성, 가설 검증 흐름 통계적 오류, 가설과 도구 간의 불일치 외부 심사위원 연구 분야 선행 인용 및 분석 코드 정리
본심사
(최종 디펜스)
학술적/실무적 시사점, 선행연구와의 차별성, 결론의 논리 과도한 결과 일반화, 형식/참고문헌 오류 연구의 한계점을 선제 고백하고 향후 연구 과제로 연결
⚠️ 주의하세요!
심사위원 배정 직후 해당 교수님들의 최근 3개년 출판 논문 및 주요 연구 주제를 반드시 검색하자! 내 논문 서론이나 이론적 배경에 심사위원의 논문을 정중히 인용해 두는 것은 심사위원의 호감도와 설득력을 높이는 가장 기본적이고 강력한 예의이다.


디펜스 발표 시간 배분 공식 및 준비 도구 🧮

많은 연구자들이 디펜스 발표에서 저지르는 가장 치명적인 실수는 서론과 선행연구 설명에 전체 시간의 절반 이상을 쏟아붓는 것이다.

심사위원들은 이론 강의를 들으러 온 것이 아니다.

본인 연구의 독창성과 분석 결과, 그리고 시사점에 가장 목말라 있다.

📝 학위논문 디펜스 골든 타임 배분 공식

이상적 발표 배분 = 서론 및 문제 제기(15%) + 연구 방법(20%) + 분석 결과(45%) + 시사점 및 한계점(20%)

예를 들어 20분의 발표 시간이 주어졌을 때의 최적 슬라이드 운용 전략은 다음과 같다.

1) 서론 및 연구 필요성: 3분 (슬라이드 2~3장)

2) 연구 모형 및 가설 설정: 4분 (슬라이드 3~4장)

3) 실증 분석 결과 및 가설 검증: 9분 (슬라이드 7~8장)

4) 결론, 학술적/실무적 제언, 연구 한계점: 4분 (슬라이드 3장)

→ 총 20분 기준 슬라이드는 표지 및 목차를 제외하고 약 16~18장 내외가 가장 안정적입니다.

심사위원 압박 질문 대처 및 멘탈 관리법 👩‍💼👨‍💻

디펜스장에서 날카로운 질문을 받았을 때 당황하여 즉답으로 변명을 늘어놓는 것은 가장 피해야 할 행동이다.

심사위원의 비판은 연구자를 무너뜨리기 위함이 아니라 논문의 완결성을 높여주기 위한 학술적 담금질에 가깝다.

📌 알아두세요!
3초 침묵과 수용 화법(A-C-A 화법)을 활용하세요:
1. Acknowledge (인정): "지적해주신 점 매우 타당하며 감사드립니다."
2. Clarify/Context (맥락 설명): "본 연구에서는 한정된 표본 특성상 A 방식으로 진행하였으나..."
3. Action (반영 계획): "최종 논문 수정본에서는 교수님께서 지적해주신 B 변수를 통제하여 보완하도록 하겠습니다."


실전 예시: 위기 탈출 실제 디펜스 사례 📚

실제 컨설팅 현장에서 자주 목격하는 표본 수 한계 및 분석 타당성 질문에 대한 모범 대응 사례를 살펴보자.

철저한 사전 대비가 있다면 어떤 돌발 질문도 유연하게 넘길 수 있다.

사례 주인공의 상황

  • 상황: 제조 중소기업 임직원 150명을 대상으로 한 데이터 분석 논문 심사
  • 심사위원 질문: "표본 수 150개로는 전체 제조기업을 대표하기에 일반화의 한계가 너무 크지 않은가요?"

모범 대응 단계

1) 첫 번째 단계: 감사 인사와 함께 질문의 핵심을 정중히 인정함

2) 두 번째 단계: G*Power 통계 검정력 분석을 통해 최소 표본 수 기준(N=119)을 충분히 충족했음을 객관적 수치로 증명

3) 세 번째 단계: 산업군 전체로의 일반화 한계를 논문 5장 한계점 항목에 솔직히 서술하였음을 언급하고 후속 연구 과제로 제시

최종 결과

- 통계적 엄밀성을 스스로 방어하는 동시에 심사위원의 지적을 겸허히 수용함

- 심사위원 만장일치로 '조건부 통과(수정 후 통과)' 판정을 획득함

이처럼 모르는 질문이 나오더라도 거짓으로 답하거나 우기지 않고,

객관적 기준을 제시하며 수용하는 자세를 보이면 심사위원단에게 신뢰를 줄 수 있다.


핵심 내용 요약 📝

논문 통과는 단순히 지식을 증명하는 자리가 아니라 동료 학자로서 검증을 받는 성인식과 같다.

조급함을 내려놓고 명확한 구조와 소통 방식으로 다가간다면 반드시 좋은 결실을 맺을 수 있다.

마지막까지 페이스 잃지 마시고 힘내시길 응원합니다! 😊

 
💡

논문 통과 핵심 치트키 요약

✉️ 소통의 기술: 메일 제목에 [용건/기한]을 명시하고 핵심 질문은 양자택일형으로 좁힌다.
🎯 단계별 공략: 프로포절은 실현 가능성, 디펜스는 데이터 해석 및 시사점에 집중한다.
⏱️ 발표 시간 황금비:
발표 비중 = 서론(15%) + 방법론(20%) + 결과 분석(45%) + 결론(20%)
🛡️ 위기 방어: 심사위원 질문에 반박 대신 A-C-A 화법(인정-설명-반영)으로 신뢰를 확보한다.

자주 묻는 질문 ❓

Q: 교수님이 메일을 확인하고 1주일 넘게 답장이 없으시면 어떻게 해야 하나요?
A: 최초 발송일로부터 5영업일(약 1주일)이 지난 시점에 보낸 메일 타래(Thread)에 이어서 정중한 리마인드 메일을 드리는 것이 좋습니다. "교수님, 지난주 보내드린 학위논문 초고 관련하여 혹시 보완할 부분이 있으신지 여쭙고자 연락드립니다" 형태로 일정을 다시 환기하세요.
Q: 디펜스 슬라이드는 총 몇 장 정도 만드는 것이 가장 적절한가요?
A: 20분 발표 기준으로 본문 슬라이드는 15~18장이 가장 안정적입니다. 1장에 약 1분에서 1분 15초 정도가 소요되기 때문입니다. 질문에 대비한 보조 자료는 'Appendix(부록)'로 슬라이드 뒤쪽에 10장 내외로 추가 배치하세요.
Q: 외부 심사위원 교수님들의 성향은 어떻게 파악하나요?
A: RISS나 구글 스칼라를 통해 해당 교수님이 최근 3년 내 교신저자나 제1저자로 게재한 논문들의 방법론과 연구 모델을 확인하세요. 정량 연구 위주인지 질적 연구 위주인지 확인하고 용어 사용 습관을 파악하는 것이 큰 도움이 됩니다.
Q: 심사위원이 전혀 예상치 못한 질문을 던졌을 때 모르면 어떻게 답변해야 하나요?
A: 절대 지어내거나 얼버무려선 안 됩니다. "미처 그 관점까지는 심도 있게 고려하지 못했습니다. 매우 중요한 통찰을 주셔서 감사드리며, 심사 종료 후 해당 문헌을 찾아 분석하여 최종본에 반드시 보완하도록 하겠습니다"라고 솔직하고 정중하게 인정하는 것이 최선입니다.
Q: 지도교수님과 외부 심사위원의 의견이 서로 갈릴 때는 어떻게 조율하나요?
A: 심사 현장에서 본인이 직접 한쪽 편을 들며 판단하려 하지 마세요. 두 의견 모두 메모한 뒤, 심사가 끝난 직후 지도교수님과 단독 면담을 잡고 "외부 교수님의 이런 지적에 대해 연구 방향을 어떻게 조율하는 것이 좋을지 교수님의 고견을 구합니다"라며 지도교수님께 결정권을 넘겨야 합니다.